そのClaudeBot、本物ですか?AIを名乗るbotが急増した2026年9月の観測レポート
2026年9月、AI観測ラボのサーバーログには、ClaudeBotを名乗るアクセスが1,100件以上記録されました。ところが、アクセス元のIPアドレスを1件ずつ確かめると、同じ「ClaudeBot」という名前でも、届いている経路は1つではありませんでした。
大部分は、サイトマップを確認してから記事を一気に取得する、普段どおりのClaudeBotでした。一方で、Anthropicの公式IPリストに載っているIPアドレスから、公開直後の新着記事だけを取りに来る、普段とは別系統のClaudeBotも4回観測しました。さらに、ClaudeBot・GPTBot・KimiBot・DeepSeekBotなど35種類以上のAIの名前を1回ごとに使い分けながら、パスワードや設定ファイルの置き場所を探るスキャナーも3回現れました。AIクローラーの名前が、正体を隠すための「名札」として使われるアクセスも確認できました。
また、OpenAIやAnthropicなど大手AI各社の公式クローラーとは別に、AIエージェントが使う検索インフラのクローラーも目立ちました。SofyaBot・AteveSearchSourceUrlDiscovery・ExaSearchBot・ShapBotなど、AIエージェント向けの検索・取得サービスが自社の検索基盤を作るために集めに来たアクセスは、9月だけで合計1,100件を超えています。
大手AIのクローラーは、8月までと同じリズムで動いていました。ClaudeBotは3か月連続でバーストを起こし、GPTBotは普段の静かな状態から一気に100件以上を取得する動きを3回繰り返しました。変わったのは、大手AIの動き方ではなく、大手AIのまわりに増えた新しい経路です。AI観測ラボでは、2026年9月を「名前だけではAIクローラーを見分けられなくなった月」として記録します。
この記事でわかること|📖:約6分
- 同じ「ClaudeBot」の名前で届いた、大量クロール・新着記事の単発取得・名前の偽装という3種類のアクセス
- 35種類以上のAI名を使い分けるスキャナーと、User-Agentだけで集計する危うさ
- SofyaBotやExaSearchBotなど、AIエージェントが使う「検索インフラ」のクローラーの増加
- ClaudeBotの3か月連続バーストとChatGPT-Userの半減など、大手AIクローラーの9月の動き
同じ「ClaudeBot」でも、届き方は3種類あった
ClaudeBotは、Anthropicが運営するクローラーです。サーバーログでは、User-Agent(アクセスしてきたプログラムが名乗る名前)に「ClaudeBot」と書かれたアクセスとして記録されます。
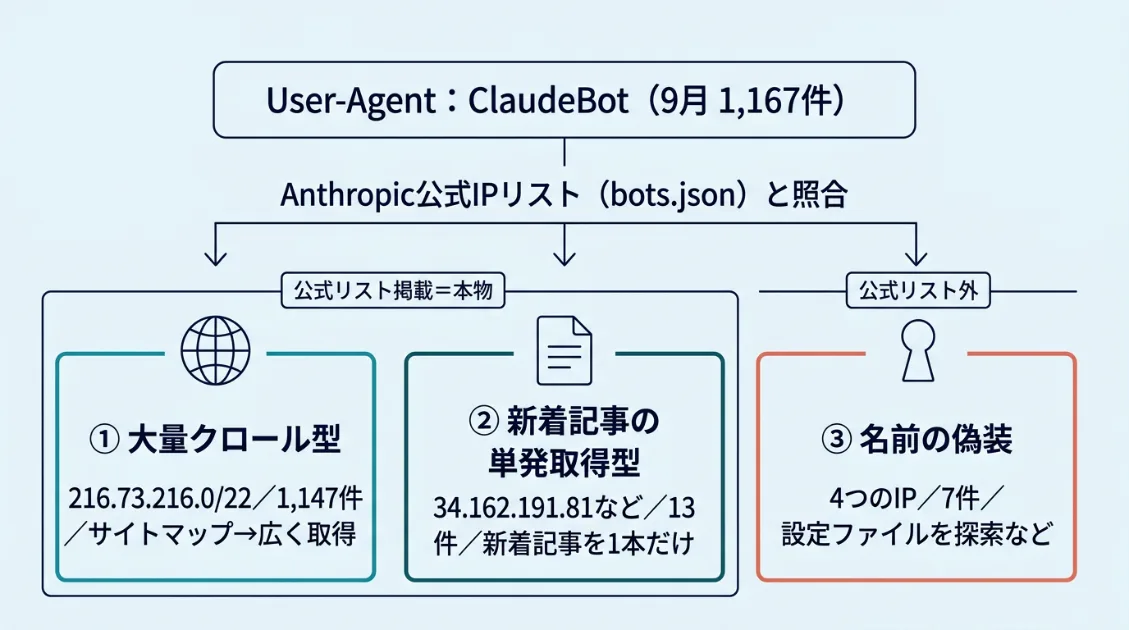
2026年9月1日から29日までのログで、ClaudeBotを名乗るアクセスは合計1,167件ありました。名前だけを数えれば「ClaudeBotが1,167回来た」で終わります。ところが、アクセス元のIPアドレスをAnthropicの公式リストと照合し、取り方ごとに分けてみると、動き方のまったく違う3種類のアクセスが見えてきました。
Anthropicは、自社のクローラーが使うIPアドレスを公式リスト(bots.json)として公開しています。リストに載っているIPアドレスからのアクセスであれば、Anthropicから届いたアクセスだと確認できます。
| 種類 | アクセス元のIPアドレス | 件数 | 動き方 |
|---|---|---|---|
| ① 大量クロール型 | 216.73.216.0/22(公式リスト掲載) | 1,147件 | サイトマップを確認し、記事やタグページを広く取得 |
| ② 新着記事の単発取得型 | 34.162.191.81など(公式リスト掲載) | 13件 | 公開したばかりの記事を1本だけ取得 |
| ③ 名前の偽装 | 公式リスト外の4つのIPアドレス | 7件 | 設定ファイルや管理画面の場所を探る、など |
1,167件のうち1,160件は公式リストに載ったIPアドレスからのアクセスで、Anthropicから届いた本物のClaudeBotでした。ですが、本物のClaudeBotの中にも、IPアドレスと動き方が異なる2つの型がありました。
① 大量クロール型:9月11日に3か月連続のバースト
件数の大部分を占めたのは、216.73.216.0/22から届く普段どおりのClaudeBotです。9月も、8月までと同じ「長く静かにしてから、一気に読みに来る」動き方をしていました。
| 日付 | ClaudeBotの動き |
|---|---|
| 8月31日〜9月7日 | 8月31日の午前を最後に、アクセスがゼロ |
| 9月8日〜10日 | 約2時間おきに、サイトマップだけを確認 |
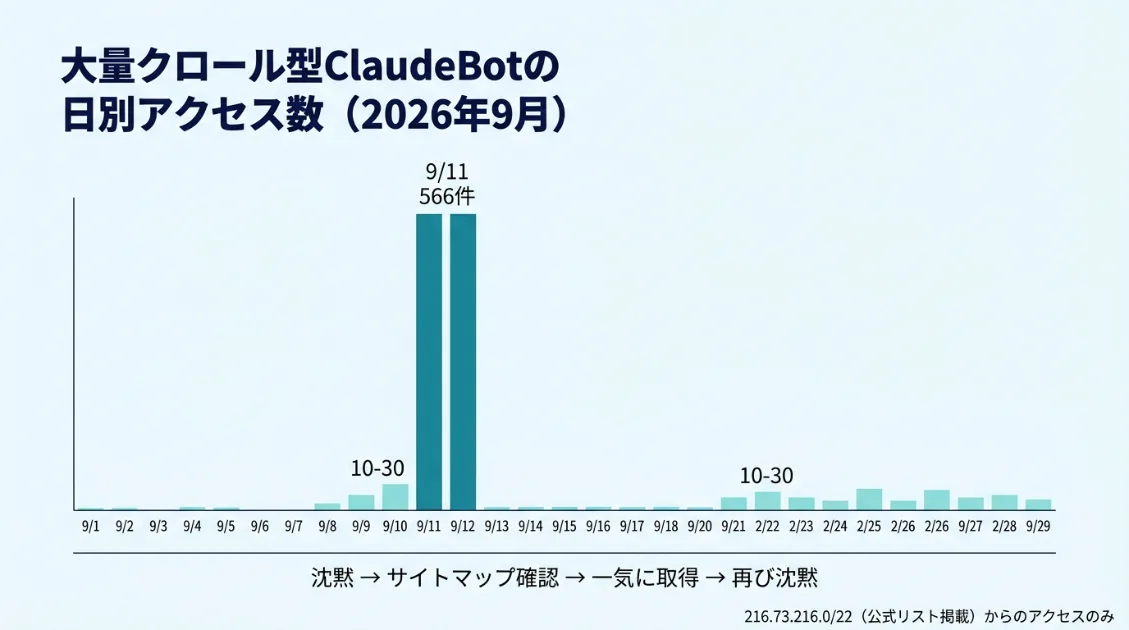
| 9月11日 | 14時2分〜57分の1時間弱で533件、432種類のURLを取得 |
| 9月12日〜20日 | 12日に13件。13日以降はほぼゼロ |
| 9月21日〜29日 | 毎日25件前後、ほぼすべてがサイトマップの確認。バーストは起きず |
9月11日のバーストでは、記事ページを276件、タグページを237件取得していました。特定の記事を狙ったのではなく、サイト全体を短時間で読み直すような動き。アクセス元のIPアドレスも、公式リストの範囲内で23個に分散していました。
8月のバーストは8月24日に62件、25日に66件と2日に分かれていましたが、9月は1時間に凝縮されています。8月24日から9月11日までの間隔は18日でした。「沈黙 → サイトマップの確認 → 一気に取得 → 再び沈黙」という流れは、7月末・8月・9月と3か月続けて観測できたことになります。
ただ、9月21日以降はサイトマップの確認が9日間続いたまま、月末までバーストは起きませんでした。9月上旬はサイトマップの確認が3日続いたあとにバーストが来ていたため、10月に入ってからの動きを引き続き観測します。
もうひとつ、ClaudeBotは9月を通して /sitemap.xml を何度も取りに来ており、毎回404(ページが見つからない)が返っていました。WordPressのYoast SEOでは、サイトマップの場所は /sitemap_index.xml です。/sitemap.xml を /sitemap_index.xml へ301転送しておけば、ClaudeBotに毎回404を返す状態は解消できます。転送によってクロール量が変わるかまでは、今回のログからはわかりません。
② 新着記事の単発取得型:公式IPから、公開直後の記事だけを取得
2つ目は、34.162.230.222と34.162.191.81から届いた13件です。9月中に4回、どれも公開したばかりの記事を1本だけ取得していました。
| 日時 | 取得した記事 | 公開からの経過 | リクエスト数 |
|---|---|---|---|
| 9月7日 15:15 | /ateve-search-crawler/ | 公開当日 | 5件 |
| 9月14日 15:04 | /sofyabot/ | 約11分後 | 2件 |
| 9月16日 11:53 | /why-my-site-not-in-ai/ | 約11分後 | 3件 |
| 9月29日 11:27 | /reflectionbot/ | 公開当日 | 3件 |
基本の取り方は、最初に /robots.txt を確認し、次にURLの末尾に「/」がない形でアクセスして転送(301)され、最後に正しいURLで記事を取得する3段階です。9月7日だけは /robots.txt と転送を2回ずつ繰り返して5件、9月14日は /robots.txt を読まずに2件で、4回の取得に伴って合計13件のリクエストが記録されました。
34.162.191.81 - - [16/Sep/2026:11:53:31 +0900] "GET /robots.txt HTTP/1.1" 200 994 "-" "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; ClaudeBot/1.0; +claudebot@anthropic.com)"
34.162.191.81 - - [16/Sep/2026:11:53:32 +0900] "GET /why-my-site-not-in-ai HTTP/1.1" 301 5 "-" "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; ClaudeBot/1.0; +claudebot@anthropic.com)"
34.162.191.81 - - [16/Sep/2026:11:53:33 +0900] "GET /why-my-site-not-in-ai/ HTTP/1.1" 200 21819 "-" "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; ClaudeBot/1.0; +claudebot@anthropic.com)"普段のClaudeBotとはIPアドレスも取り方も違うため、AI観測ラボでも最初は「ClaudeBotを名乗る偽物」と判断しかけました。ところが、Anthropicの公式リストと照合すると、2つのIPアドレスはどちらもリストに掲載されていました。偽物ではなく、Anthropicから届いたアクセスです。
さらに、同じ2つのIPアドレスは、9月中にClaude-Userとしても繰り返しアクセスしていました。取り方も、Claude-Userのアクセスと同じ3段階でした。Anthropicは、ClaudeBotをAIモデルの開発に使うWebコンテンツの収集用、Claude-Userを利用者の指示によるページ取得用として、用途を分けて説明しています。
公開から約11分後というタイミングと、末尾の「/」がないURLから取りに来ている点を合わせると、誰かがClaudeへ記事のURLを渡したときの取得だった可能性もあります。ただし、Claude-Userではなく「ClaudeBot」の名前で届いているため、利用者の指示による取得だったと断定することはできません。新着URLを見つける別の仕組みや、検索・インデックス系の処理という可能性も、ログだけでは切り分けられません。
確実に言えるのは、「Claude-Userとしても観測されたAnthropicの公式IPアドレスから、ClaudeBotという名前で新着記事だけを取得するアクセスがあった」ということです。本物のClaudeBotであっても、IPアドレスと動き方は1種類ではありませんでした。
③ 名前の偽装:公式リストにないIPアドレスからのClaudeBot
3つ目は、公式リストに載っていないIPアドレスからの7件です。うち6件は、9月21日〜24日に来たスキャナーの3つのIPアドレスからのアクセスでした。スキャナーは1回ごとに名乗る名前を入れ替えながら、ClaudeBotの名前も使っていました。取りに来たのは記事ではなく、設定ファイルや管理画面の場所です。スキャナーの手口は、次のセクションで詳しく紹介します。
残りの1件は判定保留です。9月12日に126.74.133.226からClaudeBotを名乗るアクセスがあり、トップページだけを取得していました。公式リストには載っておらず、User-Agentの書き方も普段のClaudeBotと違っていました。
| アクセス元 | User-Agentの書き方 |
|---|---|
| 本物のClaudeBot | Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; ClaudeBot/1.0; +claudebot@anthropic.com) |
| 9月12日の1件 | Mozilla/5.0 (compatible; ClaudeBot/1.0; +claudebot@anthropic.com) |
公式リスト外のIPアドレスから届いている以上、Anthropicのアクセスとは確認できません。1件だけで、スキャナーのような探索の動きもないため、正体までは判断せず記録にとどめます。(保留)
💡 自分のログでClaudeBotを見つけたときの確認ポイント
User-Agentに「ClaudeBot」と書かれていても、中身が同じとは限りません。次の4つを上から順に確認すると判断しやすくなります。
- ① 公式IPリストとの一致:アクセス元のIPアドレスが、Anthropicのbots.jsonに載っているか。真偽の判断はここが最優先です
- ② 取り方:サイトマップを確認してから広く読むのか、新着記事を1本だけ読むのか、
.envのような設定ファイルを探しているのか - ③ User-Agentの書き方:名前以外の部分まで、本物のアクセスと一致しているか
- ④ ネットワークの持ち主(ASN):補助材料として確認します。公式のクローラーでもGoogle CloudやMicrosoft Azureなどのクラウドを使っているため、ASNだけで真偽を決めることはできません
ChatGPT-Userを名乗る偽物を見つけたときの見分け方は、ChatGPT-Userを名乗る偽クローラーをログで発見した|本物との見分け方でも紹介しています。
AI・検索クローラー名を30種類以上使い分けるスキャナーが3回来た
9月下旬、AI観測ラボのサーバーログに、短時間で大量のアクセスを残して消えるスキャナーが3回現れました。スキャナーとは、Webサイトの弱点や、うっかり公開されているファイルを自動で探して回るプログラムです。
| 日時 | アクセス元のIPアドレス | 件数 | 所要時間 |
|---|---|---|---|
| 9月21日 23:05 | 34.67.70.128 | 148件 | 約1分 |
| 9月23日 10:15 | 35.230.88.51 | 240件 | 1分未満 |
| 9月24日 09:20 | 35.200.34.67 | 144件 | 1分未満 |
3回とも、1分前後で合計532件のアクセスを打ち込み、すぐに去っていきました。目立ったのは、件数よりもUser-Agentの使い方です。
1回ごとに名乗る名前を入れ替える
532件のうち437件は、AIクローラーや検索エンジンのクローラーの名前を名乗っていました。しかも同じ名前を使い続けるのではなく、1回のアクセスごとに名前を入れ替えています。名乗った名前は、確認できただけで32種類ありました。
| グループ | 名乗った名前の例 |
|---|---|
| 米国の大手AI・テック企業 | ChatGPT-User、GPTBot、OAI-SearchBot、ClaudeBot、Claude-User、Claude-SearchBot、Googlebot、Google-Extended、Applebot、Amazonbot、Meta-ExternalAgent |
| 中国のAI・テック企業 | KimiBot、Kimi-SearchBot、MoonshotBot、Qwenbot、DeepSeekBot、ChatGLM-Spider、PanguBot、YiBot、Hunyuan、Bytespider、Baiduspider |
| そのほかのAI・検索サービス | PerplexityBot、Perplexity-User、GrokBot、xAI-Grok、MistralAI-User、cohere-ai、YouBot、Bravebot、DuckAssistBot、CCBot |
残りの95件は、ごく普通のWindows版Chromeを名乗っていました。3つのIPアドレスは、どれも1回の来訪で28〜33種類のUser-Agentを使い分けています。
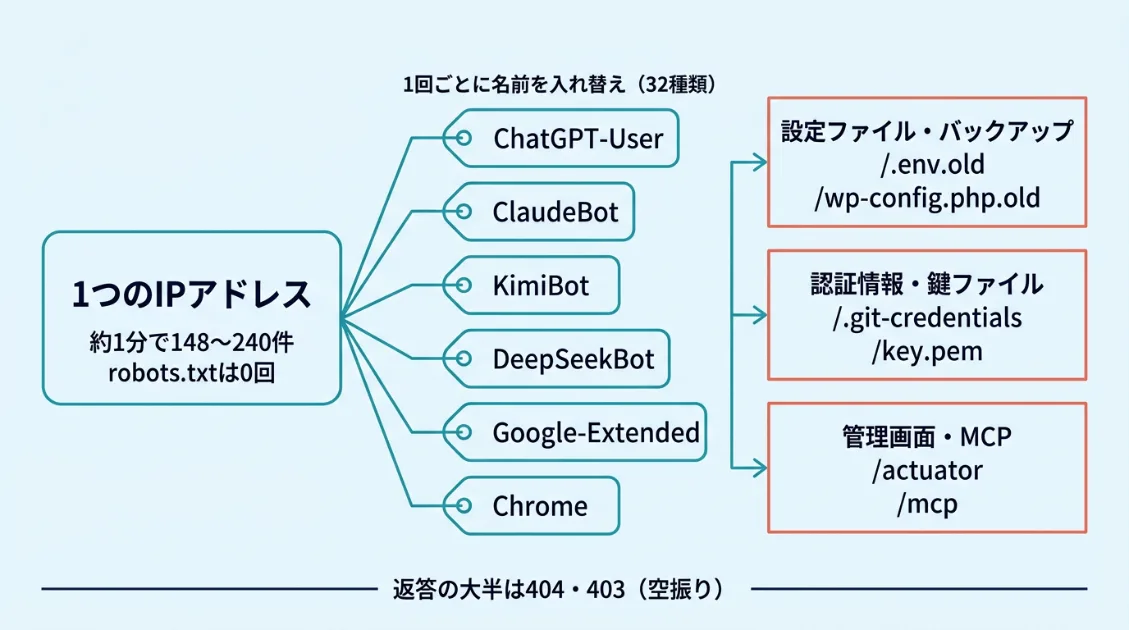
名乗った名前の中には、偽装だとすぐにわかるものも含まれていました。Google-Extendedは、robots.txtでGoogleのAI学習への利用を許可・拒否するための名前です。Googleは、Google-Extendedには独立したUser-Agentがないと説明しています。Google-Extendedを名乗るアクセスがログに出てきた時点で、本物ではないと判断できます。
詳しくはGoogle-Extendedはなぜアクセスログに出ないのかで解説しています。
もうひとつの特徴は、532件のアクセスの中で /robots.txt を1回も読んでいなかったことです。前のセクションで紹介した公式IPアドレスからのClaudeBotは、記事を取得する前に必ず /robots.txt を確認していました。サイト側のルールを確認するかどうかも、本物と偽物を見分ける手がかりになります。
狙っていたのは記事ではなく「鍵」
スキャナーが取りに来たURLを分類すると、記事を読みに来たアクセスではないことがはっきりします。
| 狙われた場所 | 件数 | URLの例 |
|---|---|---|
| 設定ファイル・バックアップ | 146件 | /settings.json、/values.yaml、/.env.old、/wp-config.php.old |
| 管理画面・API | 106件 | /actuator/loggers、/api/openapi.json、/server-status |
| 認証情報・鍵ファイル | 79件 | /.git-credentials、/service-account.json、/key.pem |
| WordPress関連 | 7件 | /wp-json など |
| MCP・認証関連 | 6件 | /mcp、/.well-known/jwks.json |
| 記事・トップページなど | 188件 | トップページ、公開中の記事 |
狙われたのは、パスワードやAPIキー(外部サービスを使うための合言葉)が書かれた設定ファイル、サーバーの管理画面、クラウドサービスに入るための鍵ファイルなどです。WordPressの設定ファイル wp-config.php の古いコピーを探すアクセスも含まれていました。
中でも、AIエージェントと外部ツールをつなぐ仕組みであるMCPのエンドポイント候補 /mcp まで探索対象に含まれていた点は気になります。今回は6件だけのため、「AIの普及に合わせてスキャナーの探索先が変化した」とまでは言えませんが、今後も継続して観測したい項目です。
AI観測ラボの返答は次のとおりで、大半は空振りでした。
| 返答 | 意味 | 件数 |
|---|---|---|
| 404 | ページが見つからない | 321件 |
| 301 | 別のURLへ転送 | 71件 |
| 403 | アクセス禁止 | 64件 |
| 200 | 成功 | 35件 |
| 503など | 一時的に応答できない、など | 41件 |
200(成功)を返した35件は、トップページや公開中の記事など、もともと誰でも見られるページだけです。ThinkPHPという別のシステムの弱点を突くURLも送られていましたが、WordPressでは通常の検索ページとして処理されていました。今回のログで確認できた範囲では、設定ファイルや鍵ファイルが外部に返された記録はありません。
名前だけで集計すると「中国系AIが一斉に来た」と読み違える
今回のスキャナーで特に注意したいのは、集計への影響です。KimiBot・Qwenbot・DeepSeekBot・GrokBot・PanguBotなどの名前は、9月のAI観測ラボのログでは、3つのスキャナーのIPアドレスからしか出てきませんでした。
User-Agentの名前だけで数えていたら、「9月下旬に中国系のAIクローラーが一斉に来始めた」と読み違えるところでした。ChatGPT-UserやGPTBotの件数にも、スキャナーの分が少しずつ混ざってしまいます。AI観測ラボの9月の集計では、3つのIPアドレスからのアクセスをすべて除外しています。
AI企業のクローラー名を偽装して認証情報を探すスキャンは、セキュリティ企業GreyNoiseも2026年8月28日に報告しています。GreyNoiseが観測した偽装アクセスも、.envやクラウドのアクセスキー、秘密鍵などを探索しており、各AI企業が公開する公式IPリストには一致しませんでした。User-Agentだけを見てAIクローラーを許可したり、制限を緩めたりする設定がある場合、名前の偽装が回避手段になる可能性があります。
GreyNoiseの結論も、「User-Agentを身元の証明として扱わず、公開されているIPリストと照合する」というものでした。前のセクションでClaudeBotを見分けたときと同じ考え方が、スキャナー対策でもそのまま当てはまります。
💡 AIクローラーの名前を名乗るスキャナーへの備え
- 公開フォルダに設定ファイルやバックアップを置かない:
.envや.git、wp-config.phpの古いコピーなどが残っていないかを確認します - 短時間に404を大量に出すアクセスを止める:セキュリティプラグインやWAF(Webサイト向けの防火壁)で、同じIPアドレスからの連続した失敗アクセスを制限します
- AIクローラーの許可は名前だけで判断しない:AIクローラーを特別に通す設定をしている場合は、User-Agentだけでなく、各社が公開しているIPアドレスのリストとも照合します
WordPressで最低限確認したい設定は、大型連休前に確認したいWordPressセキュリティ設定7項目にまとめています。
AIエージェントが使う「検索インフラ」のクローラーが増えた
ChatGPT-UserやClaude-Userは、ChatGPTやClaudeの利用者が質問したとき、AIサービス自身がページを取りに来るアクセスです。9月のログでは、別の種類のクローラーも目立ちました。AIエージェントや開発者に「Web検索」や「ページ取得」の機能を提供するサービスが、自社の検索基盤を作るためにWebページを集めに来るアクセスです。集められた情報は、APIなどを通じて、さまざまなAIエージェントから利用されます。
| クローラー | サービス | 9月の件数 | 9月の動き方 |
|---|---|---|---|
| AteveSearchSourceUrlDiscovery | AIエージェント向け検索API「Ateve」 | 208件 | 9月1日の6時31分〜44分に、1つのIPアドレスから182種類のURLを一気に取得 |
| SofyaBot | AIエージェント向けWeb検索・取得API「Sofya」 | 322件 | 9月10日深夜〜11日昼の約12時間で約150本の記事を取得。15日にも1本 |
| ExaSearchBot | AIエージェント向け検索API「Exa」 | 279件 | 270個のIPアドレスに分散し、月を通して少しずつ取得。9月24日だけ75件 |
| ShapBot | Parallel Web SystemsのWeb検索API | 313件 | 普段は数日おきに数件〜数十件。9月29日の11時台だけで136件 |
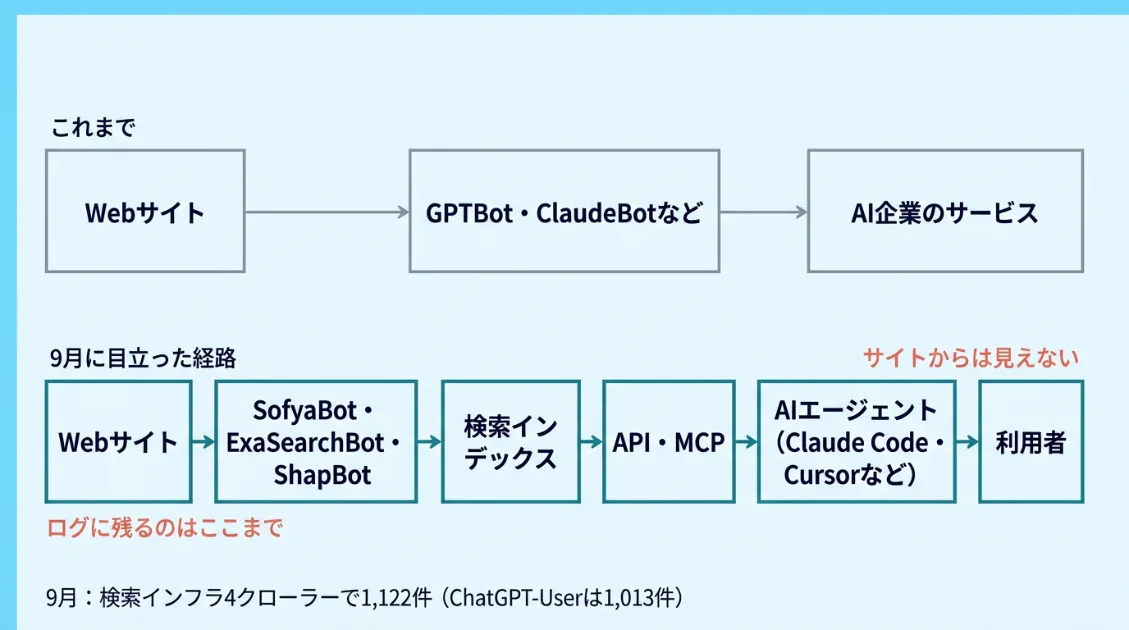
4つを合わせると、9月だけで1,122件になります。ChatGPT-Userの9月の件数は1,013件でした。AIサービス自身が取りに来るアクセスと同じくらいの量が、AIエージェント向けの検索インフラからも届いていたことになります。
また、件数は記事などのページへのアクセスだけを数えています。AteveSearchSourceUrlDiscoveryは、ページ以外のアクセス1件を含めると209件です。
AIに読まれる経路が多段になった
これまでは、Webサイトの情報がAIに届く経路は比較的シンプルでした。GPTBotやClaudeBotなど、AI企業のクローラーが直接サイトを読みに来て、集めた情報がAI企業のサービスで使われます。
9月に目立った経路は、1段多くなっています。
| 経路 | 流れ |
|---|---|
| これまでの経路 | Webサイト → GPTBot・ClaudeBotなど → AI企業のサービス |
| 9月に目立った経路 | Webサイト → SofyaBot・ExaSearchBot・ShapBotなど → 検索インデックス → API・MCP → AIエージェント → 利用者 |
SofyaBotを例にすると、Claude CodeやCursorなどのAIエージェントは、MCP(AIと外部ツールをつなぐ仕組み)などを通じてSofyaの検索機能を利用できます。その裏側では、SofyaBotがあらかじめWebを巡回し、Sofya独自の検索インデックスを構築しています。
サイト側から見えるのは、SofyaBotがインデックスを作りに来た記録だけです。集められた情報が、後からどのAIエージェントの検索結果として、誰の質問に使われたのかまではわかりません。しかもSofyaBotのアクセスは、GA4には1件も表示されませんでした。
これまで「AIに読まれているか」を確かめるときは、GPTBotやClaudeBotなど大手AIのクローラーを見ていれば、おおよその様子がつかめました。9月のログを見るかぎり、大手AIの名前だけを追っていると、AIエージェント向けに読まれている量の一部を見落とすことになります。
確かめ方は4つとも違う
同じ「AIエージェント向けの検索インフラ」でも、本物かどうかの確かめ方や、9月の取り方はばらばらでした。
| クローラー | IPアドレスの数 | robots.txtの取得記録 | 運営元が案内している確かめ方 |
|---|---|---|---|
| AteveSearchSourceUrlDiscovery | 1個 | 0回 | 確認できず |
| SofyaBot | 2個 | 2回 | 公開IPリストと逆引きDNS |
| ExaSearchBot | 270個 | 33回 | リクエストごとの暗号署名 |
| ShapBot | 9個 | 0回 | 公開IPリスト |
SofyaBotとShapBotは、運営元が公開しているIPアドレスのリストと照合できます。9月のログでは、SofyaBotの2つのIPアドレスも、ShapBotの9つのIPアドレスも、すべて公式リストに載っていました。
ExaSearchBotは、さらに一歩進んだ方法を採っています。すべてのリクエストに暗号の署名を付けているため、IPアドレスに関係なく、Exaから届いたアクセスかどうかを確かめられます。ただし、AI観測ラボのサーバーログには署名の情報が記録されていないため、今回は署名による確認まではできていません。User-Agentだけを信用しないという考え方は、クローラーを運営する側にも広がり始めています。
robots.txtの取得記録にも差がありました。AI観測ラボの9月のログでは、AteveSearchSourceUrlDiscoveryとShapBotによるrobots.txtの取得を確認できませんでした。ですが、取得記録がないことだけで、robots.txtを無視しているとは判断できません。以前に取得した内容を使っている可能性もあります。Parallelは、ShapBotをrobots.txtで制御できると公式に案内しています。
AteveSearchSourceUrlDiscoveryについては、Ateve自体がAIエージェント向けの検索APIであることは確認できたものの、クローラーとしての役割や確かめ方を説明する公式の案内は見つかりませんでした。User-Agentに書かれた連絡先も crawler@example.com という仮のアドレスのままです。example.comは説明用に予約されたドメインのため、連絡先としては機能しません。
エージェント基盤からの取得と、役割を確認できていないクローラー
9月には、検索インフラとは別の形のアクセスもありました。上の1,122件には含めていません。
- deepseek-harness:9月16日〜26日に合計9件。6つの異なるIPアドレスから、記事を1〜4本ずつ取得していました。DeepSeekは「DeepSeek Harness」というAIエージェント基盤を開発者向けプレビューとして公開しており、利用者が自分の環境で動かす仕組みです。毎回IPアドレスが違うことは、利用者がそれぞれの環境で動かしている形と矛盾しません。ただし、
deepseek-harnessというUser-Agentを公式のクローラーとして案内する資料は確認できなかったため、「DeepSeek関連を名乗るアクセス」として記録します - Reflectionbot:9月13日に初めて記録。1日数件から、月末には1日20〜30件まで増えました。63個のIPアドレスから合計190件
- KeenableBot:9月16日〜18日に集中し、合計289件。9月17日は1日を通して、1時間あたり2〜12件ずつ巡回していました。役割を説明する資料は、まだ確認できていません
💡 AIエージェント向け検索インフラのクローラーへの向き合い方
検索インフラのクローラーを止めると、検索インデックスに自分のサイトが入らず、インデックスを使うAIエージェントの検索結果にも出にくくなる可能性があります。AIエージェント経由で自分のサイトの情報を使ってもらいたい場合は、ブロックせずに観測を続けるのがおすすめです。
止めたい場合は、robots.txtでクローラーごとに指定できます。SofyaBot・ExaSearchBot・ShapBotは、どれも運営元がrobots.txtでの制御方法を案内しています。本物かどうかは、User-Agentだけでなく、各社が案内している公開IPリストや署名の仕組みで確かめます。robots.txtの書き方はrobots.txt完全ガイド【2026年版】で解説しています。
大手AI・検索クローラーは「いつものリズム」、ChatGPT-Userだけが半減した
新しいクローラーや名前の偽装が目立った9月ですが、大手AI・検索クローラーそのものは、8月までとよく似たリズムで動いていました。大きく変わったのは、ChatGPT-Userの件数です。
| クローラー | 9月の件数 | 9月の動き方 |
|---|---|---|
| bingbot | 1,232件 | 毎日30〜60件前後で安定 |
| ClaudeBot | 1,160件 | 9月11日の1日に566件が集中 |
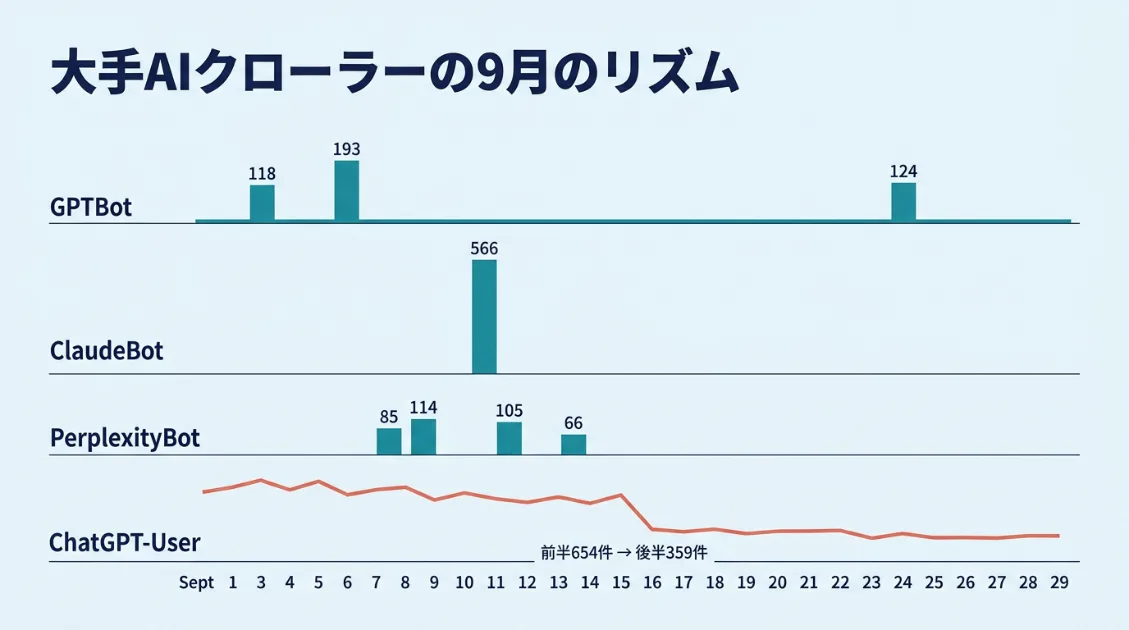
| ChatGPT-User | 1,013件 | 月の前半654件、後半359件と減少 |
| PerplexityBot | 543件 | 短い波があった4日間で370件 |
| Googlebot | 537件 | 毎日10〜30件前後で安定 |
| GPTBot | 517件 | 3日間のバーストで435件 |
件数は9月1日〜29日の記事などのページへのアクセスで、前のセクションで紹介したスキャナーの3つのIPアドレスからのアクセスは除いています。ClaudeBotは、Anthropicの公式IPリストに載ったIPアドレスからの件数で、大量クロール型1,147件と新着記事の単発取得型13件の合計です。
ChatGPT-User:8月の約半分に。減ったのは「上位2ページ以外」
ChatGPT-Userは、ChatGPTの利用者の操作をきっかけに、必要に応じてページを取りに来るアクセスです。8月は月間1,920件(1日平均約62件)で、AI観測ラボの観測史上最多の水準でした。9月は1,013件(1日平均約35件)で、ほぼ半分になりました。
| 期間 | ChatGPT-User |
|---|---|
| 9月1日〜7日 | 317件 |
| 9月8日〜14日 | 337件 |
| 9月15日〜21日 | 172件 |
| 9月22日〜29日 | 187件 |
月の前半と後半を比べると、減り方に偏りがありました。よく取得されていたトップページとOAI-SearchBotの解説記事の2ページは、前半253件・後半239件とほとんど変わっていません。減ったのは、上位2ページ以外へのアクセスです。
| 9月1日〜14日 | 9月15日〜29日 | |
|---|---|---|
| 上位2ページ | 253件 | 239件 |
| 上位2ページ以外 | 401件 | 120件 |
| 取得された記事の種類 | 80本 | 56本 |
要するに、9月後半の減少は「ChatGPTからまったく読まれなくなった」のではなく、これまで幅広く拾われていたロングテールの記事へのアクセスが細くなったことが起因してます。よく使われる2ページは、変わらず読まれ続けていました。
ただ1点、ChatGPT-Userは利用者の操作をきっかけに届くアクセスです。件数が減った理由が、OpenAI側の仕組みの変化なのか、AI観測ラボの記事が使われる場面そのものが減ったのかは、ログだけでは区別できません。8月の急増が一時的だった可能性もあります。OpenAIもChatGPT-UserのIPアドレスのリストを公開していますが、今回の集計ではスキャナーのIPアドレスを除外したのみで、公式リストとの照合はできていません。
GPTBot:普段は1日2〜3件、月に3回だけ100件超
GPTBotは、OpenAIがAIモデルの学習に使う可能性のあるページを集めるクローラーです。9月の517件のうち435件は、3日間のバーストに集中していました。
| 日付 | 件数 | 中身 |
|---|---|---|
| 9月3日 | 118件 | 12時台に116件。記事57件、タグページ54件 |
| 9月6日 | 193件 | 18時台に188件。うち151件がタグページ |
| 9月24日 | 124件 | 16時台に122件。記事60件、タグページ51件、カテゴリページ12件 |
バースト以外の日は、1日2〜3件ほどしか来ていません。ClaudeBotと同じく「普段は静かで、ときどき一気に読む」型ですが、ClaudeBotは9月のバーストが1回だったのに対し、GPTBotは3回でした。どちらもタグページを多く読んでいる点は共通しています。
PerplexityBot:月の前半に短い波が4回
PerplexityBotも、短時間に集中して読む動きを繰り返しました。9月7日・8日・11日・13日の4日間だけで、1日の合計は370件になります。
| 日付 | 1日の合計 | 集中した時間帯 |
|---|---|---|
| 9月7日 | 85件 | 12〜13時台に83件 |
| 9月8日 | 114件 | 15時台に104件 |
| 9月11日 | 105件 | 13時台に81件 |
| 9月13日 | 66件 | 0〜1時台に66件 |
9月14日以降は1日1〜17件ほどで、月の後半は静かでした。
9月11日は、AIクローラーが重なった日
9月11日は、複数のAIクローラーの動きが1日に重なりました。ClaudeBotが566件、SofyaBotが312件、PerplexityBotが105件、Amazonbotが85件で、4つだけで1,068件になります。
それぞれ別の会社が別の仕組みで動かしているため、現時点で4つの動きを結びつける証拠はありません。同じ日に複数のクローラーがまとまって動いた事実として記録しておきます。8月にも、Googleのスパムアップデート完了・ChatGPT-Userの急落・ClaudeBotのバーストが数日の間に重なっていました。
Gemini-Deep-Research:9月は0件
8月7日に初めて記録したGemini-Deep-Researchは、8月の1件以降、同じUser-Agentを9月には確認できませんでした。利用者が調査を実行したときに動く機能に関係するアクセスとみられるため、毎月安定して現れるタイプではない可能性があります。8月9月と記事の更新アップデート速度が遅くなったので調査対象から恥ずかしながら外された可能性が濃厚です。
💡 AIクローラーの件数は「1日」ではなく「月」と「中身」で見る
GPTBotやClaudeBotのように、普段は静かで、ときどき一気に読むクローラーは、1日だけを切り出すと「急増した」「来なくなった」と読み違えやすくなります。件数は週や月の単位で比べ、増えた日・減った日は、どのページへのアクセスが増減したのかまで確認すると、変化の正体が見えやすくなります。ChatGPT-Userのように、合計が半分になっても、よく読まれるページは変わっていないこともあります。
まとめ:9月は「名前だけではAIクローラーを見分けられなくなった月」だった
2026年9月のサーバーログには、新しい名前のクローラーが次々と現れました。対して、ClaudeBotを名乗るアクセスを公式IPリストと照合すると、Anthropicから届いたClaudeBotの中にも動き方の違う2つの型があり、名前を借りただけのスキャナーも混ざっていました。
User-Agentに書かれた名前を数えるだけでは、9月に起きたことの全体像は見えてきません。
- ✓ ClaudeBotを名乗るアクセス1,167件のうち、1,160件はAnthropicの公式IPリストに掲載されたIPアドレスから届いていた。その中にも、サイト全体を読む「大量クロール型」と、公開直後の記事だけを読む「新着記事の単発取得型」の2つがあった
- ✓ 大量クロール型のClaudeBotは、9月11日に1時間弱で533件を取得。7月末・8月に続き、3か月連続でバーストを観測した
- ✓ AI・検索クローラーの名前を32種類使い分けるスキャナーが3回来訪し、合計532件で設定ファイルや鍵ファイルの場所を探っていた。robots.txtは1回も読んでいなかった
- ✓ SofyaBot・ExaSearchBot・ShapBot・AteveSearchSourceUrlDiscoveryなど、AIエージェントが使う検索インフラのクローラーが合計1,122件。ChatGPT-Userの1か月分を上回った
- ✓ ChatGPT-Userは8月の1,920件から1,013件へほぼ半減。ただし上位2ページへのアクセスはほとんど変わらず、細くなったのはロングテールの記事へのアクセスだった
- ✓ GPTBotは月3回、PerplexityBotは4回の短いバーストを繰り返し、大手AI・検索クローラーの動き方そのものは8月までと大きく変わらなかった
このうち、AI観測ラボのサーバーログで直接確認できたのは、ClaudeBotの2つの型とバースト、スキャナーの532件、検索インフラのクローラーの件数と動き方、ChatGPT-Userの減少の中身です。Anthropic・Sofya・Parallelが公開するクローラーのIP情報や、Exaの署名による検証の仕組み、GreyNoiseによるスキャナーの報告など、ログの外側にある情報も、アクセス元の正体を判断する材料としてあわせて確認しました。
9月の観測を通じて、AI観測ラボのログの見方も変わりました。これまではUser-Agentの名前を起点にクローラーを追ってきましたが、今後は公式IPリストとの照合、取得のしかた、User-Agentの書式を合わせて確認し、ネットワークの持ち主(ASN)は補助材料として使います。
AIクローラーの名前そのものを信用できないアクセスが増え、AIにページが届くまでの経路も多段になっています。同じ名前でも中身が違い、別の名前でも同じ検索基盤につながっていることがあります。名前ではなく、「どこから来て、何をしたか」を見ることが、AIクローラー観測の前提になりつつあります。
10月に観測すること
- ClaudeBotのバーストは4か月目も来るか:9月21日以降、サイトマップの確認だけが続いたまま月を越えました。10月にバーストが起きるか、間隔がどう変わるかを追います
- ChatGPT-Userは戻るか:減少が続くのか、ロングテールの記事へのアクセスが戻るのかを、ページ単位で確認します
- 新着記事の単発取得型ClaudeBotは続くか:公開直後の記事だけを取りに来るアクセスが、10月の新着記事でも記録されるかを確認します
- 検索インフラのクローラーは増えるか:SofyaBot・ExaSearchBot・ShapBotの件数の推移と、新しい名前のクローラーが加わるかを観測します
- スキャナーの探し物は変わるか:AI・検索クローラーの名前を使うスキャナーが再び現れるか、
/mcpのようなAI関連のエンドポイント候補を探す動きが増えるかを記録します
9月に見つかった変化が一時的なものなのか、それとも新しい当たり前になっていくのか。引き続き、名前ではなくアクセスの中身を、サーバーログから追っていきます。
関連記事
- ClaudeBotとは—Anthropicの3つのボットと実測ログで見えた巡回の仕組み
- Claude-Userとは?サーバーログに残る「誰かがClaudeに聞いた」アクセスの正体
- ChatGPT-Userを名乗る偽クローラーをログで発見した|本物との見分け方
- SofyaBotとは?AIエージェント向け検索基盤を支えるWebクローラー
- ExaSearchBotとは?AIエージェント向け検索クローラーをアクセスログで初観測
- ShapBotとは?Gemini EnterpriseのWeb検索にも関係するAIクローラーの正体
- AIクローラー観測レポート 2026年8月|ClaudeBotのバーストと静かに変わるAI検索

AIクローラーを視覚化する
AI Kansoku Lab Tracker
GPTBot、ClaudeBot、PerplexityBotなど、WordPressサイトに訪問したAIクローラーを記録できる無料プラグインです。
あなたのサイトは、
AIに見えていますか?
URLを入力するだけで30秒。8項目を自動診断し、優先度別の改善プランを提示します。完全無料・登録不要。