SofyaBotとは?MCP経由でWebを取得するAIエージェント
2026年9月10日から11日にかけて、AI観測ラボのサーバーログに見慣れない名前が322件記録されました。
User-Agentに書かれていたのは「SofyaBot/1.0」。Google Analytics 4(GA4)のアクセス解析画面には何も映っていないにもかかわらず、サイト内のさまざまなページを巡回していたBotでした。
SofyaBotは、sofya.coが提供するMCPツールからWeb情報を取得する際に利用されるクローラーとみられます。本記事では、サーバーログで観測した実測データをもとに、SofyaBotの正体と仕組み、実際のアクセスパターンを整理します。
この記事でわかること|📖:約8分
- SofyaBotがどんなサービスのクローラーで、なぜWebサイトに来るのか
- MCPツール経由でWebを取得する仕組みと、GA4に映らない理由
- 2026年9月に記録した322件の実測ログとアクセスパターン
- サイト運営者としてSofyaBotへの対応が必要かどうかの判断基準
SofyaBotとは何か
SofyaBotは、sofya.coのWeb取得機能に関連して動作するクローラーです。Sofyaは、AIエージェント向けにWeb検索・ページ取得・情報抽出・リサーチ機能を提供するWebデータサービスで、APIのほかMCP経由でも利用できます。
MCPとは「Model Context Protocol」の略で、AIが外部のツールやデータと連携するための共通ルールです。Sofyaでは、Claude CodeやCursor、CodexなどのAIエージェントからMCPを通じてWeb検索やページ取得などの機能を呼び出せます。
AIエージェント向けMCPサーバーを掲載する「Glama.ai」にも、SofyaのMCPサーバー「sofya-mcp」が登録されており、Web検索・URL取得・情報抽出・複数ソースを使ったリサーチをAIエージェントから実行できるツールとして紹介されています。
今回AI観測ラボで確認した「SofyaBot/1.0」は、こうしたSofyaのWeb取得処理に関連してサイトへアクセスしているクローラーと考えられます。つまり、AIエージェントがSofyaを使ってWeb上の情報を調べる際、その裏側でページを取得する実行役のひとつとみることができます。
MCPの仕組みそのものについては、WebMCPとは何か——AIがWebサイトを操作する仕組みと運営者の準備で詳しく解説しています。
SofyaBotはどんな仕組みでWebを取りに来るのか
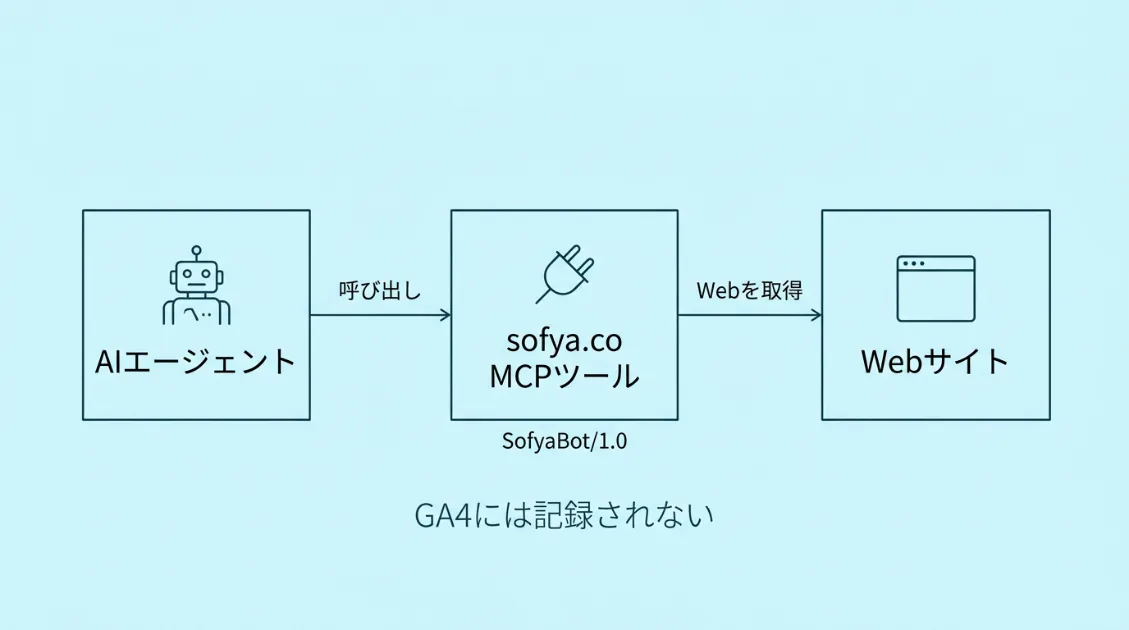
Sofyaは、AIエージェントからWeb検索やページ取得、情報抽出、リサーチを実行できるサービスです。MCP経由で利用した場合、公開されているサービスの仕組みと今回の実測ログから考えると、Webサイトへのアクセスはおおむね次のような流れで発生すると考えられます。
- AIエージェントがSofyaのツールを呼び出す
ユーザーがAIにWeb上の情報を調べるよう指示すると、AIエージェントがMCPなどを通じてSofyaの検索・取得機能を呼び出します。 - Sofya側から対象のWebサイトへアクセスする
Sofyaが必要なWebページを取得する過程で、対象サイトへHTTPリクエストが送られます。AI観測ラボのサーバーログでは、このアクセスのUser-Agentとして「SofyaBot/1.0」が記録されました。 - 取得した情報がAIエージェントで利用される
Sofyaは取得したWebページを処理し、その結果を呼び出し元へ返します。AIエージェントは返された情報をもとに回答や調査結果を生成します。
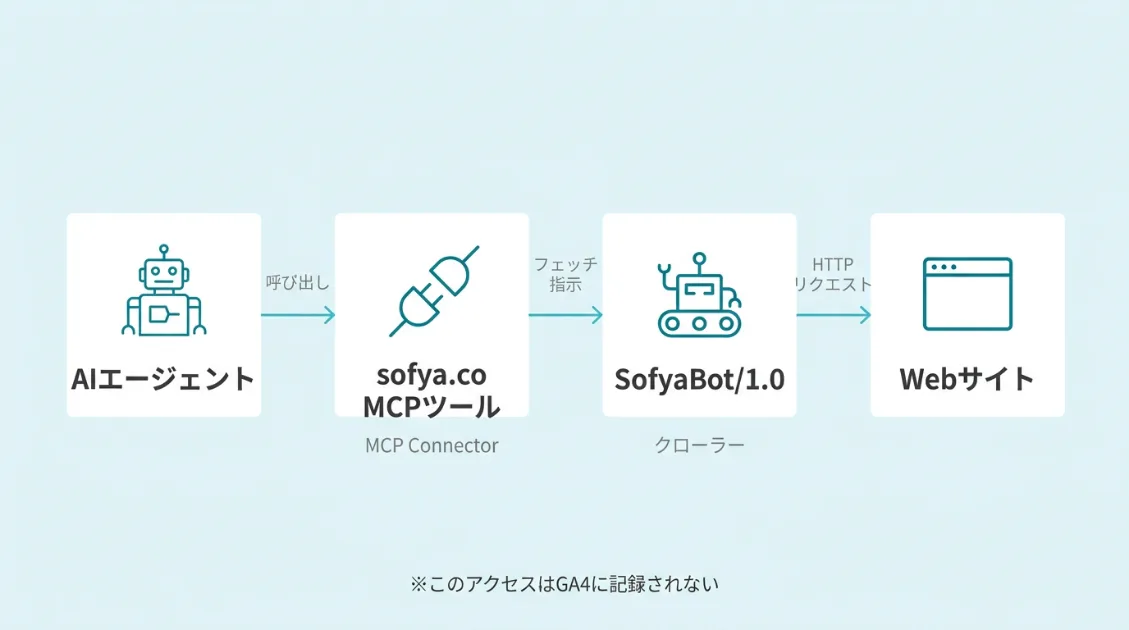
ここで重要なのは、Webサイトへアクセスしているのが通常のブラウザを使う人間ではないという点です。GA4は通常、ページ内のJavaScriptがブラウザ上で実行されることでアクセスを計測します。
SofyaBotのようにサーバーへ直接HTTPリクエストを送ってページを取得するBotでは、そのJavaScriptが実行されなければGA4には記録されません。
AI観測ラボで記録した実測ログ
2026年9月10日から11日にかけて、AI観測ラボのサーバーログにSofyaBot/1.0のアクセスが記録されました。
基本データ
| 項目 | 内容 |
|---|---|
| User-Agent | SofyaBot/1.0 (+https://sofya.co/bot) |
| 総アクセス数 | 322件 |
| 日付内訳 | 9月10日:9件 / 9月11日:313件 |
| IPアドレス | 159.195.250.248(単一IP) |
| アクセス時間帯 | 23時〜翌04時(深夜〜早朝に集中) |
| ユニークURL数 | 52件(robots.txt含む) |
322件のリクエストに対して、確認できたユニークURLは52件でした。単純計算では1URLあたり約6.2回のアクセスとなり、同じURLへの複数回アクセスも発生しています。各ページを1度ずつ取得するだけの単純な巡回ではないことがわかります。
巡回の流れ
SofyaBotは、最初に/robots.txtを取得したあと、記事ページやabout・contactなどのサイト情報ページへアクセスしていました。その後もAIクローラー関連の記事を中心に複数のページを巡回しており、特定の記事だけを単発で取得するのではなく、サイト内を広く探索している様子が確認できます。
実際のログでは、最初のアクセスは次のような順番でした。
/robots.txt/perplexity-crawler-guide//about//contact/
robots.txtを最初に確認している点は一般的なクローラーに近い一方、その後はサイト情報ページだけを順番に確認するのではなく、記事ページも交えながら巡回しています。
訪問したページ一覧(200レスポンス)
SofyaBotが取得した52件のURLを見る
- /robots.txt
- /about/
- /contact/
- /プライバシーポリシー/
- /operator-info/
- /articles/
- /meta-externalagent/
- /bytespider-crawler-guide/
- /oai-searchbot-guide/
- /gptbot/
- /gptbot-crawl-log/
- /gptbot-sitemap-behavior/
- /bingbot-copilot-crawler/
- /perplexity-crawler-guide/
- /claudebot-behavior-log/
- /claude-user/
- /amazonbot-rest-api-crawler/
- /applebot-rendering-crawler/
- /aranet-searchbot/
- /notebooklm/
- /ga4-ai-agent-human-traffic/
- /ai-crawler-check/
- /ai-crawler-entry-check/
- /ai-crawler-block-or-allow/
- /ai-crawler-mobile-viewport/
- /ai-crawler-sitemap-optimization/
- /ai-site-settings-checklist/
- /ai-kansoku-lab-tracker/
- /ai-kansoku-tool/
- /chatgpt-user-realtime-fetch/
- /google-ai-mode-self-citation/
- /zero-click-search-guide/
- /markdown-ai-server/
- /robots-txt-ai-crawler-complete/
- /search-console-ai-crawler/
- /llms-txt-server-log/
- /semantic-html-ai-guide/
- /metatag-ai-crawler-guide/
- /open-knowledge-format/
- /web-visitors-evolution/
- /bing-ai-report/
- /indexnow-bingbot-effect/
- /traffic-advice/
- /googlebot-guide/
- /clarity-ai-bot-activity/
- /ga4-beginner-check/
- /wordpress-permalink/
- /wordpress-security-checklist/
- /contact-form-securit/
- /crawler-404-guide/
- /tag-noindex-gptbot-crawl-stopped/
- /oai-adsbot/
アクセス先を見ると、AIクローラーやAIエージェント、robots.txt、llms.txt、GA4など、AIとWebの関係を扱った記事が多く含まれています。ただし、SofyaBotがどのような基準でURLを選択しているのかは、このログだけでは断定できません。
ログ抜粋
159.195.250.248 - - [10/Sep/2026:23:51:54 +0900] "GET /robots.txt HTTP/1.1" 200 994 "-" "SofyaBot/1.0 (+https://sofya.co/bot)" "-"
159.195.250.248 - - [10/Sep/2026:23:51:56 +0900] "GET /perplexity-crawler-guide/ HTTP/1.1" 200 24951 "-" "SofyaBot/1.0 (+https://sofya.co/bot)" "-"
159.195.250.248 - - [10/Sep/2026:23:52:27 +0900] "GET /about/ HTTP/1.1" 200 19519 "-" "SofyaBot/1.0 (+https://sofya.co/bot)" "-"
159.195.250.248 - - [10/Sep/2026:23:52:32 +0900] "GET /contact/ HTTP/1.1" 200 15651 "-" "SofyaBot/1.0 (+https://sofya.co/bot)" "-"
159.195.250.248 - - [11/Sep/2026:00:55:47 +0900] "GET /meta-externalagent/ HTTP/1.1" 200 24481 "-" "SofyaBot/1.0 (+https://sofya.co/bot)" "-"
159.195.250.248 - - [11/Sep/2026:01:13:03 +0900] "GET /robots-txt-ai-crawler-complete/ HTTP/1.1" 200 33089 "-" "SofyaBot/1.0 (+https://sofya.co/bot)" "-"今回の観測では、約5時間のあいだに単一IPから322件、52のユニークURLへのアクセスが確認されました。SofyaBotが複数のページを繰り返し取得している点は、通常のGooglebot的な巡回とは異なる動き方です。
そしてかなりのアクセスがあったにもかかわらず、GA4のアクセス解析画面には1件も表示されませんでした。
なぜGA4に映らないのか
322件のアクセスがサーバーログに残っていたにもかかわらず、GA4のアクセス解析画面にはSofyaBotの訪問は表示されませんでした。なぜかというと、サーバーログとGA4でアクセスを記録する仕組みが異なるためです。
GA4は通常、Webページに埋め込まれたJavaScriptの計測タグがブラウザ上で実行されることでアクセスを記録します。人間がブラウザでページを開くと、計測タグが動作し、GA4へイベントデータが送信されます。
対して、今回確認したSofyaBotのアクセスは、Webサーバーへ直接HTTPリクエストを送りページを取得するタイプと考えられます。この場合、ページ内のGA4計測タグが実行されなければ、サーバーログにはアクセスが残っていてもGA4には記録されません。
GA4に映らないBotアクセスをサーバーログで確認する方法については、GA4に映らないAIエージェントのアクセスをサーバーログで確認するで詳しく解説しています。
実はSofyaBotだけの話ではありません。AIエージェントやMCPツールが、ブラウザを操作せずHTTPリクエストだけでWebページを取得する場合、同じようにGA4では見えないアクセスが発生します。AIからのアクセス状況を把握したい場合は、GA4だけでなくサーバーログも確認する必要があります。
MCPとWebMCP、SofyaBotの関係
SofyaBotを理解するうえで、MCPとWebMCPの違いも整理しておきます。名前は似ていますが、Webとの関わり方は大きく異なります。
| 用語 | 役割 |
|---|---|
| MCP(Model Context Protocol) | AIエージェントが外部のツールやデータと連携するための共通プロトコル |
| WebMCP | Webサイト側がブラウザ内でAIエージェント向けの機能を「ツール」として公開する仕組み |
| SofyaBot | SofyaのWeb取得処理に関連してWebサイトへアクセスするクローラー |
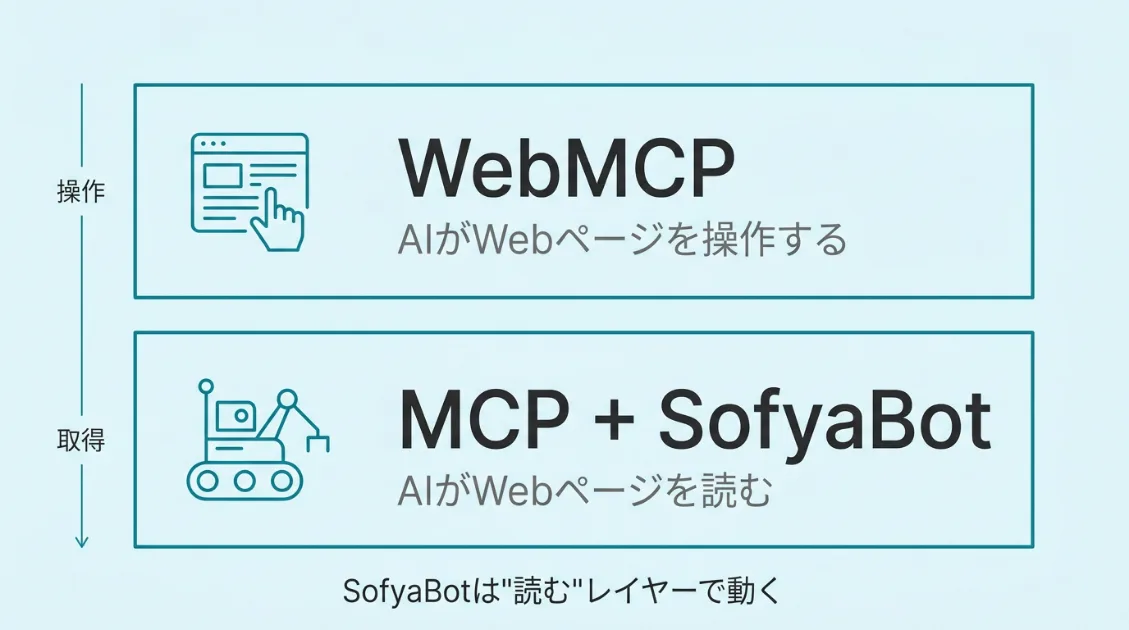
SofyaBotは、WebサイトへHTTPリクエストを送り、ページの情報を取得するタイプのアクセスです。一方のWebMCPは、Webサイト自身が検索やフォーム入力、ページ内の操作などをAIエージェント向けの「ツール」として公開します。
つまりは、SofyaBotはAI側からWebの情報を取りに行く仕組み、WebMCPはWebサイト側からAIが利用できる機能を渡す仕組みと考えるとわかりやすいでしょう。
従来のAIエージェントは、WebページのHTMLや画面を解析して内容や操作方法を判断する必要がありました。WebMCPでは、サイト側が「この機能はこう使える」と構造化して公開できるため、AIエージェントは画面を推測しながら操作するのではなく、定義されたツールを直接呼び出せるようになります。
サイト運営者として対応が必要か
SofyaBotのアクセスを確認したとき、robots.txtでブロックすべきかどうか悩む運営者もいると思います。結論から言うと、現時点では特別な対応は不要です。
ブロックしなくていい理由
SofyaBotはsofya.coが公式に提供しているMCPコネクタのクローラーです。User-Agentに運営元のURL(+https://sofya.co/bot)を自己申告しており、素性が確認できます。アクセスパターンも今回の観測では322件・単一IPで、サーバーに過負荷をかけるような挙動は確認されていません。
AIエージェントがsofya.coのMCPツールを使ってサイトの情報を取得するということは、AIがサイトのコンテンツを参照している可能性があります。ブロックすることでその参照機会を失うことになります。
ブロックを検討するケース
以下のような状況では、robots.txtでのブロックを検討する余地があります。
- アクセス数が急増してサーバー負荷に影響が出ている
- 非公開にしたいコンテンツをAIエージェントに取得させたくない
- AIによるコンテンツ利用をサイト方針として制限している
ブロックする場合は、robots.txtに以下を追記します。
User-agent: SofyaBot
Disallow: /robots.txtを使ったAIクローラーの制御については、AIクローラーとrobots.txt——許可・拒否の設定を完全解説で詳しく解説しています。
まとめ
SofyaBotは、sofya.coのWeb取得機能に関連して動作するクローラーとみられます。SofyaはAIエージェント向けにWeb検索やページ取得、情報抽出などの機能を提供しており、MCP経由でも利用できます。
AI観測ラボでは2026年9月10日から11日にかけて、単一IPから322件、52のユニークURLへのアクセスを確認しました。最初にrobots.txtを取得したあと、記事ページやサイト情報ページを含めて広く巡回しており、今回の観測範囲ではサーバーへの大きな負荷も確認されていません。
また、サーバーログには多数のアクセスが残っていた一方、GA4ではSofyaBotの訪問を確認できませんでした。AIエージェントがHTTPリクエストを使ってWeb情報を取得するケースが増えれば、こうした「GA4には見えないアクセス」も今後増えていく可能性があります。
AIからのアクセス状況を把握するには、GA4だけでなくサーバーログもあわせて確認することが重要です。
SofyaBotのようなGA4に映らないAIクローラーを、自分のサイトで確認したい方へ。
AI観測ラボが開発したWordPressプラグイン「kansoku-lab-tracker」を使うと、サーバーログを解析しなくてもAIクローラーの訪問をWordPress管理画面から確認できます。無料・WordPress.org公式配布。
あなたのサイトは、
AIに見えていますか?
URLを入力するだけで30秒。8項目を自動診断し、優先度別の改善プランを提示します。完全無料・登録不要。