Metaのクローラーはどれを許可すべき?5種類とMuseを56日間のログで調べました
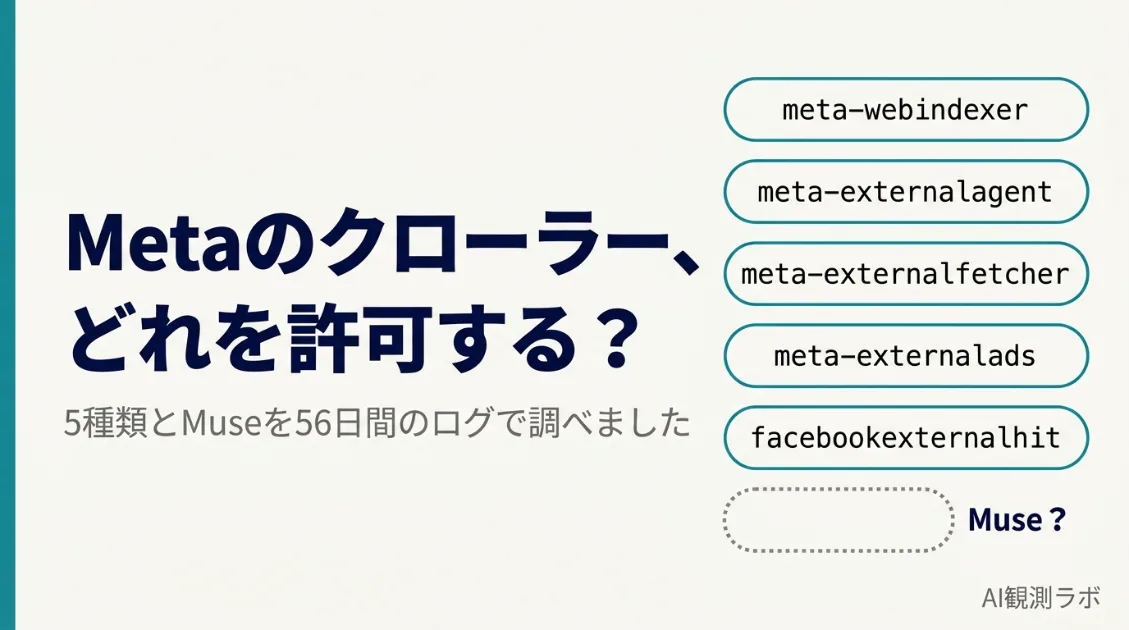
2026年9月8日、Metaが人の代わりにWebサイトを操作するAIエージェント「Muse」を発表しました。
では、MuseがWebサイトを訪れたとき、サーバーログには何と残るのでしょうか。
Metaは現在、サイト運営者向けに5種類のクローラーを公開しています。ところが調べてみると、5種類の中に「Muse」という名前のクローラーはありませんでした。
Museは、専用のクラウド上のコンピューターに用意されたブラウザを操作して、Webサイトを利用する仕組みです。外から見ると、従来のクローラーのように「Muse」と名乗るとは限りません。
一方、AI観測ラボの56日間分のサーバーログでは、Muse発表後の9月後半に meta-webindexer が51件と、観測期間中で最も多くなりました。meta-externalagent が約2分20秒で画像218枚をまとめて取得する動きも確認しています。
Museとログの変化に直接の関係があるとは断定できません。MetaがWebを読む方法は、いま「AIの学習」「AI検索」「ユーザーの依頼」「AIエージェント」と複数に分かれ始めています。Museのような新しいAIエージェントは、クローラーの枠組みだけでは捉えきれなくなってきました。
本記事では、Meta公式の説明と56日間の実測ログをもとに、5種類のクローラーとMuseの違いを整理し、Metaから来るアクセスをサイト運営者がどう扱えばよいかを解説します。
この記事でわかること|📖:約17分
- Metaのクローラー5種類の役割と、Meta AI検索に使われるクローラー
- AIエージェント「Muse」は、従来のクローラーと何が違うのか
- 56日間の実測ログで見えた変化と、ログからMuseを見つけられるのかを試した結果
- 引用は許可して学習は断るなど、目的に合わせたrobots.txtの書き方
結論:Metaから来るアクセスは「何のために来るか」で分けて考える
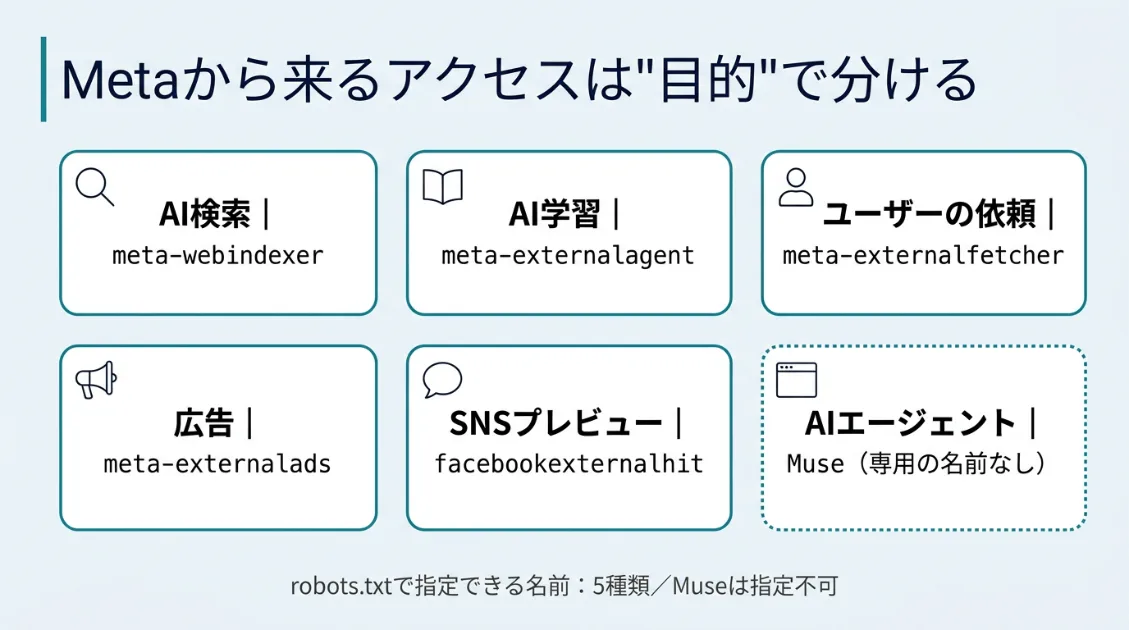
Metaから来るアクセスは、名前ではなく「何のために来るか」で分けると判断しやすくなります。Metaが公開している5種類のクローラーと、2026年9月に登場したMuseを、目的ごとに並べると次のとおりです。
| 名前 | 何のために来る? | robots.txtで止めると? |
|---|---|---|
| meta-webindexer | Meta AIの検索結果を良くするため | Meta AI検索で、ページが表示・引用・リンクされる機会に影響します |
| meta-externalagent | AIの学習や、製品改善のための情報を収集するため | 今後、meta-externalagentによる収集を拒否できます |
| meta-externalfetcher | ユーザーの依頼で個別ページを取得したり、AIがWebサイトを操作する機能の評価・改善に使うため | ユーザーの依頼による取得などは、robots.txtの指定どおりに止まらない場合があります |
| meta-externalads | Metaの広告やビジネス製品に関連するページを取得するため | 広告やビジネス製品に関連する取得に影響します |
| facebookexternalhit | FacebookやInstagramでシェアされたリンクのプレビューを作るため | シェアしたときに、画像やタイトルが表示されなくなる可能性があります |
| Muse | 人の代わりにブラウザを操作して、Webサイトを利用するため | Muse専用のUser-Agentは公開されていないため、「Muse」という名前を指定して制御することはできません |
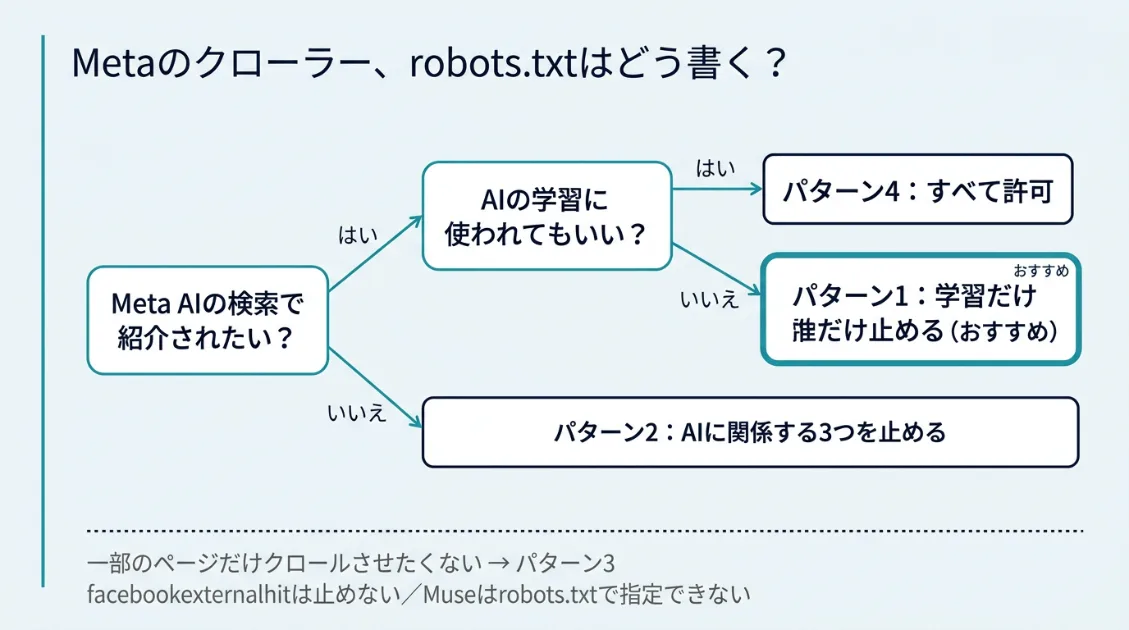
サイト運営者がまず決めたいのは、「Meta AIの検索で紹介されたいか」と「AIの学習に使われてもよいか」の2点です。
Meta AIの検索で紹介されたいなら、meta-webindexer は許可しておきます。AIの学習には使われたくない場合は、meta-externalagent だけを拒否します。2つは別々の名前で動いているため、片方だけを止めることができます。
facebookexternalhit は、基本的には止めない方がよいでしょう。止めてしまうと、自分の記事をFacebookやInstagramでシェアしたときに、画像やタイトルなどのリンクプレビューが正しく表示されない可能性があります。
meta-externalfetcher とMuseは、robots.txtだけでは管理しきれない場合があります。すぐに設定したい人は、目的別 robots.txt の書き方から読んでください。許可するか止めるかの基本的な考え方は、AIクローラーはブロックすべき?許可すべき?でも解説しています。
Metaの5種類、結局どれが一番来る?
公式の説明だけでは、実際にどのくらいのアクセスがあるのかはわかりません。そこで、AI観測ラボのサーバーログ(2026年8月3日〜9月28日の56日間)から、Metaの5種類のクローラーを数えました。
| 名前 | 56日間の件数 | robots.txtへのアクセス | 1回のアクセスで取っていくもの |
|---|---|---|---|
| meta-externalagent | 1,015件 | ログ上は0回 | 記事ページ・タグページ・CSS・画像をまとめて取得。1〜2週間おきに大きな波がある |
| facebookexternalhit | 148件 | 56日中46日(82回) | SNSでシェアされた記事のページと、シェア用の画像 |
| meta-webindexer | 67件 | ログ上は0回 | 1本の記事と、記事内のCSS・画像を数秒〜20秒ほどでセットで取得 |
| meta-externalads | 1件 | ログ上は0回 | 記事ページを1回だけ取得 |
| meta-externalfetcher | 0件 | ― | ― |
| Muse | 数えられない | ― | 専用のUser-Agentが公開されていないため、ログからMuseだけを切り分けて数えることはできません |
facebookexternalhit の件数は、Metaの回線から届いたものだけを数えています。iPhoneのiMessageやLINEも、リンクのプレビューを作るときに facebookexternalhit という名前を名乗るため、名前だけで数えると実際より多くなります。AI観測ラボの9月後半のログでは、facebookexternalhit を名乗るアクセス74件のうち、Metaの回線から来たものは52件でした。
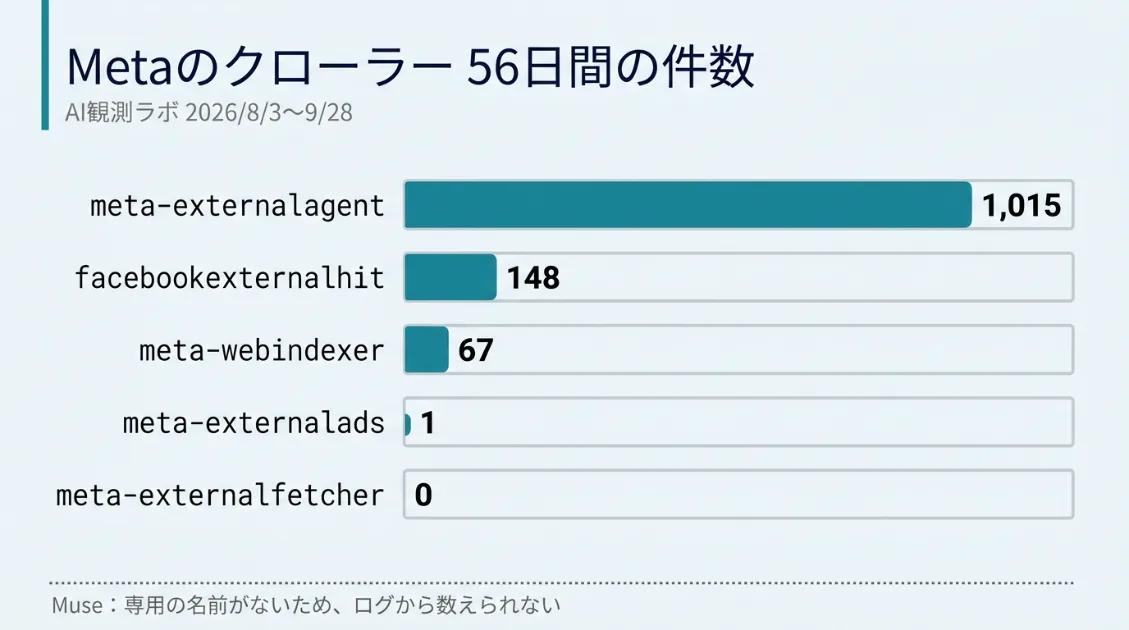
最も多かったのは、AIの学習などに使われる meta-externalagent で、56日間で1,015件でした。毎日少しずつ来るのではなく、1〜2週間おきに数十件から200件以上がまとまって届く「波」のような来かたをしています。
meta-webindexer は67件と件数は少なめですが、動きに特徴があります。サイト全体を順番に見て回るのではなく、1本の記事と記事内の画像やCSSを、数秒から20秒ほどでセットで取得していました。人がブラウザで1ページを開いたときと、よく似た取りかたです。
meta-externalads は、56日間でたった1件でした。2026年9月17日に1つの記事ページへアクセスし、301リダイレクトを受けたあと、転送先のページを取得した記録は確認できませんでした。
meta-externalfetcher を名乗るアクセスは、今回の56日間では1件も記録されませんでした。ユーザーからの取得の依頼自体がなかったのか、別の仕組みで処理されたのかまでは、サーバーログだけでは判断できません。
robots.txtの取り方にも違いがありました。robots.txtは、サイト運営者がクローラーに「ここは見ないで」と伝えるためのファイルです。ログ上で /robots.txt の取得を確認できたのは facebookexternalhit だけで、56日間のうち46日、合計82回取得していました。meta-externalagent と meta-webindexer の取得は記録されていませんでしたが、Metaはrobots.txtの内容を最大24時間保存して使うと説明しているため、指定を無視しているとは限りません。
では、表の最後に入れたMuseは、なぜ数えることができないのでしょうか。次のセクションで、Museの仕組みから見ていきます。
Museはどのクローラーとして来る?
結論から言うと、2026年9月29日時点で、Metaが公開しているクローラーの一覧に「Muse」専用の名前はありません。
理由は、Museの仕組みにあります。Museは、Metaが用意した専用のクラウド上のコンピューター(Muse Secure VM)の中で動きます。Muse Secure VMにはブラウザが用意されており、Museは予約やフォームの入力、カスタマーサービスへの問い合わせなどを、ブラウザを操作してWeb上で行います。
Metaのクローラーと、Museは何が違う?
Metaのクローラーも、Museも、Webサイトを読みに来る点は同じです。しかしながら、サイトへの来かたは大きく違います。
| Metaのクローラー | Muse | |
|---|---|---|
| 何をする? | 検索・学習・リンクのプレビューなど、目的ごとにページを取得する | ユーザーの代わりに、Web上で作業をする |
| どうやって読む? | 専用のプログラムでページを取得する | Muse Secure VMの中のブラウザを操作する |
| 見分け方 | Metaが専用のUser-Agentを公開している | Muse専用のUser-Agentは公開されていない |
| robots.txt | クローラーごとに扱いが異なる | 「Muse」という専用の名前は公開されていない |
実際にMuseを使って確認した海外の報告もあります。米国のテックメディア Stark Insider によると、MuseがWebサイトを開いたときのUser-Agentは、ふつうのLinux版のChrome 153と同じでした。Museを示す独自の情報は付いておらず、接続元のIPアドレスもMetaではなく、Cloudflareのものだったと報告されています。
ただ、報告は1件の実測例です。Metaが公式に「MuseはこのUser-Agentで来る」と発表した仕様ではないため、今後変わる可能性もあります。
meta-externalfetcher がMuseなのでは?
Metaの公式ページでは、meta-externalfetcher はユーザーの依頼で個別のページを取得するほか、AIがWebサイトを操作してユーザーの作業を完了させる能力の評価や改善にも使われると説明されています。
meta-externalfetcher の用途にはMuseと重なる部分がありますが、Metaは両者の関係を公表していません。そのため、Museが meta-externalfetcher としてアクセスすると判断する根拠はありません。AI観測ラボの56日間のログでも、meta-externalfetcher を名乗るアクセスは0件でした。
まとめると、Metaから来るアクセスは次の2つに分けて考える必要があります。
- 公開された専用のUser-Agentで見分けられるもの:Metaの5種類のクローラー
- 現時点で専用のUser-Agentが公開されていないもの:Museのブラウザからのアクセス
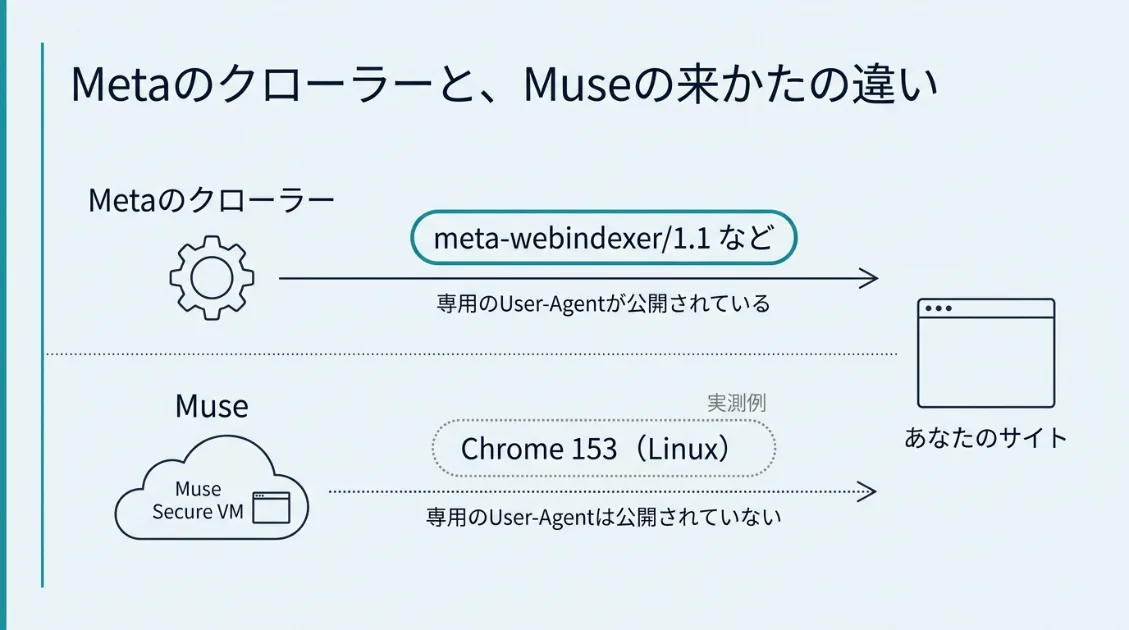
Metaのクローラーなら、ログの中から名前を探せば見つかります。ところがMuseになると、「名前を探す」という観測の方法そのものが通用しなくなります。
Chromeなどのブラウザに見えるAIエージェントは、Museだけではありません。どのAIエージェントがUser-Agentで見分けられて、どれが見分けられないかは、AIエージェントのUser-Agentまとめ—識別できる4種・Chromeに化ける3種で解説しています。
ログからMuseを見つけられる?
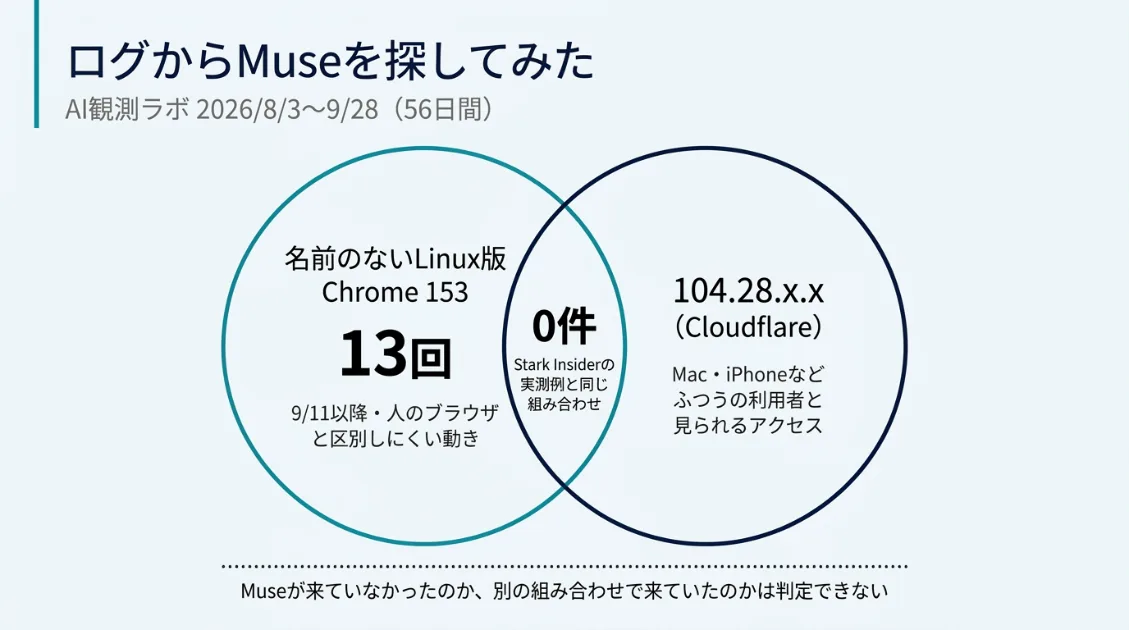
Museには専用の名前がないため、ログを「Muse」で検索しても見つかりません。そこで、前のセクションで紹介したStark Insiderの実測例をもとに、Museと同じ特徴を持つアクセスが56日間のログにあるかを探しました。
探した条件
Stark Insiderの実測では、Museは次の3つの特徴でアクセスしていました。
- User-AgentがLinux版のChrome 153
- Museを示す名前が付いていない
- 接続元のIPアドレスが、Cloudflareの範囲(104.28.x.x)
AI観測ラボでは、「名前の付いていないLinux版のChrome 153」と「104.28.x.xからのアクセス」をそれぞれ別々に探し、両方が一致するアクセスがあるかを確認しました。Linux版のChrome 153でも、最後に自分の名前を付け足しているツール(Googleのページ検査ツールなど)は除いています。
結果:Linux版のChrome 153は13回。104.28.x.xとは一致しなかった
名前の付いていないLinux版のChrome 153で記事を開いたアクセスは、56日間で13回ありました。開かれたのは /meta-externalagent/ や /webmcp/ など、AI観測ラボのさまざまな記事でした。
13回すべてが9月11日以降で、どれも1本の記事とCSS・画像を数秒でまとめて取得していました。少なくともアクセスログの上では、人がブラウザでページを開いたときと区別しにくい動きです。
ただ、13回の接続元はどれも104.28.x.xではありませんでした。反対に、104.28.x.xから来ていたアクセスは、MacやiPhoneのSafari・Chromeなど、ふつうの利用者と見られるものばかりでした。つまり、Stark InsiderがMuseで確認した「名前のないLinux版のChrome 153」と「104.28.x.x」の組み合わせは、56日間のログでは1件も見つかりませんでした。
Museかどうかを見分けられない3つの理由
組み合わせが見つからなかったからといって、Museが来ていなかったとは言い切れません。反対に、13回の中にMuseが含まれていたとも言えません。理由は3つあります。
1つ目は、Chrome 153が9月に一般の人のブラウザにも広がったことです。Googleは、Chrome 153の正式版を2026年9月8日に公開しました。Museが発表されたのと同じ日です。AI観測ラボでは8月21日からChrome 153を名乗るアクセスがありましたが、正式版が出る前のアクセスは、先行版の利用者や自動ツールなども考えられます。9月8日以降はChrome 153が正式版として配られたため、Linux版のChrome 153が9月11日以降に現れたことは、ふつうの人のブラウザの更新でも説明がつきます。
2つ目は、104.28.x.xのようなCloudflareのIPアドレスを、一般の人も使っていることです。CloudflareのIPアドレスだからといって、AIエージェントとは限りません。Cloudflareは、AppleのiCloudプライベートリレーなど、一般の人の通信を中継する用途にも使われています。実際にAI観測ラボのログでも、同じ104.28.x.xの範囲から、SafariやiPhoneなど、ふつうの利用者と見られるアクセスが記録されていました。
3つ目は、Museが名前を名乗っていないことです。ボットやツールの多くは、ふつうのブラウザと同じUser-Agentの最後に、自分の名前を付け足します。AI観測ラボのログに残っていた、Googleのページ検査ツールのUser-Agentと比べてみます。
名前の付いていないLinux版のChrome 153(13回のアクセス)
Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/153.0.0.0 Safari/537.36

Googleのページ検査ツール(2026年9月29日)
Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/153.0.8010.52 Safari/537.36 (compatible; Google-InspectionTool/1.0)
Googleのツールは、最後の (compatible; Google-InspectionTool/1.0) で自分の正体を伝えています。Stark Insiderの実測例のとおりなら、Museには同じような名前が付いていません。
今回の観測でわかったこと
Museが来ていなかった可能性もあれば、別の組み合わせで来ていた可能性もあります。少なくとも、今のサーバーログだけから、一般の人とMuseを確実に見分ける方法は見つかりませんでした。
AIエージェントがふつうのブラウザと同じ姿で来るようになると、User-Agentの名前だけではアクセスを見分けられなくなります。AIエージェントが自分の正体を証明する仕組みとしては、Web Bot Authのような電子署名の技術も提案されています。
56日間で、Metaのクローラーは何が変わった?
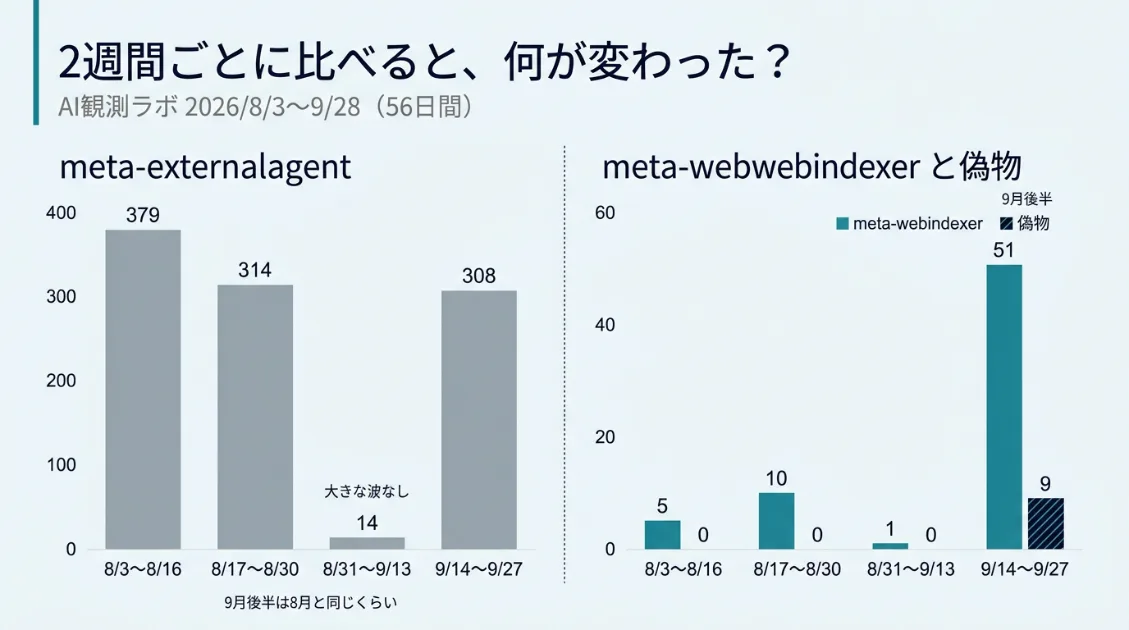
56日間のログを2週間ずつ4つの期間に分けて、Metaのクローラーの件数を比べました。Museが発表された9月8日は、3つ目の期間に入っています。
| 名前 | 8/3〜8/16 | 8/17〜8/30 | 8/31〜9/13 | 9/14〜9/27 |
|---|---|---|---|---|
| meta-externalagent | 379件 | 314件 | 14件 | 308件 |
| meta-webindexer | 5件 | 10件 | 1件 | 51件 |
| Meta-ExternalAgent/1.0(偽物) | 0件 | 0件 | 0件 | 9件 |
※各期間は、サーバーのログが切り替わる毎日午前4時ごろで区切っています。たとえば「9/14〜9/27」は、9月14日の午前4時ごろから9月28日の午前4時ごろまでの2週間です。
表から見えてきた変化は、次の3つです。
変化1:meta-webindexer が9月後半に最も多くなった
Meta AIの検索に使われる meta-webindexer は、最初の3つの期間では5件・10件・1件と少なめでした。ところが9月後半の2週間では51件と、観測期間の中で最も多くなりました。
1本の記事と画像やCSSをセットで取得する取りかたは変わらず、増えたのは取りに来る回数でした。
meta-webindexer の増加は、AI観測ラボだけの話ではない可能性があります。ボット対策会社のDataDomeは、2026年4〜6月の観測で、meta-webindexer のアクセスが前の3か月と比べて約2.6倍(+163%)に増えたと報告しています。
ただし、9月後半の増加とMuseの発表に直接の関係があるかどうかは、ログからは判断できません。meta-webindexer についてくわしくは、meta-webindexerとは?Meta AI検索に関係するクローラーの正体と動きで解説しています。
変化2:meta-externalagent の9月後半308件は、8月と同じくらいだった
表だけを見ると、meta-externalagent は9月前半の14件から9月後半の308件へ、急に増えたように見えます。しかし8月のログまでさかのぼると、8月の2つの期間も379件と314件でした。9月後半の308件は8月と同じくらいの量で、少なかったのは9月前半の14件のほうです。
meta-externalagent は、毎日少しずつではなく、大きな波のようにまとめて来ます。56日間で目立った波は、8月7日(77件)、8月11日(167件)、8月25日(85件)、8月30日(223件)、9月18日(231件)でした。9月前半は、ほかの期間で見られたような大きなアクセスの波が確認されませんでした。
変化3:Metaを名乗る偽物が、9月後半に初めて現れた
もう1つの変化は、meta-externalagent を名乗る偽物のアクセスです。8月から9月前半までは1件もありませんでしたが、9月21日から24日にかけて、合わせて9件が記録されました。
偽物は本物とUser-Agentの書き方が少し違い、Metaとは関係のないIPアドレスから来ていました。偽物の見分け方は、後のセクションでくわしく紹介します。
なお、9月18日に meta-externalagent が見せた「いつもと違う取りかた」は、別の記事でログをすべて公開してくわしく紹介する予定です。次のセクションでは、9月後半に現れた偽物のアクセスと、本物のMetaのクローラーを見分ける方法を紹介します。
Metaを名乗る偽物は、どう見分ける?
9月後半に記録された偽物の meta-externalagent は、9件ありました。User-Agentの名前は、だれでも自由に書きかえられます。そのため、「Meta」と書いてあるだけでは、本物のMetaのクローラーとは限りません。
本物と偽物のUser-Agentを比べる
AI観測ラボのログに残っていた、本物と偽物のUser-Agentです。
本物(56日間で1,015件)
Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/145.0.0.0 Safari/537.36 (compatible; meta-externalagent/1.1 (+https://developers.facebook.com/docs/sharing/webmasters/crawler))

偽物(9月21日〜24日に9件)
Mozilla/5.0 (compatible; Meta-ExternalAgent/1.0; +https://developers.facebook.com/docs/sharing/webmasters/crawler)
本物は、頭の部分がふつうのブラウザと同じ形をしていますが、最後に必ず meta-externalagent/1.1 と小文字で名前を付けていました。一方の偽物は、Meta-ExternalAgent/1.0 と大文字まじりで、バージョンも1.0でした。
ただし、書き方の違いだけで判断するのは危険です。書き方は、偽物のほうがまねをすれば簡単にそろえられます。
確実なのは、IPアドレスの持ち主を調べること
本物かどうかを確実に確かめるには、アクセスしてきたIPアドレスの持ち主を調べます。Metaは、自社のクローラーが使うIPアドレスは、Metaの番号(AS32934)に登録されていると説明しています。
IPアドレスの持ち主は、ヨーロッパのIPアドレス管理団体RIPE NCCが公開している「RIPEstat」で調べられます。AI観測ラボでは、本物の meta-externalagent が使っていた3つのIP帯(57.141.2.0/24、57.141.14.0/24、57.141.16.0/24)が、すべてAS32934に登録されていることを確認しました。
偽物の9件は、Google Cloudの番号(AS396982)に登録された3つのIPアドレスから来ていて、Metaの番号には登録されていませんでした。
偽物は何をしようとしていた?
偽物が探していたのは、記事ではなく、サイトの設定ファイルでした。
.env.save、env.js:パスワードなどを保存しておくファイルfirebase-adminsdk.json:Googleのサービスの管理用の鍵ファイル.github/workflows/deploy.yml:サイトを公開する手順を書いたファイル
Metaの名前を借りたのは、「Metaのクローラーなら止めずに通そう」と考えるサイトの設定をすり抜けるためだと考えられます。AI観測ラボには該当するファイルがなかったため、9件すべてが「見つからない(404)」か「アクセス禁止(403)」で終わりました。
Metaのクローラーを許可するときは、User-Agentの名前だけで通すのではなく、IPアドレスの持ち主まで確認できるようにしておくと安心です。AIのクローラーの本物と偽物を見分ける方法は、AIクローラーのUser-Agent一覧でも紹介しています。
目的別 robots.txt の書き方
ここまでの内容をもとに、サイトの目的に合わせたrobots.txtの書き方を4つのパターンで紹介します。robots.txtは、サイトのいちばん上の階層(例:https://example.com/robots.txt)に置くテキストファイルです。
書く前に、1つだけ知っておきたいルールがあります。クローラーは、robots.txtの中から自分の名前が書かれたグループだけを読みます。User-agent: meta-externalagent のように名前を指定したグループがあると、meta-externalagent は、すべてのクローラー向けの User-agent: * のグループを読まなくなります。そのため、Meta専用のルールは必要なものだけを書くのが安全です。
パターン1:Meta AIの検索では紹介されたい。学習には使われたくない
多くのサイトにおすすめなのが、パターン1です。AIの学習などに使われる meta-externalagent だけを止めます。
User-agent: meta-externalagent
Disallow: /
Meta AIの検索に使われる meta-webindexer については、専用のルールを書きません。専用のルールがなければ、meta-webindexer は User-agent: * など、サイト全体に設定している通常のルールに従います。
パターン2:Meta AIには、検索も学習も使われたくない
MetaのAI全体に記事を使われたくない場合は、AIに関係する3つのクローラーを止めます。facebookexternalhit は止めないようにするのがポイントです。
User-agent: meta-externalagent
Disallow: /

User-agent: meta-webindexer
Disallow: /

User-agent: meta-externalfetcher
Disallow: /
パターン2の設定で、Metaの名前付きのAIクローラーに対して、拒否の意思を示せます。ただし、meta-externalfetcher は、ユーザーの依頼による取得ではrobots.txtの指定どおりに止まらない場合があると、Metaが説明しています。
パターン3:一部のページだけクロールさせたくない
特定の場所だけを、MetaのAIに関係するクローラーにクロールさせないように指定することもできます。パターン3では、/members/ 以下をクロールしないよう指定します。
User-agent: meta-externalagent
User-agent: meta-webindexer
Disallow: /members/
Disallow: /wp-admin/
User-agentを2行続けて書くと、2つのクローラーに同じルールをまとめて指定できます。
注意したいのは、2行目以降の Disallow: /wp-admin/ です。名前を指定したグループを作ると、2つのクローラーは User-agent: * のルールを読まなくなります。すでに User-agent: * で止めている場所があれば、同じ行をグループの中にも書き写してください。例では、WordPressでよく止めている /wp-admin/ を書き写しています。
なお、robots.txtは「クロールしないで」とお願いするための仕組みで、ページを隠したり守ったりする仕組みではありません。会員限定のページや、見せたくない情報を本当に守りたい場合は、robots.txtではなく、ログインなどでアクセスそのものを制限してください。
パターン4:すべて許可する
Meta専用の拒否ルールを書かなければ、Metaのクローラーには、User-agent: * などの通常のルールが当てはまります。以前にMetaのクローラーを止める設定を入れていた場合は、該当する行を消してください。
書きかえるときの3つの注意点
1つ目は、反映までに時間がかかることです。Metaは、robots.txtの内容を最大24時間保存して使うと説明しています。書きかえた直後にアクセスが止まらなくても、1日ほど様子を見てください。
2つ目は、Museはrobots.txtでは指定できないことです。ふつうのブラウザと見分けがつかないため、無理に止めようとすると、一般の人のアクセスまで止めてしまうおそれがあります。
3つ目は、書きかえた後に必ず確認することです。ブラウザで自分のサイトの /robots.txt を開き、書いた内容が表示されるかを確かめてください。WordPressでYoast SEOを使っている場合は、環境によっては「Yoast SEO」→「ツール」→「ファイルエディター」から編集できます。ファイルエディターが表示されない場合は、サーバー側でファイルを編集する必要があります。
Meta以外のAIのクローラーも含めて、許可するか止めるかの考え方は、AIクローラーはブロックすべき?許可すべき?で解説しています。
まとめ:クローラーの名前だけでは、Metaのアクセスを把握しきれなくなってきた
Metaから来るアクセスは、名前だけを見るのではなく「何のために来るか」で分けると、許可するか止めるかを判断しやすくなります。
- Meta AIの検索で紹介されたいなら、meta-webindexer は止めない
- AI学習のための収集を止めたいなら、meta-externalagent を止める
- facebookexternalhit は、リンクプレビューのために基本的には止めない
- Metaを名乗るアクセスは、IPアドレスの持ち主(AS32934)も確認する
一方で、Museには専用の名前が公開されておらず、ログで探すことも、robots.txtで指定することもできません。AIエージェントが増えるほど、クローラーの名前だけを追う方法では、AIからのアクセス全体を把握しきれなくなります。AI観測ラボでは、引き続きMetaのクローラーとAIエージェントの動きを観測し、変化があれば追記していきます。

AIクローラーを視覚化する
AI Kansoku Lab Tracker
GPTBot、ClaudeBot、PerplexityBotなど、WordPressサイトに訪問したAIクローラーを記録できる無料プラグインです。
あなたのサイトは、
AIに見えていますか?
URLを入力するだけで30秒。8項目を自動診断し、優先度別の改善プランを提示します。完全無料・登録不要。