KeenableBotってどこのクローラー?運営元に問い合わせて確かめた
AI観測ラボでは常にサーバーのログの中に新たな可能性がないのか日々ログをとりつつ探しております、
9月ごろから「KeenableBot」という見慣れない名前が残っていて、なんなのか3週間ほど試行錯誤しておりました。
AI観測ラボのサイトにも、2026年9月11日から9月30日までのあいだに、KeenableBotを名乗るアクセスが305回ありました。名札(ユーザーエージェント)には「keenable.ai」と書かれていて、AIエージェント向けの検索エンジンを運営するKeenableという会社の名前を名乗っています。
ところが、KeenableBotについて検索ツールやAIで調べると、「Keenable-SearchBot」という別の名前が公式の名札として出てくることがあります。名札の名前が合わないうえに、本物かどうかを確かめるためのIPアドレスの一覧も公開されていません。AI観測ラボも調べはじめた時点では、KeenableBotが本物かどうか判断できませんでした。
正体をはっきりさせるため、AI観測ラボではKeenableの問い合わせ窓口に直接メールを送りました。翌日には、すべての質問に答える返事が届いています。実際のログと公式ページ、運営元からの回答をもとに、KeenableBotの正体とrobots.txtでの扱い方を順番に解説します。
この記事でわかること|📖:約15分
- KeenableBotの正体と、運営元Keenableから届いた回答の中身
- 公式の名札2つ(KeenableBot・Keenable-User)の違いと、「Keenable-SearchBot」という名前が出回っている理由
- AI観測ラボのログに残った、KeenableBotの約3週間の巡回の記録
- 署名(Web Bot Auth)で本物を確かめるしくみと、robots.txtでの扱い方
KeenableBotの正体は?
結論からお伝えすると、KeenableBotは、AIエージェント向けの検索エンジンを運営するKeenableの本物のクローラーです。2026年10月7日、Keenableの担当者から、KeenableBotは自社が運営するクローラーであるという回答が届きました。
Keenableからの回答と、Keenableの公式ページで確かめられたことは、次の4つです。
- KeenableBotは、公開されているページを集めて、Keenableの検索の索引を作るクローラーです。
- KeenableBotは今の正式な名前で、なくす予定もありません。公式ページにも、KeenableBotの名前が載っています。
- AI観測ラボのログに残った名札は、Keenableのクローラーが実際に送っていた名札と一致しました。アクセス元も、クローラーが動いているGoogle Cloudのアメリカ中部の拠点と合っています。
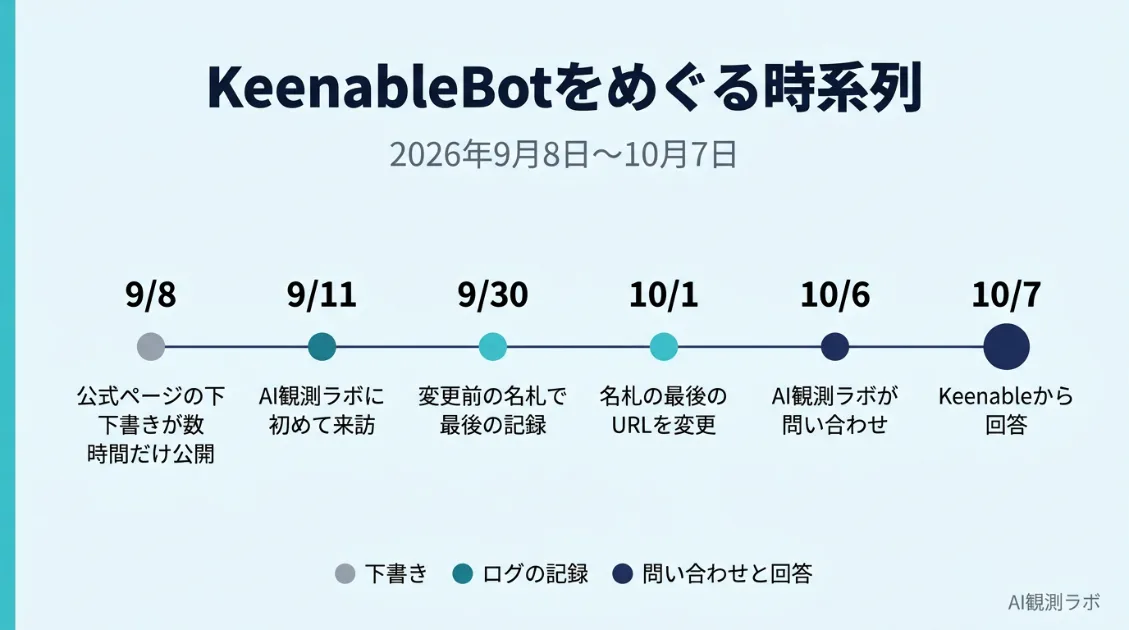
- 検索などで出てくる「Keenable-SearchBot」は、9月8日に数時間だけ公開されて取り下げられた下書きの名前です。Keenable-SearchBotを名乗ってアクセスしたことは一度もありません。
Keenableの公式ページには、KeenableBotのほかに、人に頼まれたときだけページを取りに来る「Keenable-User」という名札も載っています。2つの名札の違いは「Keenableの公式の名札は2つ」で解説します。Keenable-SearchBotという名前が出回っている理由は、「『Keenable-SearchBot』はどこから来た?」で詳しく紹介します。
急いでブロックする必要はある?
急いでブロックする必要はありません。今回のログでは、KeenableBotが読みに来たのは、だれでも見られる公開ページとrobots.txt、サイトマップだけでした。ログイン画面を探したり、設定ファイルを盗み見ようとしたりする怪しい動きは見つかっていません。
Keenableの公式ページには、robots.txtのルールに従うことも明記されています。robots.txtでKeenableBotを止めると、自分のサイトはKeenableの検索の索引から外れて、AIエージェントの答えの中で引用されることもなくなります。
ただ、名札の文字はだれでも書きかえられるため、KeenableBotを名乗るアクセスがすべて本物とは限りません。Keenableは、IPアドレスの一覧を公開するかわりに、アクセスに「署名」をつけて本物だと証明する準備を進めています。署名のしくみとrobots.txtでの書き方は、記事の後半で解説します。偽物のクローラー全般の見分け方は「偽AIクローラーの見分け方」で紹介しています。
Keenableはどんな会社?
Keenableは、Keenable.ai, Inc.という会社が運営する、AIエージェント向けの検索エンジンです。AIエージェントとは、人の代わりに調べものや作業をこなすAIのプログラムのことです。
Google検索は、人が画面で見て読むための検索エンジンです。Keenableは、AIエージェントがプログラムから呼び出して使うための検索エンジンで、検索結果をAIが読み取りやすい形で返します。自社のクローラーでWebサイトを集めて回り、1,000億件をこえる文書の索引(インデックス)を自前で持っていると説明しています。
Keenableの特徴をまとめると、次のとおりです。
- 2026年8月25日に、2,600万ドルの資金調達とあわせてサービスの開始を発表しました。投資したのはAccelやConviction Partnersなどの投資会社で、GoogleやAmazonの幹部も個人として出資しています。
- CEOのAndrey Styskin氏はロシアの検索エンジンYandexの出身で、チーフサイエンティストのMatthias Petri氏はAmazonでAIのための検索の仕組みを作っていた人物です。
- 料金は検索1,000回あたり1ドルで、AIエージェントが大量に検索することを前提にした値段になっています。
- 「過去のある日のWeb」を検索できる機能があり、AIが今のWebだけでなく、以前のWebの状態も調べられるようにしています。
Yandexが使っているクローラーについては「YandexBotとは」で紹介しています。
なぜ私たちのサイトに来るの?
Keenableが検索結果を返すには、前もって世界中のWebサイトを読んで、索引に入れておく必要があります。索引を作るためにWebサイトを読んで回るプログラムがクローラーです。
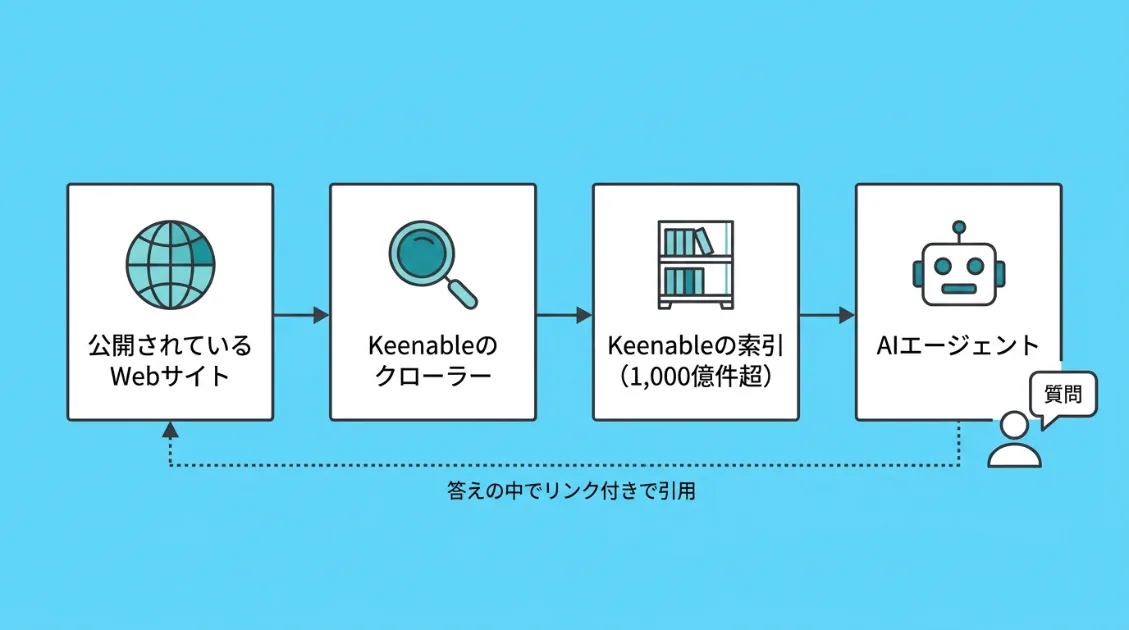
流れを順番に見ると、次のようになります。
- KeenableBotが、公開されているWebサイトを読んで回ります。
- 読んだ内容をKeenableの索引にためておきます。
- 人がAIエージェントに質問すると、AIエージェントがKeenableで検索します。
- Keenableは索引の中から答えに使える情報を探して、元のサイトのリンクと一緒に返します。
Keenableの索引に入っていれば、AIエージェントの答えの中で自分のサイトが引用される可能性があるということです。
AIエージェント向けの検索エンジンは、Keenableのほかにもいくつか登場しています。同じタイプのExaが使っているクローラーは「ExaSearchBotとは」で紹介しています。
Keenableの公式の名札は2つ
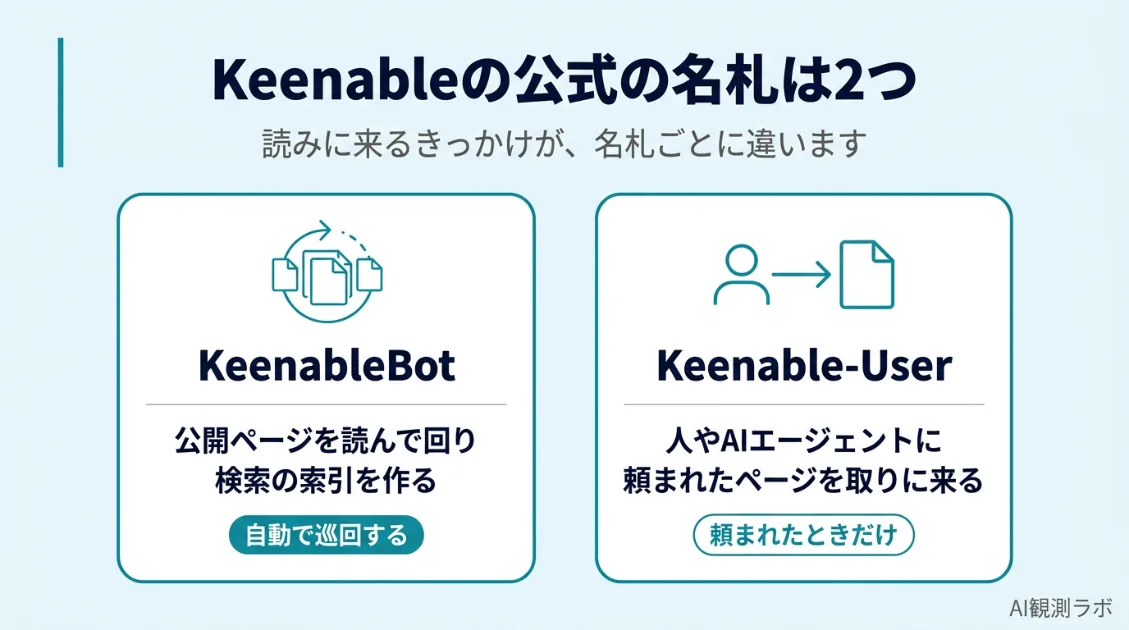
Keenableは、自社のクローラーを説明する公式ページ(keenable.ai/bot)を公開しています。2026年10月7日の時点で公式ページに載っている名札は、KeenableBotとKeenable-Userの2つです。
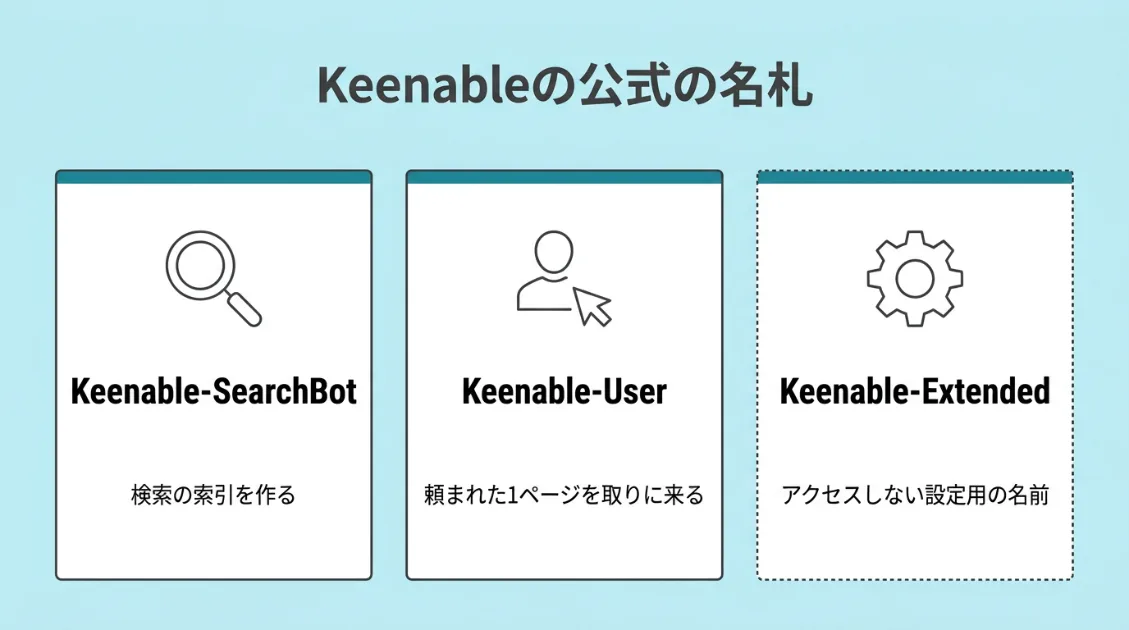
| 名札 | 役割 | 動き方 |
|---|---|---|
| KeenableBot | 公開されているページを集めて、検索の索引を作る | 自動でサイトを読んで回る |
| Keenable-User | 人やAIエージェントに頼まれたページを取りに来る | 頼まれたときだけ動き、自動で読んで回ることはしない |
KeenableBot:検索の索引を作るクローラー
KeenableBotは、公開されているWebサイトを読んで回り、Keenableの検索の索引に入れるクローラーです。Googleで言えば、Googlebotにあたる役割です。AI観測ラボのログに残っていたのも、KeenableBotでした。
Keenableの公式ページには、検索の答えに元のページをリンク付きで示すと書かれています。KeenableBotに読まれて索引に入っていれば、AIエージェントの答えの中で自分のサイトが引用される可能性があります。反対に、robots.txtでKeenableBotを止めると、自分のサイトは索引から外れて、答えにも出なくなります。
Keenable-User:頼まれたときだけ取りに来る
Keenable-Userは、人や、人の代わりに動くAIエージェントから頼まれたときに、必要なページを取りに来るプログラムです。たとえば、AIエージェントにリンクを貼って「リンク先のページを要約して」と頼んだときに動きます。KeenableBotのように、自動でたくさんのページを読んで回ることはしません。
Keenableからの回答でも、Keenable-UserはKeenableBotとは別のもので、人の依頼を受けて動く名札だと説明されていました。AI観測ラボのログには、約3週間のあいだ、Keenable-Userのアクセスは1回も残っていません。
公式の名札の文字
Keenableの公式ページには、KeenableBotが実際に送ってくる名札の文字も載っています。
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; KeenableBot/1.0; +https://keenable.ai/bot)AI観測ラボのログに9月30日までに残っていた名札は、最後のURLだけが公式ページの名札と違い、「+https://keenable.ai/」で終わっていました。Keenableからの回答によると、名札の最後のURLは10月1日に「+https://keenable.ai/」から「+https://keenable.ai/bot」に変わっています。名前の部分の「KeenableBot/1.0」は変わっていないため、robots.txtでKeenableBotを指定したルールは、古い名札にも新しい名札にも当てはまるとKeenableは説明しています。
公式ページには、問い合わせ窓口のメールアドレス(abuse@keenable.ai)も書かれています。Keenableの名前を名乗る怪しいアクセスを見つけたときは、サイトの名前、アクセスの時刻、アクセス元のIPアドレスを添えて送ると、Keenableのアクセスかどうかを答えてもらえます。
AI観測ラボに来たKeenableBotの記録
AI観測ラボのサイトに残っていた、KeenableBotのアクセスの記録を紹介します。2026年8月31日からのログをさかのぼると、最初の記録は9月11日の23時38分でした。9月11日から9月30日までの約3週間で、KeenableBotのアクセスは305回ありました。
10月1日から10月5日の朝までは、KeenableBotの来訪はありません。10月5日以降のログは、次の更新で追加します。また、記録の期間中、Keenable-Userのアクセスは1回もありませんでした。来ていたのは、すべてKeenableBot/1.0を名乗るアクセスです。
来訪の記録
| 項目 | 記録 |
|---|---|
| 期間 | 2026年9月11日〜9月30日(日本時間) |
| リクエスト数 | 305回 |
| 来訪がなかった期間 | 9月23日〜27日の5日間 |
| アクセス元 | 29個のIPアドレス。すべてGoogle Cloud |
| 読んだページ | 記事ページ、タグページ、トップページ、robots.txt、サイトマップ |
| 怪しい動き | なし |
日ごとのリクエスト数
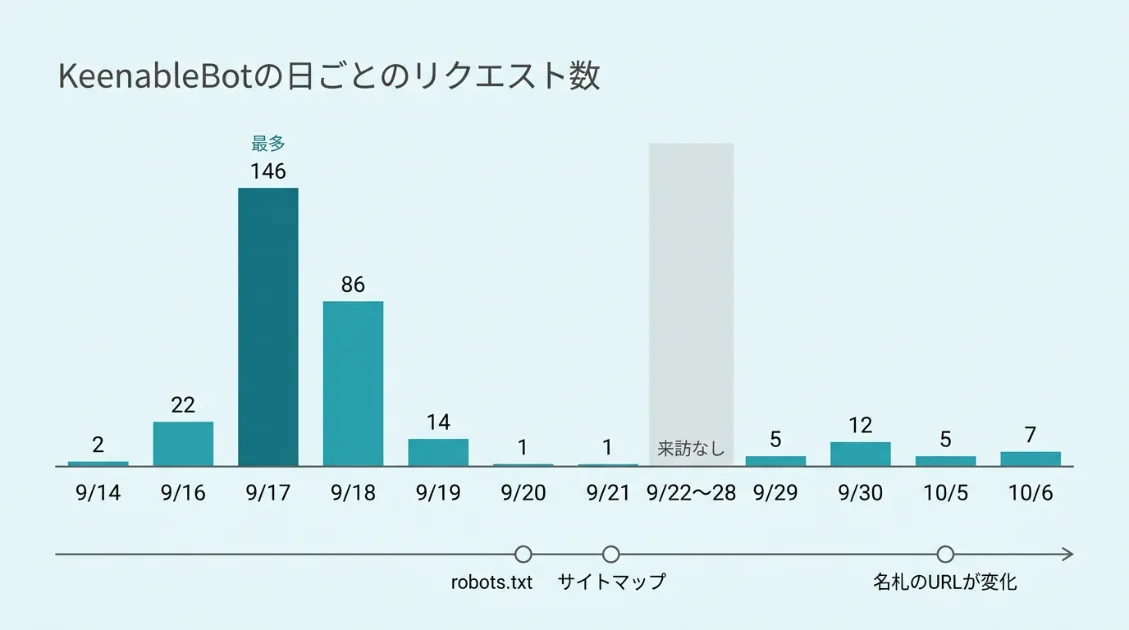
| 日付 | リクエスト数 | 主な動き |
|---|---|---|
| 9月11日 | 2回 | タグページ(最初の記録) |
| 9月12日 | 8回 | 記事ページ、タグページ、robots.txt、サイトマップの目次 |
| 9月14日 | 2回 | 記事ページ |
| 9月16日 | 22回 | 記事ページ、タグページ |
| 9月17日 | 146回 | 記事ページ、タグページ(一番多い日) |
| 9月18日 | 86回 | 記事ページ、タグページ |
| 9月19日 | 14回 | 記事ページ、タグページ |
| 9月20日 | 1回 | robots.txt |
| 9月21日 | 2回 | sitemap.xml、カテゴリーのサイトマップ |
| 9月22日 | 3回 | 固定ページ・書き手・記事のサイトマップ |
| 9月23日〜27日 | 0回 | 来訪なし |
| 9月28日 | 2回 | robots.txt、サイトマップの目次 |
| 9月29日 | 5回 | 記事ページ、robots.txt、トップページ |
| 9月30日 | 12回 | タグページが中心 |
リクエスト数には、転送を表す「301」と、成功を表す「200」の記録を1回ずつ数えています。「301」や「200」は、サーバーがアクセスに返す番号です。最初のアクセスで「301」が返ると、クローラーは別のURLへ案内(転送)されます。案内されたURLにもう一度アクセスして「200」、つまりページを受け取れたという記録が残ります。305回の内訳は、301が148回、200が154回、ページが見つからないことを表す404が3回でした。KeenableBotの記録には「301のあとに200」のセットがたくさんあり、案内に従ってきちんとページを読んでいたことがわかります。
最初の2日間:robots.txtとサイトマップの目次を確認
最初の記録は、9月11日23時38分の、GoogleOtherのタグページへのアクセスでした。翌日の9月12日には、新しいサイトがAIに認識されるまでの実験の記事やClaudeBotのタグページを読んだあと、19時3分にrobots.txtを読んでいます。約1時間後の20時8分には、AI観測ラボのサイトマップの目次である「/sitemap_index.xml」も読みに来ました。
robots.txtは「どのページを読んでよいか」をクローラーに伝えるファイルです。サイトマップとは、サイトの中にどんなページがあるかをまとめた「サイトの地図」のようなファイルです。KeenableBotは、来はじめてすぐに、サイトのルールと地図を確かめていたことになります。
9月14日〜19日:記事とタグページをまとめて読んだ
9月14日にSofyaBotの記事を読んだあと、9月16日から読むページが一気に増えました。9月17日には1日で146回、9月18日には86回のアクセスがあります。
読みに来た記事は、AIクローラーやAI検索をテーマにしたものが中心です。たとえば、次のような記事を読んでいました。
読み方は、公開されている記事とタグページを順番にたどる形で、サイトの弱点を探すような動きはありませんでした。
9月20日〜22日:サイトマップを1つずつ確認
まとめて記事を読んだあと、KeenableBotは9月20日にrobots.txtを読みなおしました。続いて9月21日に、サイトマップがよく置かれている「/sitemap.xml」を探しに来ています。
ただし、AI観測ラボのサイトマップは「/sitemap_index.xml」なので、「/sitemap.xml」は存在しません。ログには、ページが見つからないことを表す「404」が記録されていました。KeenableBotはそのあと、種類ごとに分かれたサイトマップを、9月21日から22日にかけて1つずつ読んでいます。
- 9月21日:/category-sitemap.xml(カテゴリーの一覧)
- 9月22日:/page-sitemap.xml(固定ページの一覧)
- 9月22日:/author-sitemap.xml(書き手の一覧)
- 9月22日:/post-sitemap.xml(記事の一覧)
記事のリンクをたどってたくさん読んだあとに、サイトの地図で読みもらしがないかを確かめる流れが見えてきます。
5日間あいて、9月28日から再び巡回
9月23日から27日までの5日間、KeenableBotの来訪はありませんでした。9月28日の0時22分に再びrobots.txtを読み、約1分後にサイトマップの目次を読んでいます。巡回を始める前に、サイトのルールと地図を確かめなおしたことになります。
9月29日にはReflectionBotの記事を読み、約1分半後にもう一度robots.txtを確認してから、トップページへ移りました。9月30日はタグページを中心に読んでいます。読みに来たタグページの中には、「クローラー認証」「UA偽装」「偽AIクローラー」も入っていました。AI観測ラボがまだ本物かどうか確かめられていなかったクローラーが、偽物のクローラーの見分け方をまとめたページを読んでいたのは、少し皮肉な偶然です。
robots.txtは8日おきに確認
KeenableBotがrobots.txtを読んだ記録は、次の4回です。
- 9月12日 19時3分
- 9月20日 17時28分
- 9月28日 0時22分
- 9月29日 11時24分
9月12日、20日、28日と、ちょうど8日おきに読みに来ています。robots.txtの内容が変わっていないかを、定期的に確かめていると考えられます。Keenableの公式ページにも、robots.txtのルールに従うと書かれています。
ログに残っていたのは変更前の名札
305回のアクセスはすべて、最後のURLが「+https://keenable.ai/」で終わる、変更前の名札でした。
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; KeenableBot/1.0; +https://keenable.ai/)Keenableからの回答によると、名札の最後のURLは10月1日に「+https://keenable.ai/bot」に変更されました。AI観測ラボのログでは、最後の記録が9月30日なので、変更前の名札しか残っていないことと回答はぴったり合っています。
10月1日から10月5日の朝までは来訪がなかったため、新しい名札のアクセスはまだ観測できていません。新しい名札が届いたら、記事に追記します。
アクセス元のIPアドレス
アクセス元のIPアドレスは29個で、すべてGoogleが貸し出しているクラウドサービス「Google Cloud」のものでした。どれもGoogle Cloud専用のネットワーク番号「AS396982」に属しています。Keenableからの回答でも、KeenableBotはGoogle Cloudのアメリカ中部の拠点(us-central1)で動いていると説明されていました。
リクエスト数の多い10個は、次のとおりです。
| IPアドレス | リクエスト数 | 来た日 |
|---|---|---|
| 104.197.113.xxx | 18回 | 9月16日〜18日 |
| 34.60.36.xxx | 18回 | 9月16日〜18日 |
| 35.192.52.xxx | 18回 | 9月17日〜19日 |
| 35.238.53.xxx | 17回 | 9月17日〜19日・28日・30日 |
| 35.238.73.xxx | 15回 | 9月16日〜19日・21日 |
| 34.59.115.xxx | 14回 | 9月17日・18日 |
| 35.193.89.xxx | 14回 | 9月16日〜18日 |
| 136.112.172.xxx | 13回 | 9月17日・18日・21日 |
| 146.148.103.xxx | 13回 | 9月17日・22日・30日 |
| 34.121.120.xxx | 13回 | 9月17日・18日・20日 |
残りの19個は、1回から12回のアクセスでした。9月下旬に来たIPアドレスのうち、9月28日にrobots.txtを読んだ1個をのぞく6個は、9月中旬にも来ていたIPアドレスです。同じIPアドレスが日をあけてくり返し来ていることからも、同じクローラーが巡回をくり返していることがわかります。
IPアドレスの最後の数字は伏せています。Google CloudのIPアドレスは、時間がたつと別の利用者に貸し出されることがあり、無関係な人のアクセスと結びつけられてしまうおそれがあるためです。
実際のログ
実際のアクセスログの一部です。IPアドレスの最後の数字は伏せています。
9月11日の最初の記録です。GoogleOtherのタグページに「301」で転送され、同じ秒のうちに「200」でページを受け取っています。
34.56.192.xxx - - [11/Sep/2026:23:38:52 +0900] "GET /tag/googleother HTTP/2.0" 301 0 "-" "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; KeenableBot/1.0; +https://keenable.ai/)" "-"
34.56.192.xxx - - [11/Sep/2026:23:38:52 +0900] "GET /tag/googleother/ HTTP/2.0" 200 14444 "https://blog.ai-kansoku.com/tag/googleother" "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; KeenableBot/1.0; +https://keenable.ai/)" "-"
9月12日のrobots.txtと、約1時間後のサイトマップの目次です。
34.63.156.xxx - - [12/Sep/2026:19:03:28 +0900] "GET /robots.txt HTTP/2.0" 200 851 "-" "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; KeenableBot/1.0; +https://keenable.ai/)" "-"
34.63.156.xxx - - [12/Sep/2026:20:08:55 +0900] "GET /sitemap_index.xml HTTP/2.0" 200 287 "-" "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; KeenableBot/1.0; +https://keenable.ai/)" "-"
9月20日、記事をまとめて読んだあとのrobots.txtです。
34.121.120.xxx - - [20/Sep/2026:17:28:43 +0900] "GET /robots.txt HTTP/2.0" 200 851 "-" "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; KeenableBot/1.0; +https://keenable.ai/)" "-"9月28日、5日間あいたあとのrobots.txtと、約1分後のサイトマップの目次です。
35.224.160.xxx - - [28/Sep/2026:00:22:52 +0900] "GET /robots.txt HTTP/2.0" 200 851 "-" "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; KeenableBot/1.0; +https://keenable.ai/)" "-"
35.238.53.xxx - - [28/Sep/2026:00:23:54 +0900] "GET /sitemap_index.xml HTTP/2.0" 200 286 "-" "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; KeenableBot/1.0; +https://keenable.ai/)" "-"
9月30日、「クローラー認証」のタグページへのアクセスです。1行目で「301」が返って転送され、1秒後の2行目で「200」が返ってページを受け取れています。
34.135.45.xxx - - [30/Sep/2026:16:53:17 +0900] "GET /tag/%E3%82%AF%E3%83%AD%E3%83%BC%E3%83%A9%E3%83%BC%E8%AA%8D%E8%A8%BC HTTP/2.0" 301 0 "-" "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; KeenableBot/1.0; +https://keenable.ai/)" "-"
34.135.45.xxx - - [30/Sep/2026:16:53:18 +0900] "GET /tag/%E3%82%AF%E3%83%AD%E3%83%BC%E3%83%A9%E3%83%BC%E8%AA%8D%E8%A8%BC/ HTTP/2.0" 200 14172 "https://blog.ai-kansoku.com/tag/%E3%82%AF%E3%83%AD%E3%83%BC%E3%83%A9%E3%83%BC%E8%AA%8D%E8%A8%BC" "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; KeenableBot/1.0; +https://keenable.ai/)" "-"
「Keenable-SearchBot」はどこから来た?
KeenableBotを調べると、「Keenable-SearchBot」という名前がKeenableの公式の名札として出てくることがあります。Keenableからの回答によると、Keenable-SearchBotは、2026年9月8日に数時間だけ公開されて、同じ日に取り下げられた公式ページの下書きに書かれていた名前です。Keenableのクローラーが、Keenable-SearchBotを名乗ってアクセスしたことは一度もありません。
AI観測ラボも下書きの情報を信じていた
じつは、AI観測ラボも最初は下書きの情報をもとに記事を書いていました。AIの検索ツールでKeenableの公式ページを調べたところ、Keenable-SearchBot、Keenable-User、Keenable-Extendedの3つの名札が「公式の情報」として出てきたためです。
ログに残っていたのはKeenableBotなので、名前が公式の名札と合いません。AI観測ラボが「KeenableBotは本物かどうかわからない」と考えたのは、下書きの情報と見比べていたからでした。Keenableからの回答を読んで公式ページを直接開いたところ、載っていたのはKeenableBotとKeenable-Userの2つだけで、Keenable-SearchBotもKeenable-Extendedもありませんでした。
消えたはずの下書きが残っていた理由
検索ツールやAIは、Webページを読みに来たときに、ページの中身を写しとって保存しています。保存された写しは、次にページを読みなおすまで新しくなりません。
下書きが公開されていた数時間のあいだに検索ツールのクローラーが読みに来ると、下書きの中身が写しとして保存されます。公式ページが書きかえられたあとも、写しが新しくなるまでは、検索ツールは下書きの中身を「公式ページの内容」として答えつづけます。今回は、数時間で消えた下書きが、検索ツールの中では約1か月にわたって残っていました。
AIに質問したときに古い情報が返ってくるのも、同じしくみが原因の一つです。AIが自分のサイトの情報をどう読み取っているかは「自分のサイトがAIに出てこない理由」でも解説しています。
robots.txtに「Keenable-SearchBot」と書いても止まらない
下書きの情報をもとにrobots.txtを書くと、思ったとおりに動きません。Keenableのクローラーは「KeenableBot」と名乗っているため、「Keenable-SearchBot」や「Keenable-Extended」をrobots.txtに書いても、KeenableBotには当てはまらないからです。
Keenableを止めたい場合も、許可したい場合も、robots.txtには「KeenableBot」と書いてください。すでに「Keenable-SearchBot」や「Keenable-Extended」と書いている場合は、書きなおしが必要です。具体的な書き方は、記事の後半で紹介します。
クローラーについて調べるときは、検索ツールやAIの答えだけで判断せず、運営元の公式ページを直接開いて確かめるのが確実です。公式ページだけでわからないときは、運営元に直接問い合わせる方法もあります。
Keenableに直接聞いてみた
ログと公式ページだけでは、KeenableBotが本物かどうかを確かめきれませんでした。そこでAI観測ラボは、2026年10月6日にKeenableの問い合わせ窓口へ英語でメールを送りました。返事が届いたのは翌日の10月7日です。質問には番号どおりに答えてもらえて、記事で引用・要約してよいという許可ももらえました。
質問したこと
AI観測ラボのログを添えて、大きく分けて次の3つを質問しました。
- KeenableBotは、本当にKeenableが運営しているクローラーですか?
- 公式ページの名札とKeenableBotは、どういう関係ですか?
- 本物のアクセスかどうかを確かめる方法はありますか?
回答1:KeenableBotはKeenableのクローラー
1つ目の質問には、「Yes. KeenableBot/1.0 is operated by Keenable.ai, Inc.」という答えが返ってきました。日本語にすると「はい。KeenableBot/1.0はKeenable.ai, Inc.が運営しています」ということですね。
さらに、AI観測ラボのログに残っていた名札は、9月29日〜30日にKeenableのクローラーが実際に送っていた名札と完全に一致するとも説明されていました。アクセス元についても、クローラーが動いているGoogle Cloudのアメリカ中部の拠点(us-central1)だと確かめてもらえました。
回答2:「Keenable-SearchBot」は下書きにだけ存在した名前だった
2つ目の回答で、KeenableBotとKeenable-SearchBotの関係もわかりました。
- Keenable-SearchBotは、9月8日に数時間だけ公開された公式ページの下書きの名前で、クローラーが名乗ったことは一度もありません。
- KeenableBotは今の正式な名前で、古い名札でもなく、なくす予定もありません。
- Keenable-Userは、人の依頼を受けて動く、KeenableBotとは別の名札です。
- 名札の最後のURLは、10月1日に「+https://keenable.ai/bot」に変わりました。
- 名前の部分の「KeenableBot/1.0」は変わっていないので、robots.txtでKeenableBotを指定したルールは、新旧どちらの名札にも当てはまります。
AI観測ラボのログでは、9月30日まではすべて変更前の名札でした。10月1日に名札を変えたという回答は、ログの記録とぴったり合っています。
回答3:IPアドレスの一覧ではなく「署名」で証明する
3つ目の質問には、IPアドレスの一覧を公開するかわりに、アクセスの1回1回に「署名」をつけて本物だと証明する方針だという答えが返ってきました。署名を確かめるための公開鍵はすでに公開されていますが、2026年10月7日の時点では、KeenableBotのアクセスにはまだ署名がついていません。署名が始まったら、公式ページでお知らせするとのことでした。
署名とはどんなしくみなのか、サイト運営者にとって何が変わるのかは、次の「本物かどうか、これからは署名で確かめられる」で解説します。
回答からわかったこと
Keenableからの回答には、公式ページには載っていない情報がいくつも入っていました。下書きが9月8日に数時間だけ公開されていたこと、名札を10月1日に変えたこと、署名で本物を証明する予定であることは、どれも運営元に直接聞いたことで初めてわかった情報です。
問い合わせに対して具体的な回答が返ってくるかどうかも、サイト運営者がクローラーの扱いを判断する材料のひとつになります。今回のKeenableからの回答は、名札を送っていた日付やアクセス元の拠点、名札を変えた日まで、AI観測ラボのログと照らし合わせて確かめられる内容でした。
見慣れないクローラーを見つけたら
KeenableBotにかぎらず、見慣れないクローラーを見つけたときは、運営元に直接問い合わせる方法があります。問い合わせ先は、名札の最後に書かれたURLのページや、運営元の公式サイトに載っていることが多いです。
問い合わせるときは、次の4つを書いておくと、運営元が調べやすくなります。
- 自分のサイトの名前(ドメイン)
- アクセスがあった日時(タイムゾーンも書く)
- アクセス元のIPアドレス
- ログに残っていた名札の文字
Keenableの公式ページにも、署名が始まるまでは、ホスト名・時刻・アクセス元を添えてkeenableのmailアドレスに送れば、自社のアクセスかどうかを答えると書かれています。運営元が答えてくれれば、ログだけでは判断できない部分まで確かめられます。
本物かどうか、これからは署名で確かめられる
Keenableは、IPアドレスの一覧を公開するかわりに、KeenableBotのアクセスに「署名」をつけて、本物だと証明する方針です。署名には、IETF(インターネットの決まりごとを話し合う団体)で標準化が進められている「Web Bot Auth」という仕組みを使います。Web Bot Authは、アクセスに暗号の技術を使った署名をつけて、どの運営元から送られたアクセスなのかを確かめる仕組みです。
名札とIPアドレスでは確かめきれない理由
これまで、クローラーが本物かどうかは、おもに名札とIPアドレスで確かめてきました。とはいえ、どちらにも弱点があります。
- 名札(ユーザーエージェント):クローラーが自分で名乗っているだけなので、だれでも同じ文字を書いてまねできます。
- IPアドレス:KeenableBotのようにGoogle Cloudなどのクラウドで動くクローラーは、借りているIPアドレスが変わります。同じクラウドは、ほかの会社やほかの人も使っています。
Keenableが公式にIPアドレスの一覧を出していないのも、クラウドで動くクローラーにとって、IPアドレスの一覧を正しく保ちつづけるのが難しいからだと考えられます。
署名は「はんこ」と「印影の見本」のしくみ
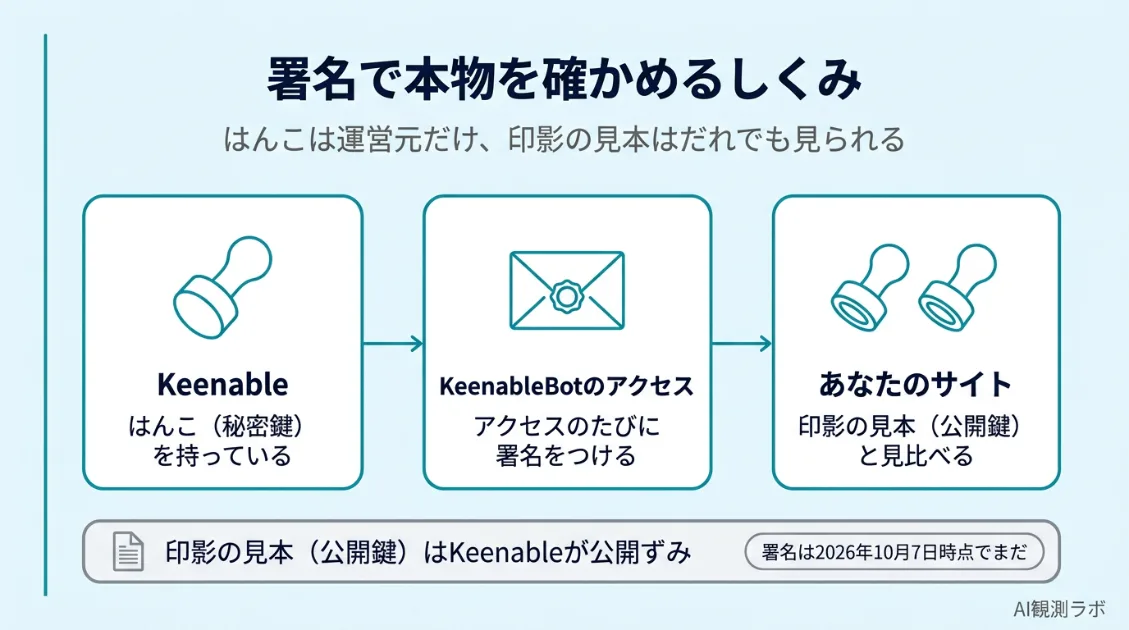
署名のしくみは、はんこにたとえるとわかりやすくなります。
- Keenableは、自分たちだけが持つ「はんこ」(秘密鍵)を用意します。
- はんこを押したときの形がわかる「印影の見本」(公開鍵)を、だれでも見られる場所に置きます。
- KeenableBotは、サイトにアクセスするたびに、はんこを押した「署名」をつけて送ります。
- サイトは、届いた署名を印影の見本と見比べて、本物のKeenableBotかどうかを確かめます。
名札の文字はまねできても、はんこはKeenableしか持っていません。偽物のクローラーは、名札をまねしても、正しい署名をつけられないので見分けられます。
KeenableBotの公開鍵はもう置いてある
KeenableBotの公開鍵、つまり印影の見本は、すでに次の場所に公開されています。
https://keenablebot.keenable.ai/.well-known/http-message-signatures-directoryAI観測ラボでも、公開鍵の置き場所を開いて、公開鍵が1つ載っていることを確かめました。
ただし、署名はまだ始まっていない
公開鍵は置いてありますが、2026年10月7日の時点では、KeenableBotのアクセスにはまだ署名がついていません。印影の見本はあっても、まだはんこが押されていない状態です。今の時点では、署名を使って本物かどうかを確かめることはできません。
Keenableからの回答によると、署名が始まったら、公式ページ(keenable.ai/bot)でお知らせするとのことです。AI観測ラボでも、署名つきのKeenableBotのアクセスを観測できたら、記事に追記します。
署名が始まると何が変わる?
署名が始まっても、多くのサイト運営者が、自分で公開鍵を取りに行って署名を確かめる必要はないと考えられます。Cloudflareは、すでにWeb Bot Authの署名を確かめて、本物と確認できたボットを「確認済みのボット(Verified bots)」として見分ける仕組みに使っています。署名の確認は、サイトを守るサービスが代わりに行うケースが増えていきそうです。
署名で本物を証明する動きは、Keenableだけのものではありません。Googleも、自社のインフラで動く一部のAIエージェントで、Web Bot Authを試しています。Googleは2026年5月に公開したドキュメントで、まだ試験運用の段階だと説明しています。名札とIPアドレスに頼ってきたクローラーの見分け方は、これから署名へと少しずつ移っていきそうです。
署名が始まるまでの確かめ方
署名が始まるまでは、ログに残ったKeenableBotが本物かどうかを、次の2点で判断するのが現実的です。
- 動き方を見る:公開ページとrobots.txt、サイトマップだけを読んでいて、ログイン画面や設定ファイルを探すような動きがないかを確かめます。
- Keenableに問い合わせる:サイトの名前、アクセスの時刻、アクセス元のIPアドレスを添えてabuse@keenable.aiに送ると、Keenableのアクセスかどうかを答えてもらえます。
robots.txtでどう扱えばいい?
KeenableBotの扱い方は、サイトの目的によって変わります。Keenableの公式ページには、robots.txtのルールに従うことと、ページごとの「noindex」などの指定にも従うことが書かれています。目的ごとの書き方を順番に紹介します。
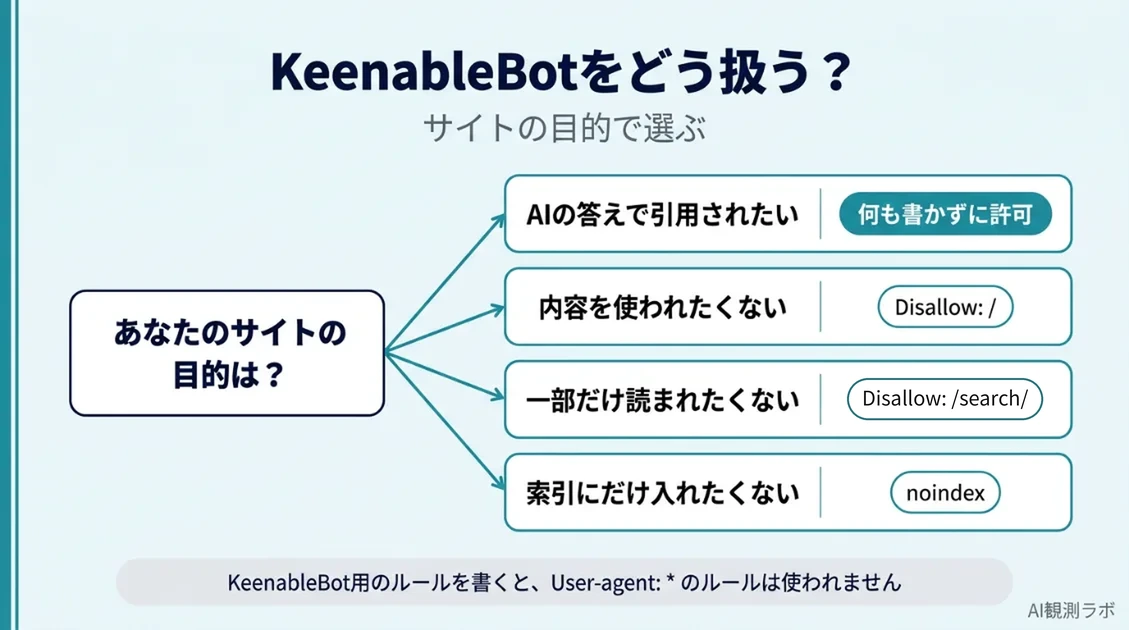
| サイトの目的 | おすすめの扱い方 |
|---|---|
| AIエージェントの答えで引用されたい | 何も書かずに許可する |
| サイトの内容をKeenableに使われたくない | robots.txtで全部止める |
| 公開しているページのうち、一部だけ読ませたくない | robots.txtで一部だけ止める |
| 特定のページだけ検索の索引に入れたくない | ページごとにnoindexを指定する |
引用されたいなら、何も書かなくてよい
AIエージェントの答えの中で自分のサイトを引用してほしい場合は、robots.txtに何も書かなくてかまいません。KeenableBotを名指ししたルールがなければ、KeenableBotは「User-agent: *」(すべてのクローラー向け)のルールに従って読みに来ます。
KeenableBotを止めると、自分のサイトはKeenableの検索の索引から外れて、AIエージェントの答えにも出なくなります。Keenableはまだ新しい検索エンジンですが、AIエージェントが使う検索エンジンが増えていく中で、引用される入り口を一つ残しておく意味はあります。
全部止めたい場合
サイトの内容をKeenableに読まれたくない場合は、robots.txtに次のように書きます。
User-agent: KeenableBot
Disallow: /
「Disallow: /」は、サイトのすべてのページを読まないでほしい、という意味です。名前の部分の「KeenableBot」は、変更前と変更後のどちらの名札にも当てはまります。
一部だけ止めたい場合
公開されているURLのうち、KeenableBotには読ませたくないディレクトリがある場合は、止めたい場所を指定します。たとえば、サイト内検索の結果ページを読ませたくない場合は、次のように書きます。
User-agent: KeenableBot
Disallow: /search/
なお、robots.txtはアクセス制限の仕組みではありません。会員限定ページや機密情報は、ログイン認証などで保護する必要があります。
注意:KeenableBot用のルールを書くと「*」のルールは使われない
一部だけ止めるときに、気をつけたいことがあります。Keenableの公式ページには、KeenableBotを名指ししたルールがある場合、「User-agent: *」のルールより優先すると書かれています。
たとえば、robots.txtが次のようになっているとします。
User-agent: *
Disallow: /wp-admin/

User-agent: KeenableBot
Disallow: /search/
KeenableBotは、自分の名前が書かれた下のルールだけを見ます。上の「User-agent: *」に書いた「/wp-admin/」の制限は、KeenableBotには当てはまりません。KeenableBot用のルールを書くときは、すべてのクローラー向けに止めている場所も、KeenableBot用のルールの中にもう一度書いておきます。
User-agent: *
Disallow: /wp-admin/

User-agent: KeenableBot
Disallow: /wp-admin/
Disallow: /search/
名指ししたルールが「*」より優先されるのは、robots.txtの決まりごと(RFC 9309)どおりの動きで、KeenableBotにかぎった話ではありません。GPTBotやClaudeBotなど、ほかのクローラー用のルールを書くときも同じです。
ページごとに止めたい場合
robots.txtでは、クローラーにページを「読まないで」と伝えます。ページは読まれてもかまわないけれど、検索の索引には入れてほしくない場合は、ページごとに「noindex」を指定します。Keenableの公式ページには、metaタグとX-Robots-Tagの両方で、noindex・nofollow・noneの指定に従うと書かれています。
KeenableBotだけに指定したい場合は、ページの<head>の中に次のmetaタグを書きます。
<meta name="keenablebot" content="noindex">HTMLを書きかえられないPDFなどのファイルは、サーバーから返す情報(HTTPヘッダー)にX-Robots-Tagを入れて指定します。
X-Robots-Tag: keenablebot: noindexnoindexを読み取ってもらうには、noindexを指定したページを、robots.txtでブロックしないでください。robots.txtでクロールを止めると、KeenableBotがページを読めなくなり、ページ内のnoindexも確認できなくなるためです。
「Keenable-SearchBot」「Keenable-Extended」は書いても効かない
「『Keenable-SearchBot』はどこから来た?」で紹介したとおり、Keenable-SearchBotとKeenable-Extendedは、下書きにだけ書かれていた名前です。robots.txtに書いても、KeenableBotには当てはまりません。すでに書いている場合は、「KeenableBot」に書きなおしてください。
書きかえても、すぐには反映されないことがある
AI観測ラボのログでは、KeenableBotがrobots.txtを読みに来た記録が、9月12日、20日、28日、29日の4回残っていました。9月12日から28日までは8日間隔ですが、9月28日の翌日の29日にも読みに来ています。4回の記録だけでは、KeenableBotがrobots.txtを読みなおす間隔は決められません。robots.txtを書きかえた直後には反映されない可能性があることは、頭に入れておいたほうがよさそうです。
また、robots.txtは、対応するクローラーにクロールしてよいかどうかを伝えるための標準的な仕組みですが、アクセスそのものを技術的に止める仕組みではありません。KeenableBotを名乗る偽物が、robots.txtを無視してアクセスすることもできます。偽物のアクセスまで止めたい場合は、署名が始まったあとに署名を確かめ、確かめられないアクセスをWAF(サイトを守るためのファイアウォール)などで止める方法があります。
まとめ:KeenableBotは本物。止めるかどうかはサイトの目的で決めよう
KeenableBotは、AIエージェント向けの検索エンジンを運営するKeenableの本物のクローラーでした。AI観測ラボのログと、Keenableの公式ページ、運営元からの回答を照らし合わせてわかったことは、次のとおりです。
- KeenableBotは、公開ページを集めてKeenableの検索の索引を作るクローラーで、今の正式な名前です。
- Keenableの公式の名札は、KeenableBotと、人に頼まれたときだけ動くKeenable-Userの2つです。
- 検索やAIで出てくる「Keenable-SearchBot」は、9月8日に数時間だけ公開された下書きの名前で、実際には使われていません。
- AI観測ラボには、9月11日から30日までに305回、29個のGoogle CloudのIPアドレスから来ていて、robots.txtやサイトマップにもくり返しアクセスしていました。
- Keenableは、IPアドレスの一覧を出すかわりに、Web Bot Authの署名で本物を証明する予定です。公開鍵はすでに置いてありますが、署名はまだ始まっていません。
- robots.txtで扱いを決めるときは、「KeenableBot」の名前で書きます。KeenableBot用のルールを書くと、「User-agent: *」のルールは使われない点に注意が必要です。
今回いちばん大きかったのは、ログと公式ページだけでは判断できなかったことが、運営元に直接聞くことで確かめられた点です。名札の名前が合わなかった理由も、名札のURLが変わった日も、ログを見ているだけではわかりませんでした。
もう一つ、AI観測ラボ自身も、AIの検索ツールに残っていた下書きの情報を信じてしまいました。見慣れないクローラーを調べるときは、検索結果やAIの答えだけで判断せず、現在の公式ページを直接開いて確かめることが大切です。
AI観測ラボでは、今後もKeenableBotの巡回を観測し、新しい名札でのアクセスや、署名つきのアクセスを確認できたら、記事に追記します。

AIクローラーを視覚化する
AI Kansoku Lab Tracker
GPTBot、ClaudeBot、PerplexityBotなど、WordPressサイトに訪問したAIクローラーを記録できる無料プラグインです。
あなたのサイトは、
AIに見えていますか?
URLを入力するだけで30秒。8項目を自動診断し、優先度別の改善プランを提示します。完全無料・登録不要。