ElevenlabsCrawlerとは?音声AIがサイトを読みに来る理由と止め方
サーバーログに「ElevenlabsCrawler」という見慣れない名前。音声AIで知られるElevenLabsのクローラーですが、なぜ文章中心のサイトにもアクセスしてくるのでしょうか。
ElevenLabsは公式ページで、ElevenlabsCrawlerをElevenLabsの生成AIモデルの学習に使われる可能性のあるコンテンツを、Webから集めるクローラーと説明しています。音声AIで知られる会社ですが、クローラーの収集対象は音声だけとは限りません。今回のログでも、記事やタグページへのアクセスが記録されました。
AI観測ラボでは、2026年10月28日の夜から29日の未明にかけての約3時間20分で、ElevenlabsCrawlerを名乗る669件のリクエストを記録しました。robots.txtとサイトマップへのアクセスに続き、記事やタグページなど583種類のURLへのアクセスを記録しています。画像・CSS・JavaScriptへのリクエストは、今回のログには記録されていません。
この記事でわかること|📖:約5分
- ElevenlabsCrawlerを運営するElevenLabsと、学習用のクローラーとしての公式の説明
- 約3時間で583種類のURLへアクセスした、AI観測ラボでの実際の動き
- IPアドレスの一覧や署名の仕組みがなく、本物かどうかを確かめきれない理由
- robots.txtで止める書き方と、ElevenlabsBotとの違い
ElevenlabsCrawlerとは?
ElevenlabsCrawlerは、ElevenLabsが運営するWebクローラーです。サーバーログには、次のUser-Agent(アクセスしてきたプログラムが名乗る名前)で記録されます。
Mozilla/5.0 (compatible; ElevenlabsCrawler/1.0; +https://elevenlabs.io/docs/bots)User-Agentの末尾にあるURLは、ElevenLabsの公式ページ「Bots」につながっています。公式ページでは、バージョンの数字は今後変わる可能性があると説明されています。
ElevenLabsはどんな会社?
ElevenLabsは、文章を自然な声で読み上げる音声合成や、声の生成など、音声AIのサービスで知られる会社です。音声で会話するAIエージェントを作るサービスも提供しています。
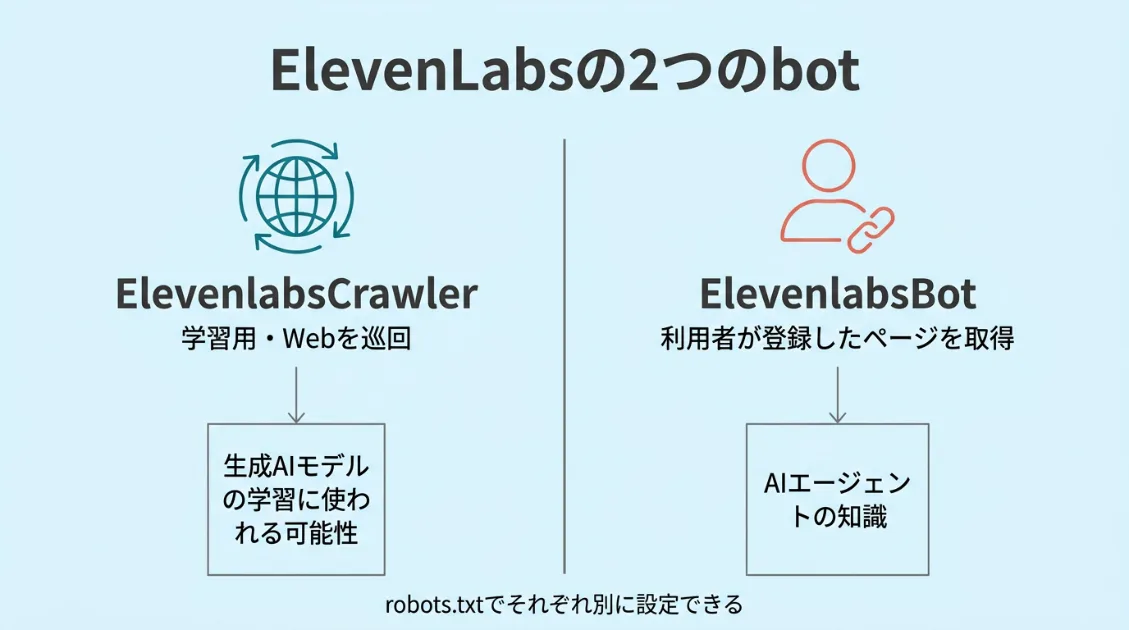
音声AIの会社がWebサイトを読みに来ると聞くと意外に感じますが、ElevenLabsは公式ページで、目的の違う2つのbotを公開しています。
ElevenlabsCrawlerとElevenlabsBotの違い
| ElevenlabsCrawler | ElevenlabsBot | |
|---|---|---|
| 目的 | 生成AIモデルの学習に使われる可能性のあるコンテンツを集める | ElevenLabsの利用者が、AIエージェントの知識として登録したページを取得する |
| 取りに来るタイミング | Webを巡回して集める | ページが登録されたときと、情報を更新するとき |
| User-Agentに含まれる識別名 | ElevenlabsCrawler/1.0 |
ElevenlabsBot/1.0 |
| robots.txtでの名前 | ElevenlabsCrawler |
ElevenlabsBot |
| AI観測ラボの10月のログ | 671件 | 0件 |
671件は10月全体のリクエスト数で、28日〜29日の669件と、31日の2件を合わせたものです。
2つのbotは、robots.txtでそれぞれ別に許可・拒否を決められます。たとえば、AIの学習には使われたくないが、ElevenLabsの利用者が自分のAIエージェントにサイトを登録したときは読んでもらいたい、という場合は、ElevenlabsCrawlerだけを止めることができます。止め方は、後半のセクションで説明します。
音声AIの会社が、なぜ文章のサイトを読むのか
公式ページの説明では、生成AIモデルの学習に使われる可能性のあるコンテンツを集めるためです。ただし、どのモデルに、どのように使うのかまでは書かれていません。
ElevenLabsが公開しているWebクローラー担当エンジニアの求人には、最先端のAIモデルのための大規模なWebクローリングを担当し、音声・動画・多言語のコンテンツに特に力を入れて、学習にすぐ使えるデータセットを作る、という仕事内容が書かれています。
ただし、求人は会社のデータ収集方針を示す情報で、今回取得された記事の用途まではわかりません。
海外でも観測例:10月25日に1,885件を記録
ElevenlabsCrawlerは、AI観測ラボだけに来ているわけではありません。クローラーの訪問を記録している海外の観測サイトThe Crawler Zooでは、同サイトでの初観測は2026年10月25日で、ほぼ1日で1,885件のアクセスがあったと報告されています。AI観測ラボで記録したのは、3日後の10月28日でした。
いつ来て、何にアクセスした?
AI観測ラボのサーバーログで、ElevenlabsCrawlerを名乗るアクセスが記録されたのは、2026年10月28日・29日・31日の3日間でした。28日の夜から29日の未明にかけての大きな集中取得と、31日の少数の再訪に分かれます。集計の範囲によって件数が変わるため、先に数え方をまとめます。
| 集計の範囲(10月全体) | リクエスト | URLの種類 |
|---|---|---|
| 全リクエスト | 671件 | 592種類 |
| robots.txt・サイトマップ・llms.txt・/embed/ を除いたページ | 654件 | 583種類 |
| うち、本文を返した(200) | 537件 | 534種類 |
31日にアクセスしたページは、28日〜29日にもアクセス済みのURLでした。28日〜29日だけで数えても、ページへのアクセスは583種類です。
10月28日の夜、約3時間に集中していた
| 時間帯(日本時間) | 全リクエスト | 動き |
|---|---|---|
| 10月28日 22時台 | 72件 | 22時36分にrobots.txtを取得。22時53分から本格的にアクセス開始 |
| 10月28日 23時台 | 304件 | 最も多い時間帯 |
| 10月29日 0時台 | 287件 | 0時00分と0時10分の各1分間に62件 |
| 10月29日 1時台 | 6件 | 1時57分を最後に終了 |
| 10月31日 16時台 | 2件 | robots.txtと記事1本へのアクセス |
10月のElevenlabsCrawlerを名乗る全671件のうち、669件が10月28日22時36分から29日1時57分までの約3時間20分に集中していました。中でも23時台と0時台の2時間で591件です。
ClaudeBotやGPTBotにも、普段は静かで、ときどき一気に読みに来る動き方があります。ElevenlabsCrawlerも、今回のログでは同じような集中型の取得でした。ですが、AI観測ラボで大規模な集中取得を観測したのは1回だけのため、定期的に来るのかどうかは、11月以降のログで確認します。
タグページと記事に広くアクセス
ページへのリクエスト654件を、ページの種類ごとに分けると次のとおりです。
| ページの種類 | リクエスト |
|---|---|
| タグページ | 308件 |
| 記事 | 297件 |
| ページ送り(2ページ目以降の一覧) | 27件 |
| カテゴリページ | 20件 |
| トップページ | 2件 |
返答の内訳は、200(成功)が537件、301(別のURLへの転送)が86件、404(ページが見つからない)が31件でした。200を返したページは537件・534種類で、同じURLへの成功したリクエストは、ほぼ1回ずつでした。タグページが全体の約47%を占めている点は、AI観測ラボで観測してきたGPTBotやClaudeBotのバーストとも共通しています。
画像・CSS・JavaScriptを併せて取得する動きは記録されなかった
今回確認できたのは、記事や一覧ページへのアクセスが中心で、画像・CSS・JavaScriptを併せて取得する動きは記録されなかったということです。ブラウザで人がページを開くと、ページ本体と一緒に画像やCSSも読み込まれますが、ElevenlabsCrawlerのアクセスにはそれが見られませんでした。
ほかに、AIに向けてサイトの案内を書くファイル llms.txt にも、10月29日0時2分に1回アクセスしており、サーバーは正常に応答(200)していました。アクセスしたことは確認できますが、内容をどう使ったかまでは、ログからはわかりません。
どうやって読みに来た?
ElevenlabsCrawlerのアクセスを時刻順に並べると、robots.txtやサイトマップへのアクセスの流れと、IPアドレスごとのアクセスが短い時間に集中している様子が見えてきました。
robots.txtへのアクセスに続き、サイトマップも取得
10月28日のアクセスは、次の順番で始まっていました。
176.117.90.175 - - [28/Oct/2026:22:36:57 +0900] "GET /robots.txt HTTP/1.1" 200 863
176.117.90.175 - - [28/Oct/2026:22:36:58 +0900] "GET /meta-webindexer/ HTTP/1.1" 200 20112
180.149.25.243 - - [28/Oct/2026:22:53:42 +0900] "GET /robots.txt HTTP/1.1" 200 863
180.149.25.243 - - [28/Oct/2026:22:53:45 +0900] "GET /sitemap.xml HTTP/1.1" 404 13903
89.40.108.96 - - [28/Oct/2026:22:53:51 +0900] "GET /sitemap_index.xml HTTP/1.1" 200 298
89.40.108.96 - - [28/Oct/2026:22:53:54 +0900] "GET /post-sitemap.xml HTTP/1.1" 200 8817
89.40.108.96 - - [28/Oct/2026:22:53:55 +0900] "GET /category-sitemap.xml HTTP/1.1" 200 454
(抜粋。User-Agentはすべて ElevenlabsCrawler/1.0)
流れは2段階に分かれていました。22時36分には、robots.txtへのアクセスの直後に、記事を含む3つのURLへアクセスしています。22時53分からは、もう一度robots.txtへアクセスしたあと、/sitemap.xml を探して404(見つからない)が返り、続いて /sitemap_index.xml と、記事・カテゴリ・固定ページ・投稿者の各サイトマップへ、数秒おきに順番にアクセスしていました。
robots.txtへのアクセスが記録されたのは、10月28日の2回と31日の1回だけでした。robots.txtにアクセスしたことと、robots.txtの指示を守ったかどうかは別の話で、アクセスの記録だけでは判断できません。
各IPアドレスからのアクセスは、1分以内に集中
ElevenlabsCrawlerのアクセス元のIPアドレスは、10月全体で29個ありました。IPアドレスごとに、最初と最後のアクセスの時刻を並べると次のとおりです。
| IPアドレス | 最初〜最後のアクセス(日本時間) | 時間差 | リクエスト |
|---|---|---|---|
| 202.81.222.199 | 10月28日 22:54:03〜22:55:02 | 59秒 | 51件 |
| 66.95.202.25 | 10月28日 23:39:48〜23:40:46 | 58秒 | 48件 |
| 151.245.51.232 | 10月28日 23:50:59〜23:51:56 | 57秒 | 54件 |
| 94.176.84.236 | 10月29日 0:00:12〜0:01:10 | 58秒 | 56件 |
| 9.249.182.177 | 10月29日 0:10:27〜0:11:25 | 58秒 | 56件 |
10月28日〜29日に記録された28個のIPアドレスは、どれも最初のアクセスから最後のアクセスまでが59秒以内でした。1秒に1件ほどのペースで、1つのIPアドレスから最大56件のアクセスがあり、同じIPアドレスが時間をおいて再び現れることはありませんでした。各IPアドレスからのアクセスは短時間に集中し、時間帯ごとに異なるIPアドレスが記録されていました。
10分単位で集計すると、同じ区間に記録されたIPアドレスは最大5個でした。約3時間20分の取得時間の中でも、アクセスが続いていたのは、22時53分〜55分、23時39分〜54分、0時00分〜11分など、いくつかの短い時間帯です。アクセス元は、9.249.x.x、94.176.x.x、151.245.x.x など、複数の異なるIPアドレス帯に分かれていました。
IPアドレスごとに見ると、1つのIPアドレスからの件数は少なく見えます。User-Agentでまとめて数えて、初めて約3時間20分で669件という集中した取得の全体像が見えました。
現在存在しないURLにもアクセス
ページへのリクエストのうち31件には、404(ページが見つからない)が返っていました。アクセスしたURLには、/noindex-gptbot や /ai-crawler-robots-txt のように、現在のAI観測ラボには存在しないURLが含まれています。
中には、/ai-old-information/【URL】 のように、記事のURLの後ろに「【URL】」という文字が付いたものもありました。
現在のサイトマップにないURLへのアクセスも記録されました。AIが実際に考えたURL配列だったら面白いなと思った一方、過去のサイトマップやページ内のリンク、外部サイトなど、どこからURLを得たかはログだけではわかりません。
💡 自分のログでElevenlabsCrawlerを探すときのポイント
- User-Agentでまとめて数える:AI観測ラボのログでは、各IPアドレスからのアクセスが1分以内に集中し、時間帯ごとに異なるIPアドレスが記録されていました。IPアドレス単位で見ると見落としやすいため、
ElevenlabsCrawlerという文字列で検索して、まとめて数えます - 短い時間帯に集中していないかを見る:AI観測ラボでは、10月の671件のうち669件が約3時間20分に集中していました。1日の合計だけでなく、時間帯ごとの件数も確認します
- 404の中身も見る:存在しないURLへのアクセスが多い場合は、古いURLの転送が切れていないかを見直すきっかけにもなります
本物かどうかは確かめられる?
User-Agentは、アクセスしてくるプログラムが自分で名乗る名前です。9月の観測レポートで紹介したように、AIクローラーの名前を名乗りながら設定ファイルを探すスキャナーもいるため、名前だけでは運営元を確認できません。
公式ページには、運営元を確かめる方法の記載がない
大手のAIクローラーの多くは、本物かどうかを確かめる手段を公式資料で案内しています。ElevenlabsCrawlerと、AI観測ラボで観測してきたほかのクローラーを比べると、次のとおりです。
| クローラー | 公式のIPアドレス一覧 | リクエストの署名 |
|---|---|---|
| ClaudeBot | あり | — |
| ShapBot | あり | あり |
| ExaSearchBot | — | あり |
| ElevenlabsCrawler | — | — |
「—」は、今回確認した公式資料では記載を確認できなかった項目です。確認日:2026年11月2日。
ElevenLabsの公式ページに掲載されているのは、User-Agent、用途、robots.txtによる設定方法で、IPアドレスの一覧や、本物かどうかを確かめる方法は記載されていません。海外の観測サイトThe Crawler Zooでも、照合できる運営元の情報がないため、身元は確認できないと説明されています。
ログから言えること、今回のログでは確認できないこと
| ログから言えること | 今回のログでは確認できないこと |
|---|---|
| User-Agentは、公式ページに書かれた文字列と一致していた | アクセスがElevenLabsから届いたものかどうか |
| robots.txtとサイトマップへアクセスしていた | robots.txtの指示を守っているかどうか |
| アクセス先は記事・一覧ページ・サイトマップで、設定ファイルや管理画面を探すアクセスは記録されなかった | 取得したページが、実際に学習に使われたかどうか |
設定ファイルを探すような動きがなかったことは、9月のスキャナーとは違う点です。とはいえ、動き方が普通のクローラーらしいことだけでは、本物と確認できません。
AI観測ラボでは、今回のアクセスを「公式のUser-Agentと一致するが、今回のログでは運営元を確認できていない」ものとして記録します。ElevenLabsがIPアドレスの一覧や署名の仕組みを公開した場合は、改めて照合します。
💡 確かめる手段がないクローラーとの付き合い方
- User-Agentの文字列を細かく見比べる:名前の部分だけでなく、公式ページに書かれた文字列全体と一致しているかを確認します。ただし、一致しても運営元の証明にはなりません
- アクセス先を見る:記事やサイトマップではなく、
.envや管理画面を探しているアクセスは、名前に関係なく警戒します - 本物かどうかを確認できなくても、アクセスは制限できる:robots.txtは、指示を守るクローラーに対して巡回を断る方法です。サーバーやWAF(Webサイト向けの防火壁)では、User-Agentに「ElevenlabsCrawler」を含むリクエストを拒否できます。ただし、別の名前を名乗るアクセスまで防ぐものではありません。詳しくは次のセクションで説明します
止めたいときはどうする?
ElevenlabsCrawlerを止めるかどうかは、サイトごとの判断です。ElevenLabsの公式ページでは、ElevenlabsCrawlerを拒否すると、サイトのコンテンツを学習に使わないでほしいという意思表示になると説明されています。止め方は、robots.txtで断る方法と、サーバーやWAFで拒否する方法の2つです。
robots.txtで断る
サイト全体への巡回を断る場合は、robots.txtに次のように書きます。
User-agent: ElevenlabsCrawler
Disallow: /特定のフォルダだけを断る場合は、Disallow にパスを書きます。
User-agent: ElevenlabsCrawler
Disallow: /members/公式ページによると、robots.txtの変更は約24時間以内に反映されます。
前半で紹介したとおり、ElevenlabsCrawlerとElevenlabsBotは別々に設定できます。学習用の巡回だけを断り、利用者がAIエージェントに登録したページの取得は許可したい場合は、次のように書き分けます。
User-agent: ElevenlabsCrawler
Disallow: /

User-agent: ElevenlabsBot
Allow: /
robots.txtでは、特定のbot専用のグループを書くと、通常は User-agent: * に書いた制限を引き継ぎません。既存のrobots.txtで非公開にしたいパスを指定している場合は、ElevenlabsBot側にも必要な制限を残してください。
robots.txtは、指示を守るクローラーに対して巡回を断る方法です。また、robots.txtで断るのはこれからの巡回で、すでに取得された内容の扱いについては、公式ページに記載がありません。robots.txtの書き方はrobots.txt完全ガイド【2026年版】で詳しく解説しています。
サーバーやWAFで拒否する
robots.txtの指示を守るかどうかに関係なく、User-Agentに「ElevenlabsCrawler」を含むリクエストを拒否したい場合は、サーバーの設定で止めます。Apacheなど、.htaccess で mod_rewrite を利用できる環境では、次の設定で403(アクセス禁止)を返せます。
RewriteEngine On
RewriteCond %{HTTP_USER_AGENT} ElevenlabsCrawler [NC]
RewriteRule .* - [F,L]WordPressでは、.htaccess にWordPress自身の設定も書かれています。編集する前に必ずバックアップをとり、WordPressの設定(# BEGIN WordPress の行)より上に書き足します。レンタルサーバーの管理画面のWAFやアクセス制限に、User-Agentを条件に指定できる機能がある場合は、その機能で拒否することもできます。
どちらの方法も、別の名前を名乗るアクセスまで防ぐものではありません。
補足:aiprefは巡回拒否とは別の設定
AI観測ラボでは、10月31日から、robots.txtでAI学習への利用を断る意思を示す仕組み「aipref」を試しています。10月31日に、robots.txtへ、特定の1ページについて学習への利用を断る設定を追加しました。
サーバーログでは、robots.txtの応答サイズは、10月31日の13時台を境に変わっていました。ElevenlabsCrawlerは、応答サイズが変わったあとの16時4分にrobots.txtへアクセスし、続けて記事1本にアクセスしています。アクセスした記事は、aiprefの設定を追加したページとは別のページです。
aiprefは、学習への利用についての希望を伝えるもので、巡回そのものを止める仕組みではありません。アクセスが続いたことだけでは、ElevenlabsCrawlerが設定を解釈したかどうかも、取得した内容を学習に使ったかどうかも判断できません。aiprefの実験の結果は、11月末に設定前後のログを比べて、別の記事で紹介する予定です。
💡 止める前に考えたいこと
- 止めたいのは「学習」か「すべてのアクセス」か:学習だけを断りたいならElevenlabsCrawlerだけを止め、ElevenlabsBotは許可する、という選び方もできます
- robots.txtとサーバー設定の違い:robots.txtは指示を守るクローラーへのお願い、サーバー設定はUser-Agentを指定した拒否です。どちらも、別の名前を名乗るアクセスは防げません
- 止めたあとも、ログで確認する:robots.txtで断った場合は、公式の目安である約24時間が過ぎてから、禁止したページへのアクセスが続いていないかを確認します。サーバーやWAFで拒否した場合は、対象のリクエストが403などで拒否されているかを確認します
まとめ:ElevenlabsCrawlerは、名前と動きを分けて見る
ElevenlabsCrawlerは、音声AIで知られるElevenLabsが、生成AIモデルの学習に使われる可能性のあるコンテンツを集めるためのクローラーです。AI観測ラボのログでは、音声ではなく、記事やタグページなど文章中心のページへのアクセスが記録されました。
- ✓ ElevenLabsは、学習用のElevenlabsCrawlerと、利用者がAIエージェントに登録したページを取得するElevenlabsBotを分けて公開しており、robots.txtでそれぞれ別に設定できる
- ✓ AI観測ラボでは、10月28日〜29日の約3時間20分に669件のリクエストを記録。記事やタグページなど583種類のURLにアクセスし、画像・CSS・JavaScriptを併せて取得する動きは記録されなかった
- ✓ 各IPアドレスからのアクセスは59秒以内に集中し、時間帯ごとに異なるIPアドレスが記録された。User-Agentでまとめて数えないと、全体像が見えにくい
- ✓ 公式ページには、IPアドレスの一覧や運営元を確かめる方法の記載がない。今回のアクセスは「公式のUser-Agentと一致するが、運営元は確認できていない」
- ✓ 止めたい場合は、robots.txtで断る方法と、サーバーやWAFでUser-Agentを指定して拒否する方法がある。どちらも、別の名前を名乗るアクセスまでは防げない
ElevenlabsCrawlerのように、運営元を確かめる手段が公式ページで案内されていないクローラーは、名前だけで判断せず、アクセス先・時間帯・返答を、自分のログで確かめることが出発点になります。
今後観測すること
- 集中取得は繰り返されるか:10月28日〜29日のような集中取得が、間隔をあけて再び起きるかを、11月以降のログで確認します
- ElevenlabsBotは来るか:10月は0件でした。利用者がAIエージェントにAI観測ラボのページを登録したときのアクセスが記録されるかを見ます
- aiprefの設定前後で、アクセスは変わるか:設定を追加したページへのアクセスと、robots.txtへのアクセスを、11月末に比べます。
関連記事
- AIクローラー観測レポート 2026年10月|AIの裏方が増え、開発環境が狙われた月
- robots.txt完全ガイド【2026年版】156件の実測ログで分かったAIクローラーの正しい制御方法
- AIエージェントのUser-Agentまとめ—識別できる4種・Chromeに化ける3種
- robots.txtで「AI学習に使わないで」と伝えられる?IETFのaiprefをやさしく解説
- ChatGPT-Userを名乗る偽クローラーをログで発見した|本物との見分け方

AIクローラーを視覚化する
AI Kansoku Lab Tracker
GPTBot、ClaudeBot、PerplexityBotなど、WordPressサイトに訪問したAIクローラーを記録できる無料プラグインです。
あなたのサイトは、
AIに見えていますか?
URLを入力するだけで30秒。8項目を自動診断し、優先度別の改善プランを提示します。完全無料・登録不要。