MetaのAI「Muse」はサイトのどこまで見る?使ってみてわかったこと
2026年9月、Metaが人の代わりにWebサイトを見たり操作したりするAI「Muse」を米国で公開しました。ページの要約やリンクのクリックを頼むと、Museが自分でサイトを開いて作業してくれます。
サイト運営者として気になるのは、Museが自分のサイトのどこまで見ていくのかです。文章だけを読むのか、画像まで見るのか。サーバーのログには何と残るのか。
AI観測ラボでは以前、Metaのクローラー5種類とMuseを56日分のサーバーログで調べました。ところが、Museのアクセスはふつうの人のアクセスと区別できず、見つけられないまま終わっていました。
今回はMuseを筆者のスマホにインストールし、AI観測ラボの記事を実際に開かせてみました。開かせた時刻とURLがわかっているので、サーバーログと1件ずつ照らし合わせることができます。
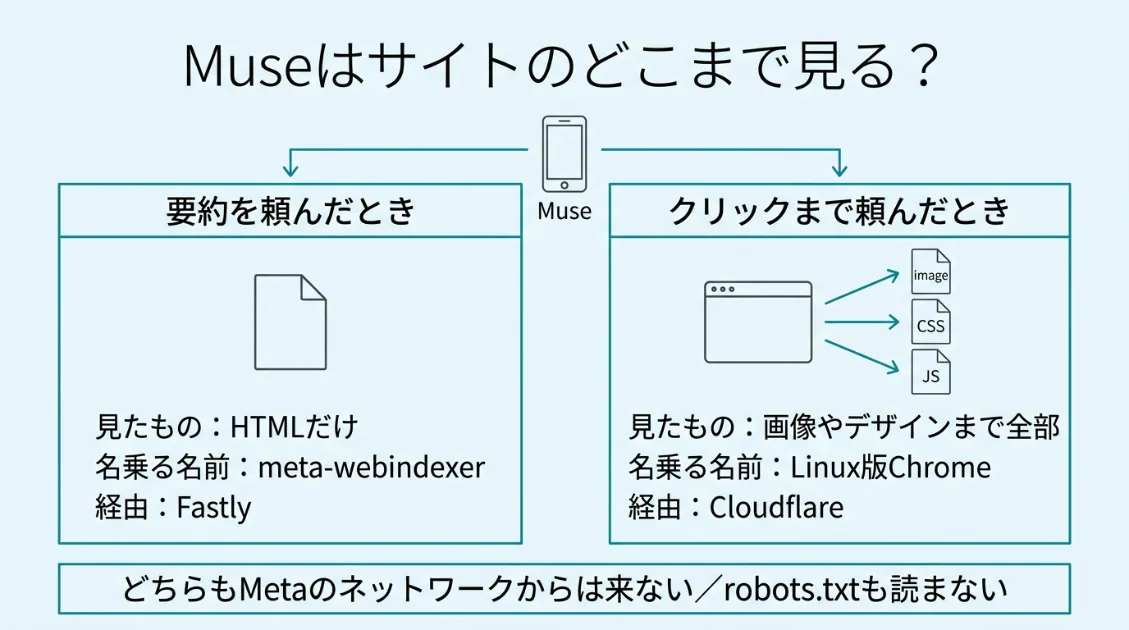
結果、Museがどこまで見るかは、頼んだ作業によってまったく違いました。要約だけを頼んだときは、Metaのクローラー「meta-webindexer」を名乗り、本文のHTMLだけを取得しました。クリックまで頼んだときは、名前を名乗らないふつうのChromeとして、画像やCSSまでまるごと読み込みました。しかも、どちらのアクセスもMetaのIPアドレスからではありませんでした。
本記事では、実験で残ったログを公開しながら、Museがサイトのどこまで見るのか、サイト運営者は見分けたり止めたりできるのかを整理します。
この記事でわかること|📖:約10分
- Museに記事を「要約させた」ときと「クリックさせた」ときで、サイトのどこまで見るか、ログに残る名前がどう変わるか
- MuseのアクセスがMetaのIPアドレスから来ていなかったことと、IPアドレスで本物を見分ける方法が通用しない理由
- スマホのMuseアプリ自身もログに残ることと、アプリを見分ける手がかり「HatchForiOS」
- robots.txtやGoogle アナリティクスで、Museのアクセスがどう扱われるか
結論:Museがどこまで見るかは、頼んだ作業で変わる
Museがサイトのどこまで見るかは、頼んだ作業によって大きく変わりました。要約だけならHTMLを1回取って終わり、クリックまで頼むと画像やデザインのファイルまで全部です。2つの作業で残った足あとを、表で並べます。
| 確認した項目 | 要約を頼んだとき | クリックまで頼んだとき |
|---|---|---|
| どこまで見た? | HTMLだけ(1回・約30KB) | HTML・CSS・JavaScript・画像・ファビコンまで全部 |
| 名乗った名前(UA) | meta-webindexer/1.1 | Linux版Chrome 155(ふつうのブラウザと同じ形) |
| アクセス元のネットワーク | Fastly(AS394192) | Cloudflare(AS13335) |
| Meta自身のネットワーク(AS32934)から来た? | いいえ | いいえ |
| robots.txtを読みに来た? | 来ていない | 来ていない |
| Google アナリティクスでの見え方 | HTMLしか取得していないため記録されない形 | 人の訪問として数えられた可能性あり |
表から、サイト運営者が知っておきたいポイントは3つです。
- 名前だけでは見分けられません。クリックを頼んだときのMuseはふつうのChromeを名乗るため、アクセスログの上では人の訪問と区別がつきにくくなります。
- Metaの公式ネットワークから来ません。2つの作業とも、アクセス元はFastlyやCloudflareといった配信サービスでした。前回の記事で紹介した「MetaのIPアドレスで本物か確かめる方法」は、Museには通用しません。
- robots.txtを確認しないまま読みに来ます。今回のログでは、どちらの作業でもrobots.txtへのアクセスは1回もありませんでした。
さらに、スマホのMuseアプリ自身も、リンクのプレビューを作るときに別の名前でアクセスを残していました。くわしくはスマホのMuseアプリもログに残る?で紹介します。ブラウザを名乗るAIの見分け方の全体像は、AIエージェントのユーザーエージェントの見分け方にまとめています。
どうやって確かめた?実験の方法
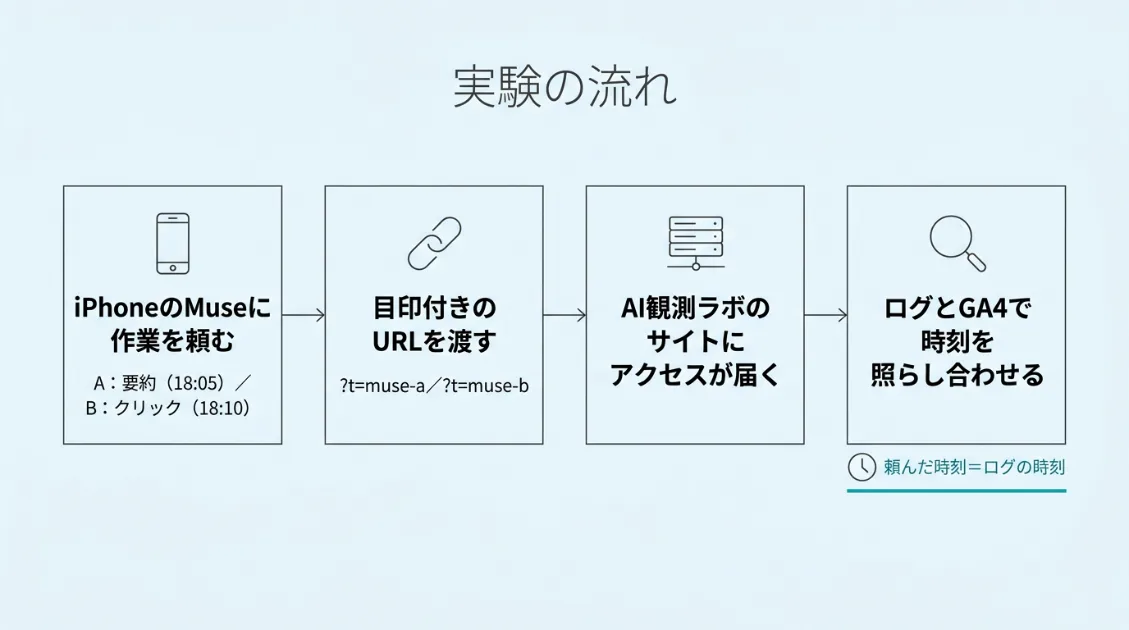
実験は2026年10月26日の夕方に行いました。やり方はシンプルで、Museに作業を頼んだ時刻と、サーバーのログに残った時刻を1件ずつ照らし合わせるだけです。
使ったもの
- Museアプリ:筆者のiPhoneに入れて使いました(入手方法の詳細は省きます)
- サーバーのアクセスログ:AI観測ラボのサイトに届いたアクセスを、1件ずつ記録したファイルです
- Google アナリティクス(GA4)のリアルタイムレポート:実験直後に、人の訪問として数えられたかを確かめました
頼んだ作業は2つです
| 実験A:要約 | 実験B:クリック | |
|---|---|---|
| 頼んだ時刻 | 18:05 | 18:10 |
| 開かせたページ | /meta-crawlers/ | /ai-old-information/ |
| 頼んだ内容 | 記事の内容を要約してもらう | 記事を開いて、中のリンクを1つクリックしてもらう |
実験Aは「読むだけ」、実験Bは「人と同じようにページを操作する」作業です。作業の重さを変えたとき、Museのサイトへの来方が変わるかを見るために、2つに分けました。
ログで見つけやすくするために、URLに目印を付けました
サイトには毎日たくさんのアクセスが届くため、Museの分だけを探し出すのは大変です。Museのアクセスだけを見分けられるよう、Museに渡すURLの最後に実験用の目印を付けました。
- 実験A:
/meta-crawlers/?t=muse-a - 実験B:
/ai-old-information/?t=muse-b
目印の付いたURLは、Museに渡した以外では使っていません。ログの中にmuse-aやmuse-bが出てきたら、Museが来た証拠になります。
なお、公開するログのうち、筆者の自宅のIPアドレスは一部を伏せています。
要約だけを頼んだとき、Museは何を名乗る?
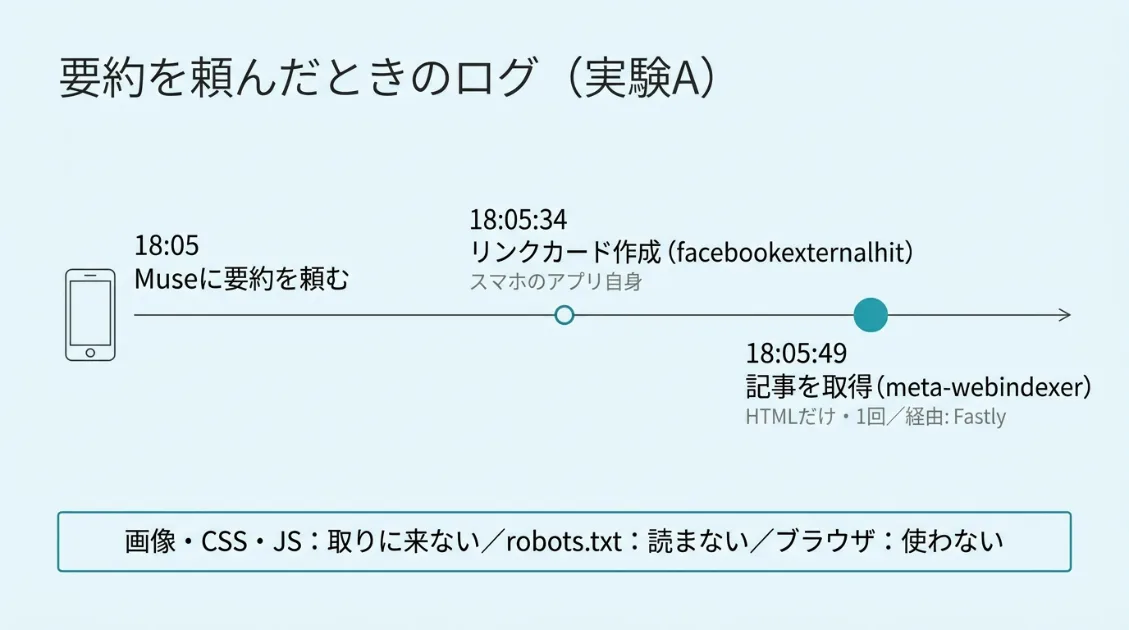
答えは「meta-webindexer」でした。MetaがMeta AIの検索用に使っているクローラーと同じ名前です。Museに要約を頼んでから約15秒後に、目印付きのURLへピンポイントで取りに来ていました。
実験Aで残ったログ
目印「muse-a」でサーバーのログを探すと、2件見つかりました。
153.221.x.x - - [26/Oct/2026:18:05:34 +0900] "GET /meta-crawlers/?t=muse-a HTTP/2.0" 200 26726 "-" "facebookexternalhit/1.1 (+http://www.facebook.com/externalhit_uatext.php)" "-"
87.81.235.77 - - [26/Oct/2026:18:05:49 +0900] "GET /meta-crawlers/?t=muse-a HTTP/2.0" 200 29804 "-" "meta-webindexer/1.1 (+https://developers.facebook.com/docs/sharing/webmasters/crawler)" "-"1件目は、筆者の自宅の回線から来たアクセスです。iPhoneのMuseアプリが、URLのプレビュー(リンクカード)を作るために取りに来たものでした。くわしくはスマホのMuseアプリもログに残る?で説明します。
Museが記事を読むために取りに来たのは、2件目のmeta-webindexerです。
ログからわかることは3つです
- HTMLを1回取っただけでした。取得したのは記事のHTML(29,804バイト)だけで、画像・CSS・JavaScriptには一切アクセスしていません。人がページを開くときのような読み込みはありませんでした。
- ブラウザは使っていませんでした。同じ時間帯のログを探しても、Linux版Chromeなどのブラウザからのアクセスはありませんでした。robots.txtも読みに来ていません。
- アクセス元はMetaではなくFastlyでした。IPアドレス87.81.235.77の持ち主を調べると、配信サービスのFastly(AS394192)でした。Metaのクローラーが普段使っているMeta自身のネットワーク(AS32934)ではありません。
Museの要約は、記事の内容どおりでした
Museが返してきた要約は、Metaのクローラー5種類の役割、Museには専用の名前がないこと、56日間の実測の数字まで、記事の内容と合っていました。HTMLを1回取得しただけで、記事をきちんと読めていたことになります。
おもしろいのは、Museが要約した記事の中身です。前回の記事には「Museはふつうのブラウザを操作してサイトを見に行く」と書いていました。ところが、Museが記事を読むときに使ったのはブラウザではなく、meta-webindexerだったわけです。
読むだけの作業なら、ブラウザを動かさずに軽いページ取得で済ませている可能性があります。ですが、1回の実験で確かめられたのは「今回はmeta-webindexerだった」という事実までです。いつも同じ動きになるかは、引き続き観測していきます。
リンクをクリックさせると、何が変わる?
クリックまで頼むと、Museはブラウザを動かしてサイトに来ました。名乗った名前は「Linux版Chrome 155」で、ふつうのパソコンのブラウザとまったく同じ形です。要約のときに来たmeta-webindexerは、実験Bでは1回も来ていません。
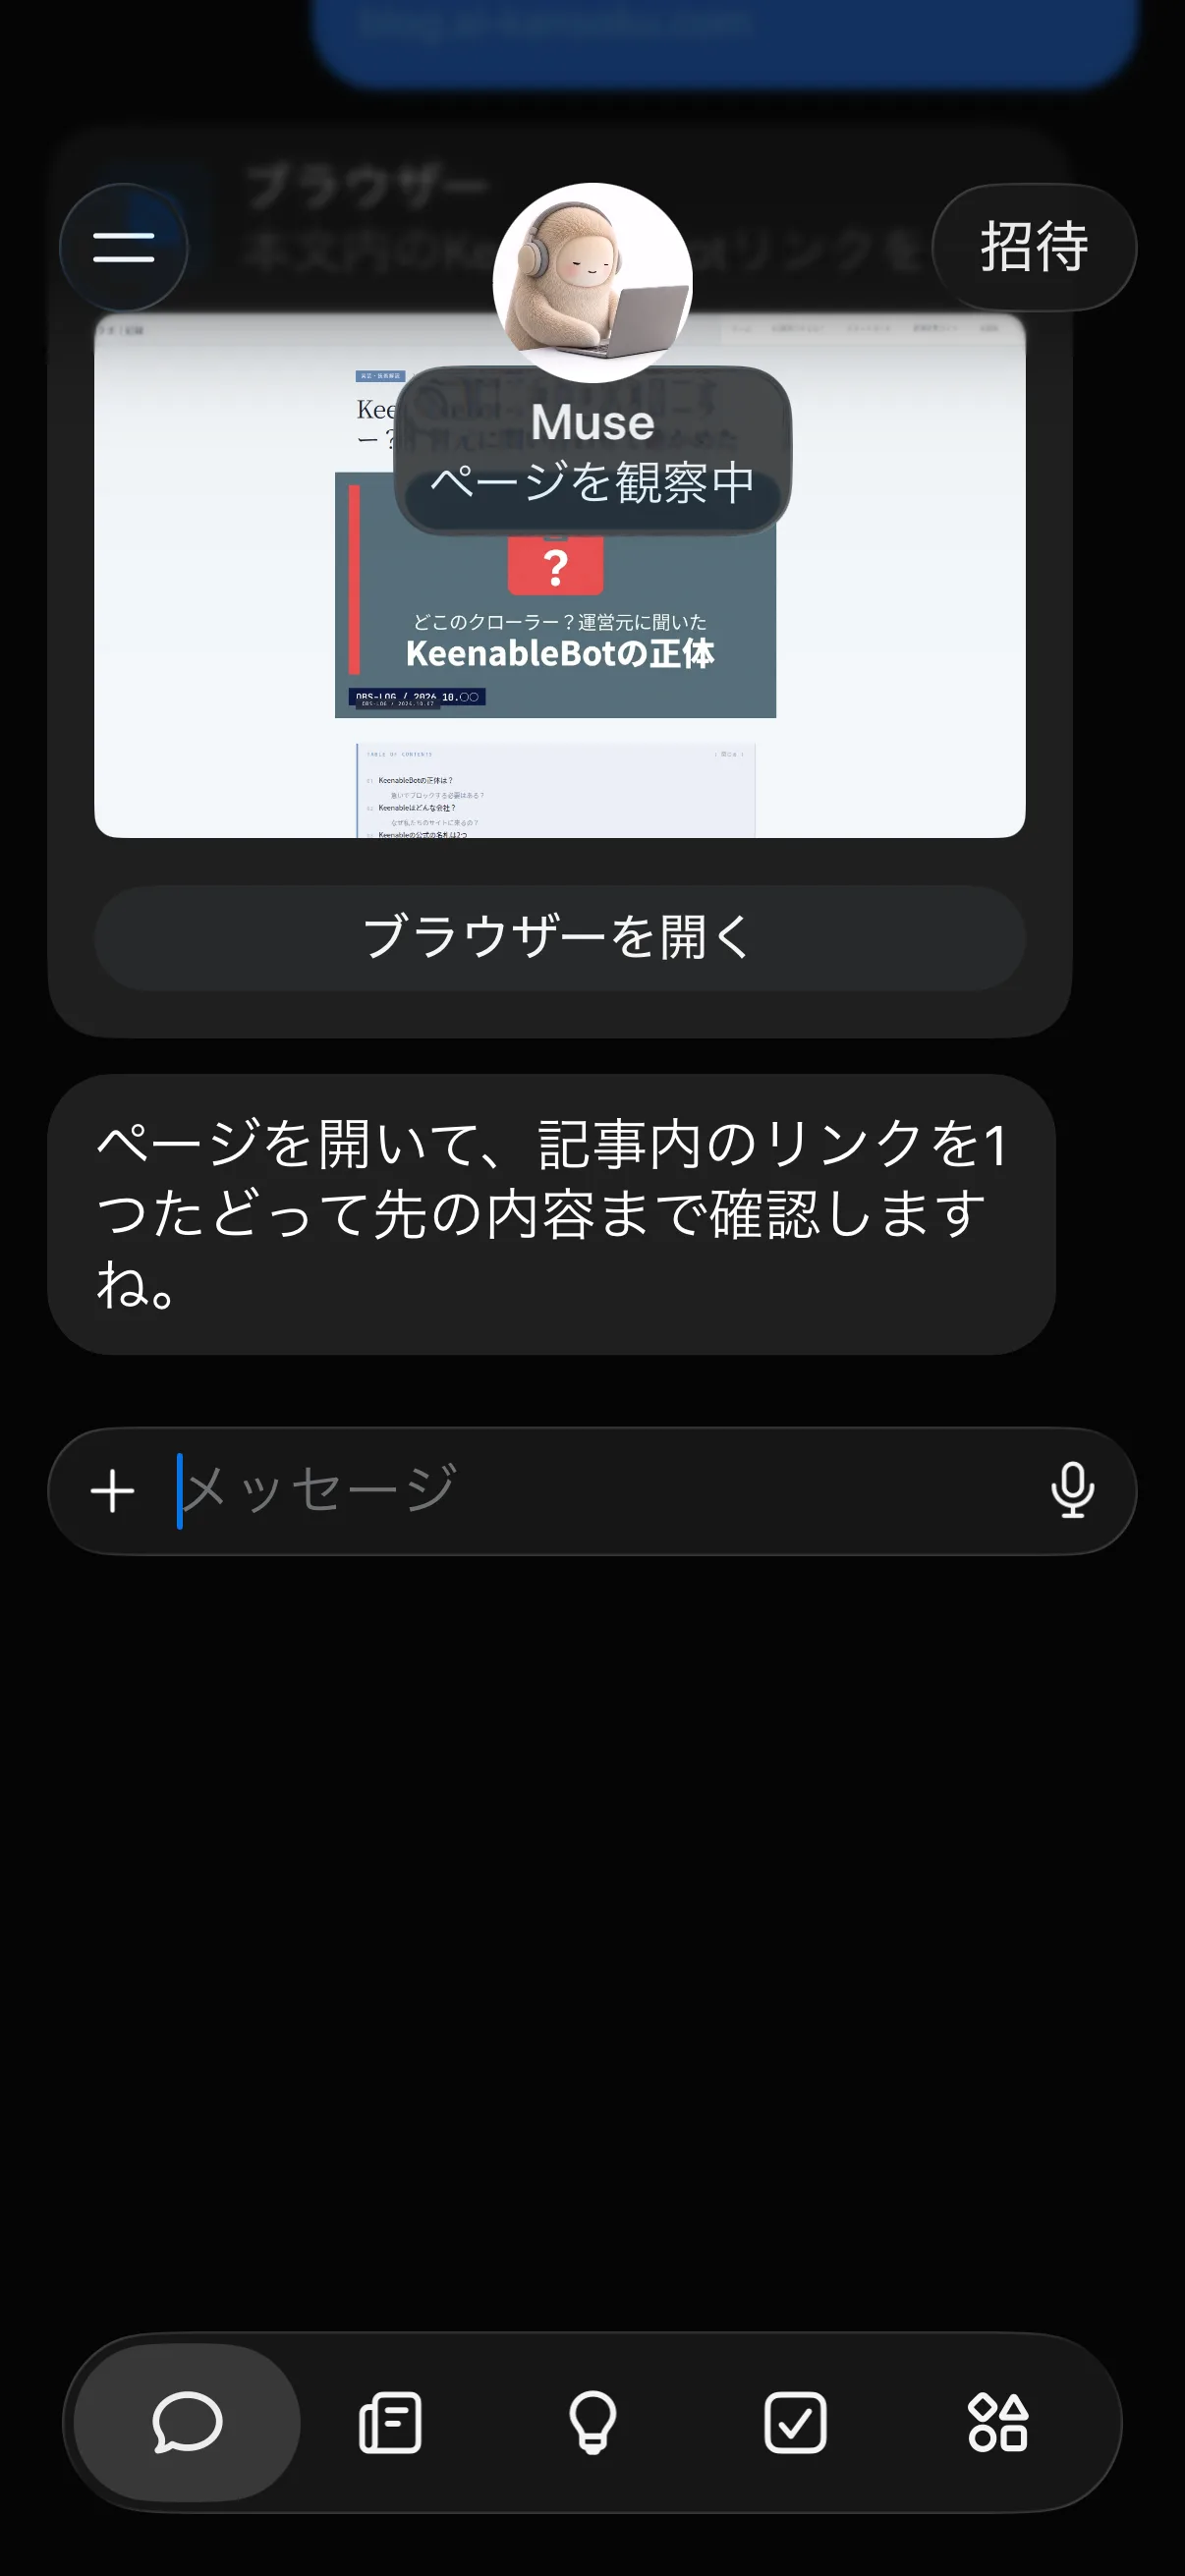
Museの画面には「ページを観察中」と出ていました
実験Bを頼むと、Museは「ページを開いて、記事内のリンクを1つたどって先の内容まで確認しますね」と返事をして、作業を始めました。アプリの画面には、Museが開いているページの様子と「ページを観察中」の表示が出ています。「ブラウザーを開く」を押すと、Museが操作しているブラウザの画面を見ることもできます。
実験Bで残ったログ
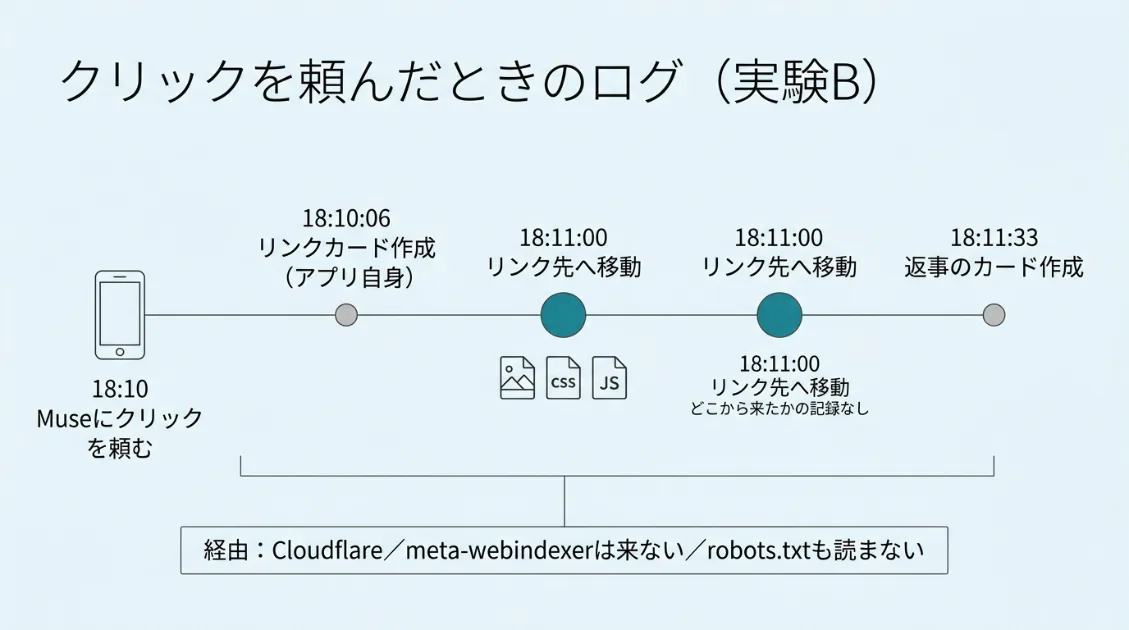
Museに頼んでから、返事が届くまでの約1分半に、ログには次のアクセスが残っていました。
| 時刻 | アクセス元 | 名乗った名前 | 取りに来たもの |
|---|---|---|---|
| 18:10:06 | 筆者の自宅回線 | facebookexternalhit | Museアプリがリンクカードを作るための取得 |
| 18:10:34 | 104.29.207.31(Cloudflare) | Linux版Chrome 155 | /ai-old-information/ のHTML・CSS・JavaScript・画像・ファビコン |
| 18:11:00 | 104.29.207.31(Cloudflare) | Linux版Chrome 155 | リンク先の /keenablebot/ と画像 |
| 18:11:33 | 筆者の自宅回線 | facebookexternalhit | Museの返事に入ったリンクのカード作成 |
Museのブラウザ本体は、太字の2行です。頼んでから28秒後に記事を開き、さらに26秒後にリンク先へ移動していました。実際のログの一部はこちらです。
104.29.207.31 - - [26/Oct/2026:18:10:34 +0900] "GET /ai-old-information/?t=muse-b HTTP/2.0" 200 24070 "-" "Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/155.0.0.0 Safari/537.36" "-"
104.29.207.31 - - [26/Oct/2026:18:10:35 +0900] "GET /wp-content/themes/generatepress/assets/css/main.min.css?ver=3.6.1 HTTP/2.0" 200 4666 "https://www.blog.ai-kansoku.com/ai-old-information/?t=muse-b" "Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/155.0.0.0 Safari/537.36" "-"
104.29.207.31 - - [26/Oct/2026:18:10:35 +0900] "GET /wp-content/plugins/google-site-kit/dist/assets/js/googlesitekit-events-provider-content-events-90bacb156ab34fa090db.js HTTP/2.0" 200 3174 "https://www.blog.ai-kansoku.com/ai-old-information/?t=muse-b" "Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/155.0.0.0 Safari/537.36" "-"
104.29.207.31 - - [26/Oct/2026:18:10:35 +0900] "GET /wp-content/uploads/2026/10/ai-old-information-two-ways.webp HTTP/2.0" 200 24060 "https://www.blog.ai-kansoku.com/ai-old-information/?t=muse-b" "Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/155.0.0.0 Safari/537.36" "-"
104.29.207.31 - - [26/Oct/2026:18:11:00 +0900] "GET /keenablebot/ HTTP/2.0" 200 30123 "-" "Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/155.0.0.0 Safari/537.36" "-"
104.29.207.31 - - [26/Oct/2026:18:11:01 +0900] "GET /wp-content/uploads/2026/10/keenablebot-thumbnail.webp HTTP/2.0" 200 18642 "https://www.blog.ai-kansoku.com/keenablebot/" "Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/155.0.0.0 Safari/537.36" "-"
Museのブラウザからのアクセスは、全部で18件でした。1ページ目では、HTMLを開いてから1秒以内に、CSS・JavaScript・画像など13件をまとめて取得しています。上のログは、種類ごとに代表的な行だけを抜き出したものです。
人の訪問とほぼ同じ。ただし気になる点が3つありました
Museのブラウザは、HTMLだけでなく、見た目を整えるCSS、動きをつけるJavaScript、記事の画像まで、人がページを開いたときと同じように読み込んでいました。名前もふつうのChromeなので、1行ずつ見ても人の訪問と区別はつきません。ただ、細かく見ると、次の3つが目に留まりました。
- リンク先のページに「どこから来たか」の情報がありませんでした。ふつうはリンクをクリックすると、移動先のページに「どのページから来たか(リファラー)」が記録されます。ところが /keenablebot/ のHTMLにはリファラーがなく、同じページの画像にはリファラーが付いていました。Museはリンクをクリックしたのではなく、リンクのURLを直接開いた可能性があります。アクセス解析では「内部リンクからの移動」ではなく「直接アクセス」に見えるはずです。
- 2ページ目では、CSSやJavaScriptを取り直していませんでした。/keenablebot/ で取得したのは、HTMLと記事の画像3枚だけです。1ページ目で読み込んだCSSやJavaScriptを、ブラウザの中に保存して使い回したと考えられます。人がふつうのChromeでサイトを見て回るときと同じ動きで、本物のブラウザを動かしていることがわかります。
- robots.txtは読みに来ませんでした。実験Aと同じく、ページを開く前にrobots.txtを確認した記録はありません。
Google アナリティクスでは「人の訪問」に見えた可能性があります
Museのブラウザは、Google アナリティクス(GA4)の計測用JavaScriptまで読み込んでいました。実験直後にGA4のリアルタイムレポートを見ると、/ai-old-information/ の表示回数は2回でした。ログでJavaScriptまで読み込んで同じページを開いていたのは、筆者のiPhoneとMuseのブラウザの2つだけです。
さらに地図には、筆者のいる福岡のほかに東京の点が出ていました。Museのブラウザが使っていたCloudflareのIPアドレスが、日本国内として判定された可能性があります。米国のサービスであるMuseが、GA4では東京の読者に見えているかもしれません。今回はリアルタイムレポートでの観測までなので、確定ではありません。
スマホのMuseアプリもログに残る?
残ります。Museに作業を頼んだとき、サイトに来たのはMuseのブラウザやmeta-webindexerだけではありませんでした。筆者のiPhoneのMuseアプリ自身も、筆者の自宅の回線からサイトにアクセスしていました。
URLを送った瞬間に、アプリがリンクカードを作っていました
MuseにURLを送ると、チャット画面にページのタイトルと画像が入ったリンクカードが表示されます。リンクカードを作るために、アプリがページのHTMLと画像を取りに来ていました。実験Aでは、URLを送った直後の18時5分34秒から35秒にかけて、3件のアクセスが残っています。
153.221.x.x - - [26/Oct/2026:18:05:34 +0900] "GET /meta-crawlers/?t=muse-a HTTP/2.0" 200 26726 "-" "facebookexternalhit/1.1 (+http://www.facebook.com/externalhit_uatext.php)" "-"
153.221.x.x - - [26/Oct/2026:18:05:34 +0900] "GET /wp-content/uploads/2026/09/meta-crawlers-thumbnail.webp HTTP/2.0" 200 37670 "-" "Mozilla/5.0 (iPhone; CPU iPhone OS 26_6_1 like Mac OS X) AppleWebKit/605.1.15 (KHTML, like Gecko) Mobile/23G83 [FBAN/HatchForiOS;FBDV/iPhone18,3;FBMD/iPhone;FBSN/iOS;FBSV/26.6.1;FBSS/3;FBID/phone;FBLC/ja_JP;FBOP/5]" "-"
153.221.x.x - - [26/Oct/2026:18:05:35 +0900] "GET /wp-content/uploads/2026/03/cropped-site-icon.png-180x180.png HTTP/2.0" 200 11405 "-" "Mozilla/5.0 (iPhone; CPU iPhone OS 26_6_1 like Mac OS X) AppleWebKit/605.1.15 (KHTML, like Gecko) Mobile/23G83 [FBAN/HatchForiOS;FBDV/iPhone18,3;FBMD/iPhone;FBSN/iOS;FBSV/26.6.1;FBSS/3;FBID/phone;FBLC/ja_JP;FBOP/5]" "-"
HTMLは「facebookexternalhit」、サムネイル画像とサイトのアイコンはiPhoneのSafariに近い名前で取りに来ていました。1つのリンクカードを作るのに、2種類の名前を使い分けていたことになります。
実験Bでも同じく、URLを送った18時10分6秒にリンクカード用のアクセスがありました。さらに18時11分33秒には、Museの返事に入っていた /keenablebot/ のリンクカードを作るためのアクセスも残っています。URLを送ったときだけでなく、Museが返事の中でリンクを示したときにもアクセスが発生するわけです。
Museアプリを見分ける手がかりは「HatchForiOS」
画像を取りに来たときの名前の最後には、[FBAN/HatchForiOS; …] という部分が付いていました。FBANは、Metaのアプリが自分のアプリ名を書き込む場所です。FacebookのiPhoneアプリならFBAN/FBIOSのように入ります。
Museアプリの場合は「HatchForiOS」でした。「Hatch」は、Museアプリの社内での呼び名である可能性があります。Metaが公式に説明している名前ではないため、確定ではありません。ただ、ログでFBAN/HatchForiOSを探せば、Museアプリからのアクセスを見つける手がかりになります。
名前の中には、iPhoneの機種(FBDV/iPhone18,3)、iOSのバージョン(FBSV/26.6.1)、言語設定(FBLC/ja_JP)も入っていました。サイト側からは、Museを使っている人のiPhoneの機種や言語までわかることになります。
facebookexternalhitなのに、Metaのサーバーから来ていません
サイト運営者として注意したいのは、facebookexternalhitのアクセス元です。facebookexternalhitは本来、FacebookやInstagramにURLが貼られたとき、Metaのサーバーがリンクカード用にページを取りに来るときの名前です。
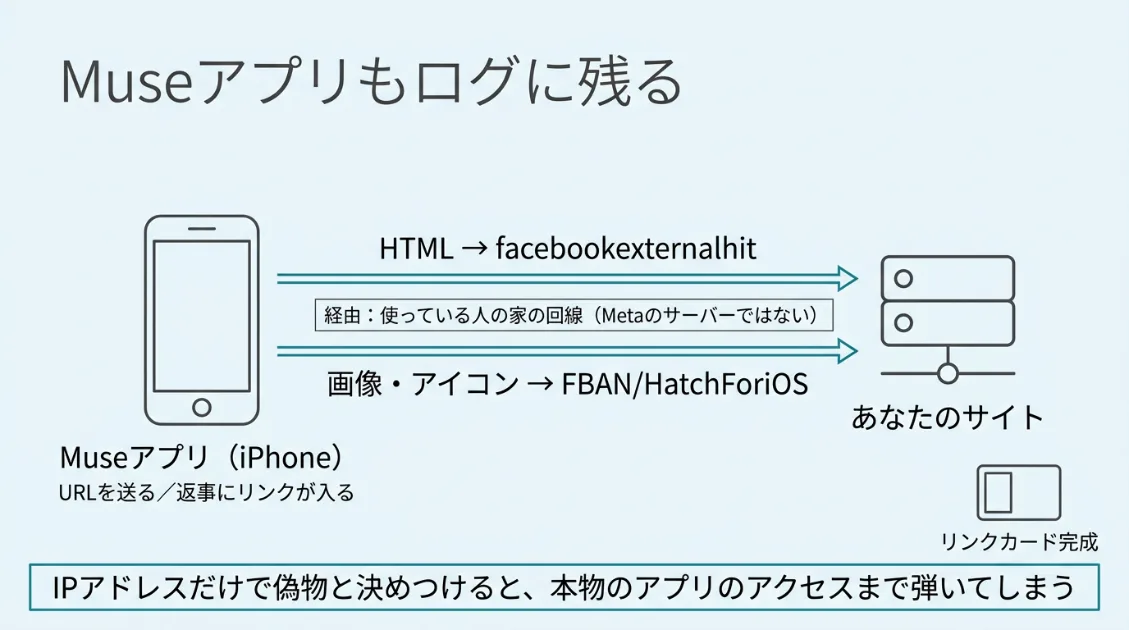
ところがMuseアプリのfacebookexternalhitは、Metaのサーバーではなく、Museを使っている人のスマホから直接来ていました。今回なら、筆者の自宅の回線(NTTドコモビジネスのOCN)です。前回の記事でも、iMessageやLINEがリンクカードを作るときにfacebookexternalhitを名乗る例を紹介しました。Museアプリも同じ仕組みと考えられます。
「facebookexternalhitを名乗っているのにMetaのIPアドレスではない」アクセスは、偽物のクローラーを疑うときの典型的なパターンです。ところがMuseアプリの場合は、本物のMetaのアプリが出したアクセスです。IPアドレスだけで偽物と決めつけると、読者のスマホからの正しいアクセスまで偽物扱いしてしまうことになります。
robots.txtでMuseは止められる?
答えは「一部だけ」です。要約のときに来たmeta-webindexerは、robots.txtで名前を指定して止められる可能性があります。ところが、クリックのときに来たブラウザは、robots.txtでは止められません。
Museは「クローラー」ではなく「人の代わりに動くエージェント」です
robots.txtは、サイトを自動で巡回するクローラーに向けたルールです。クローラーは、運営会社の都合で自分からサイトを集めに来ます。robots.txtで「ここは見ないでください」と書いておけば、ルールを守るクローラーは近づきません。
Museは、来方がまったく違います。人に頼まれて、頼まれたページをその場で開きに来ます。いわば、人がブラウザを操作する代わりを務めるAIです。
| クローラー(GPTBotなど) | Muse | |
|---|---|---|
| 来るきっかけ | 運営会社の都合で自分から巡回 | 人に頼まれたとき |
| 見るページ | サイト全体をたくさん | 頼まれたページだけ |
| 名乗る名前 | 専用の名前(GPTBotなど) | 作業によって変わる。ブラウザのときは名前なし |
| robots.txt | ルールの前提になっている | 前提から外れる場面がある |
Meta自身も、人に頼まれてページを取りに行く仕組みについては、robots.txtのルールを守らない場合があると公式に説明しています。Metaのクローラーの中で、AIエージェントの機能を支えると説明されているのは「meta-externalfetcher」です。人の依頼で動く以上、robots.txtで断られても取りに行くことがある、という立場です。
ただ、今回の実験では、meta-externalfetcherは1回も来ていませんでした。Museが使ったのは、要約のときのmeta-webindexerと、クリックのときの名前のないChromeです。
Museの3つの姿ごとに、robots.txtが効くかを整理しました
| ログに出た姿 | robots.txtで止められる? | 理由 |
|---|---|---|
| meta-webindexer(要約のとき) | 止められる可能性あり | 名前を指定できる。Metaの説明でも、robots.txtを守らない例外は書かれていない |
| Linux版Chrome(クリックのとき) | 止められない | ふつうのブラウザと同じ名前で、robots.txtで指定する名前がない |
| facebookexternalhit・HatchForiOS(アプリのリンクカード) | 止めるのはむずかしい | 使っている人のスマホから直接来るアクセスで、クローラーの巡回とは仕組みが違う |
robots.txtを読みに来なかったのは、無視したから?
今回のログでは、Museのどの姿も、実験中にrobots.txtを読みに来ていません。だがしかし、robots.txtを無視したとは言い切れません。
直近1週間のログで、Metaのアクセスがrobots.txtを読んだ記録を探すと、19件見つかりました。19件とも名乗っていたのはfacebookexternalhitで、meta-webindexerの名前で読んだ記録は1件もありません。
173.252.70.13 - - [26/Oct/2026:08:54:53 +0900] "GET /robots.txt HTTP/2.0" 200 982 "-" "facebookexternalhit/1.1 (+http://www.facebook.com/externalhit_uatext.php)" "-"
173.252.70.8 - - [26/Oct/2026:14:30:21 +0900] "GET /robots.txt HTTP/2.0" 200 982 "-" "facebookexternalhit/1.1 (+http://www.facebook.com/externalhit_uatext.php)" "-"
アクセス元はMeta自身のネットワーク(AS32934)で、ほぼ毎日1〜3回、robots.txtを読みに来ていました。実験の日も、実験の約3時間半前の14時30分に読んでいます。
Metaは、クローラーがrobots.txtの内容を最大24時間保存して使い回すことがあると説明しています。facebookexternalhitが読んだrobots.txtの内容を、meta-webindexerを含むMetaのほかのクローラーにも共有している可能性があります。今回のログで確かめられたのは、「Metaは実験の数時間前にrobots.txtを読んでいた」というところまでです。
そして、クリックのときのChromeは、ふつうのブラウザと同じ名前で来ています。人がブラウザでサイトを見るときと同じく、robots.txtを確認する仕組みそのものがないと考える方が自然です。
meta-webindexerを止めると、Meta AIの引用も止まります
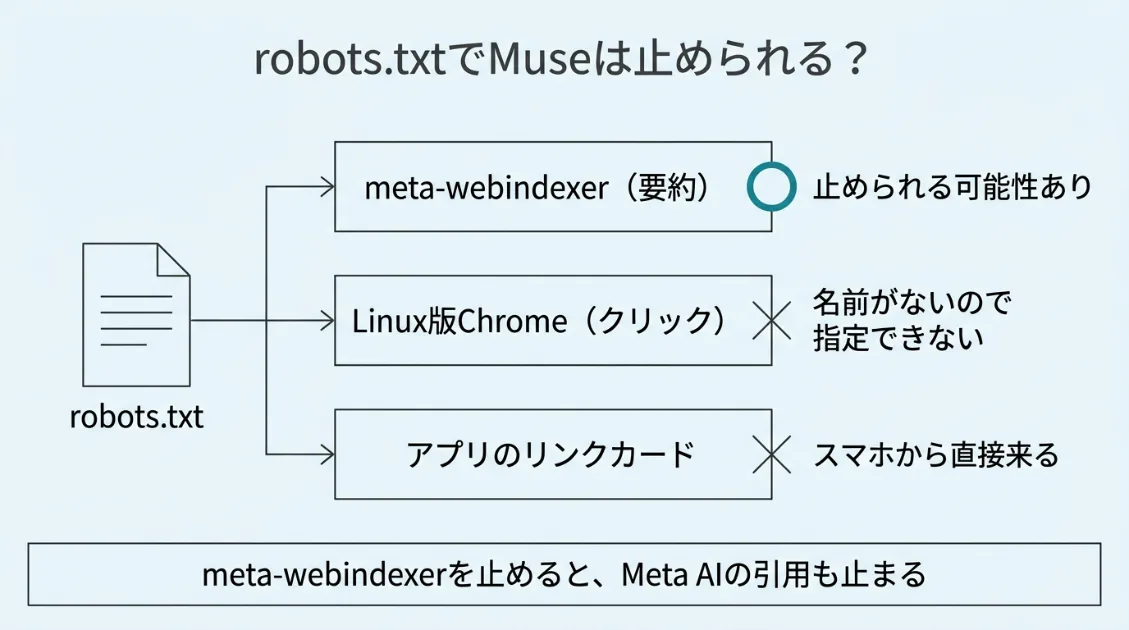
robots.txtでmeta-webindexerを止めれば、Museの要約は防げるかもしれません。ただし、meta-webindexerは、Meta AIの検索結果でサイトを引用したり、リンクを付けたりするためのクローラーでもあります。止めると、Meta AIの回答にサイトが出てくる機会も減ります。
Museだけを止めて、Meta AIの検索には出したい、という使い分けは、今のrobots.txtではできません。Metaのクローラーごとのrobots.txtの書き方は、Metaのクローラーはどれを許可すべき?で目的別にまとめています。
サイト運営者は何をすればいい?
Museを完全に見分けたり、止めたりする方法は、今のところありません。完全には防げない前提で、サイト運営者にできることは大きく4点です。
1. まずは「止める」より「気づける」状態にしておく
Museは、人に頼まれたときにだけ、頼まれたページを見に来ます。サイトに負担をかけるほどの量ではなく、Museを使っている人は、サイトの情報を知りたい読者でもあります。あわてて止めるより、まずはMuseが来ているかに気づけるようにしておくのがおすすめです。
今回の実験で見つかった手がかりは、次の3つです。
| 探すもの | わかること | 確かさ |
|---|---|---|
FBAN/HatchForiOS |
MuseアプリでサイトのURLがやりとりされた | 高い |
meta-webindexer がFastlyなどのIPから1ページだけ取得 |
Museに要約などを頼まれた可能性 | 中くらい |
| Linux版Chromeが、CloudflareなどのIPから画像やCSSをまとめて取得し、次のページにリファラーなしで移動 | Museのブラウザが操作した可能性 | 低い(人の訪問と区別しにくい) |
サーバーのアクセスログを見られる場合は、次のコマンドで1つ目と2つ目の手がかりを探せます。
grep -E "HatchForiOS|meta-webindexer" access_logログの見方に慣れていない場合は、AIエージェントのユーザーエージェントの見分け方から読むのがおすすめです。
2. IPアドレスでの「本物チェック」は、Museには使えません
前回の記事では、Metaを名乗るアクセスが本物かどうかは、IPアドレスがMeta自身のネットワーク(AS32934)かで確かめる方法を紹介しました。meta-externalagentのような、Metaのサーバーから巡回してくるクローラーには、今も有効な方法です。
ところがMuseの場合は、本物のMetaのアクセスでも、Metaのネットワークから来ませんでした。
- 要約のときのmeta-webindexerは、Fastlyから来ていました
- アプリのfacebookexternalhitは、Museを使っている人の家の回線から来ていました
「名前はMetaなのに、IPアドレスがMetaではない」というだけで偽物と決めつけてブロックすると、Museを使っている読者のアクセスまで止めてしまいます。名前とIPアドレスが合わないアクセスは、すぐにブロックせず「要観察」として扱うのが安全です。サイトに大量のアクセスを送ってくる、ログイン画面を何度も狙うなど、行動が怪しい場合にだけ止めるのがおすすめです。
3. Meta AIに引用されたいなら、meta-webindexerは許可のままにする
robots.txtでmeta-webindexerを止めれば、Museの要約を防げる可能性があります。ただし、Meta AIの回答でサイトが引用される機会も一緒に減ります。どちらを選ぶかは、サイトの目的で決めるのがおすすめです。
| サイトの目的 | おすすめの対応 |
|---|---|
| Meta AIやMuseに紹介されたい | meta-webindexerは許可のまま。学習用のmeta-externalagentだけ、必要に応じて止める |
| AIに内容を使われたくない | meta-webindexerもrobots.txtで止める。ただし、Museのブラウザは止められない |
| 会員限定の情報を守りたい | robots.txtではなく、ログインやパスワードで守る |
3つ目は特に大事です。Museのブラウザはrobots.txtで止められないため、人に見せたくない情報は、ログインなどの仕組みで守る必要があります。robots.txtの具体的な書き方は、Metaのクローラーはどれを許可すべき?にまとめています。
4. Google アナリティクスの数字に、AIの訪問が混ざる前提で見る
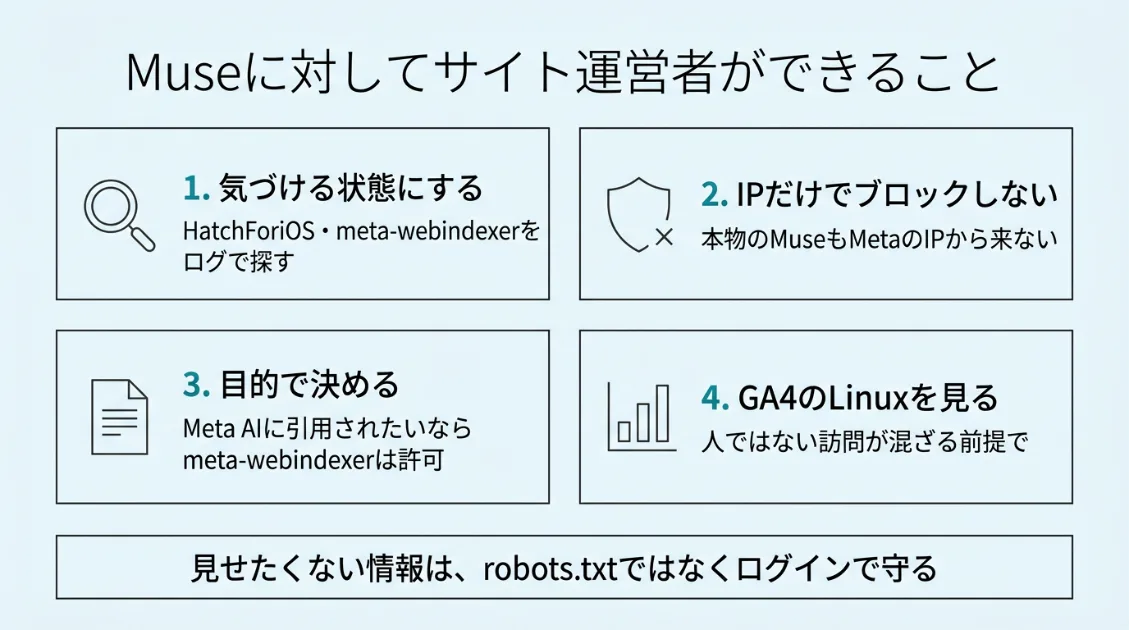
今回の実験では、Museのブラウザが人の訪問としてGA4に数えられた可能性がありました。Museのような人の代わりに動くAIが増えるほど、アクセス数の中に「人ではない訪問」が混ざっていきます。
GA4では、レポートの「オペレーティング システム」で「Linux」を確認しておくと、変化に気づきやすくなります。パソコンのLinuxを使う人はもともと少ないため、Linuxからの訪問が急に増えたり、1回の訪問で何ページも見ていく動きが目立ったりしたら、AIのブラウザが混ざっている可能性があります。
まとめ:Museはサイトのどこまで見る?
MetaのAI「Muse」に、AI観測ラボの記事を実際に開かせてわかったことをまとめます。
- 要約だけなら、HTMLを1回取って終わりでした。名乗った名前はmeta-webindexerで、画像やCSSは見ていません。
- クリックまで頼むと、画像やデザインまで全部見ました。名前のないふつうのChromeとして来て、人の訪問とほぼ同じ読み込み方をしていました。
- スマホのMuseアプリも、リンクカード作りでアクセスを残しました。手がかりは
FBAN/HatchForiOSです。 - どの姿も、Meta自身のネットワークからは来ませんでした。IPアドレスで本物を確かめる方法は、Museには通用しません。
- robots.txtで止められるのは、meta-webindexerだけです。ブラウザで来るMuseは、robots.txtでは止められません。
Museは、サイトを巡回するクローラーではなく、人に頼まれて動くエージェントです。名前でもIPアドレスでもrobots.txtでも、今までのクローラーと同じようには扱えません。
人の代わりにAIがサイトを見に来る場面は、これから確実に増えていきます。アクセス数の中に「AIが人の代わりに見た訪問」が混ざっていく前提で、ログやGoogle アナリティクスを見ていく必要があります。AI観測ラボでは、Museの来方が変わらないかを引き続き観測していきます。

AIクローラーを視覚化する
AI Kansoku Lab Tracker
Museのブラウザは見分けにくくても、名前を名乗るAIクローラーの訪問は記録できます。GPTBot、ClaudeBot、PerplexityBotなど、WordPressサイトに来たAIクローラーを管理画面で確かめられる無料プラグインです。
あなたのサイトは、
AIに見えていますか?
URLを入力するだけで30秒。8項目を自動診断し、優先度別の改善プランを提示します。完全無料・登録不要。