ブログの画像にアクセスするボットは何者?4種類のUAと取得パターンをログで調べた
ブログのアクセスログを見ていて、画像ファイルばかりに並んだ見慣れない名前に気づいたことはありませんか?
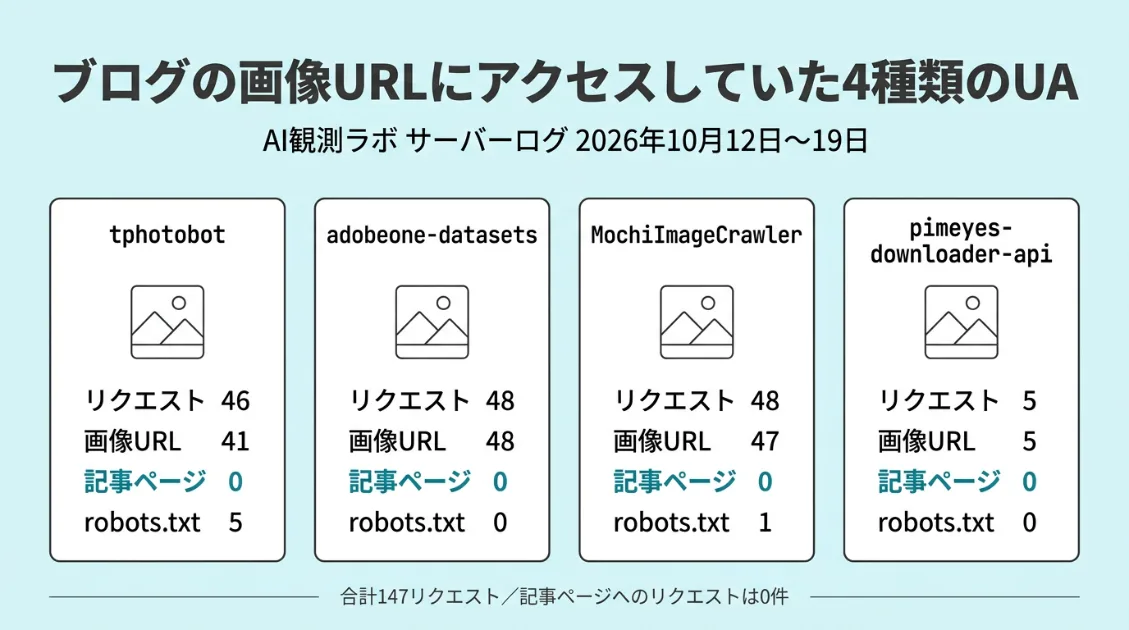
AI観測ラボのサーバーログを2026年10月12日〜19日の8日分確認したところ、ブログの画像URLにアクセスしている見慣れないユーザーエージェント(UA)が4種類見つかりました。観測期間中、4種類とも記事ページ(HTML)へのアクセスは確認されていません。
4種類の中には、運営元が公式ページで用途を説明しているものもあれば、UAの中で用途を名乗っているだけのもの、有名なサービスと同じ名前を含むもの、運営元さえ確認できないものもありました。「何者なのか」について、ログと公開情報からわかる範囲は、ボットごとに大きく異なります。
本記事では、4種類のUAがいつ・どの画像に・どのようにアクセスしたのかを実測ログで整理します。あわせて、自分のサイトで同じアクセスを確認する方法と、制限するかどうかを判断するときの考え方を解説します。
この記事でわかること|📖:約7分
- ブログの画像URLにアクセスしていた4種類のUAと、8日間の実測ログ
- 用途が公式に説明されているもの・名乗っているだけのもの・不明なものの違い
- 自分のサイトで画像へのアクセスをログから確認する方法
- 画像へのアクセスを制限するかどうかの判断のしかた
ブログの画像にだけアクセスしていたUAは4種類
2026年10月12日〜19日のサーバーログ(合計21,449リクエスト)から、画像URLにだけリクエストしていて、記事ページへのリクエストが1件もないUAを探しました。リンクのプレビュー用のUAや、運営元が用途を公表している画像用クローラーなど運営元がはっきりしているUAと、名前を名乗らないUAを除くと、見慣れない名前を名乗るUAが4種類見つかりました。
| UA(名乗っている名前) | リクエスト数 | 画像URL数 (重複除外) |
記事ページへのリクエスト | robots.txtへのリクエスト | 観測日 |
|---|---|---|---|---|---|
| tphotobot/0.1 | 46 | 41 | 0 | 5 | 10月14日 |
| adobeone-datasets/0.1 | 48 | 48※ | 0 | 0 | 10月17日〜19日 |
| MochiImageCrawler/0.1 | 48 | 47 | 0 | 1 | 10月18日〜19日 |
| pimeyes-downloader-api/0.1 | 5 | 5 | 0 | 0 | 10月18日 |
| 合計 | 147 | 141 | 0 | 6 |
※adobeone-datasetsの48件には、404(ファイルが見つからない)となった画像URL 1件を含みます。
※画像URL数の合計(141)は、各UAの件数を足した数です。複数のUAが同じ画像URLにリクエストしていたケースが9件あり、4種類全体で重複を除くと132件になります。
表の「リクエスト数」は、サーバーに届いたファイル取得の回数です。4種類とも、観測期間中、同じUAから同一の画像URLへの複数リクエストは確認されませんでした。
画像URLへの141リクエストのうち、140件はHTTPステータス200(成功)、1件は404(ファイルが見つからない)でした。404はadobeone-datasetsによるアクセスです。robots.txtへの6リクエストは、すべて200でした。
リクエストされた画像URLは、記事のアイキャッチ画像と本文中の図解がほとんどです。「-300×167」「-768×429」のような、WordPressが自動で作る縮小版の画像URLも多く含まれていました。
なお、今回の集計はUAの文字列をもとにしています。UAは誰でも自由に名乗れるため、名前どおりの運営元からのアクセスとは限りません。4種類それぞれについて、ログと公開情報から確認できたことを次のセクションで整理します。
4種類のボットはそれぞれ何者?
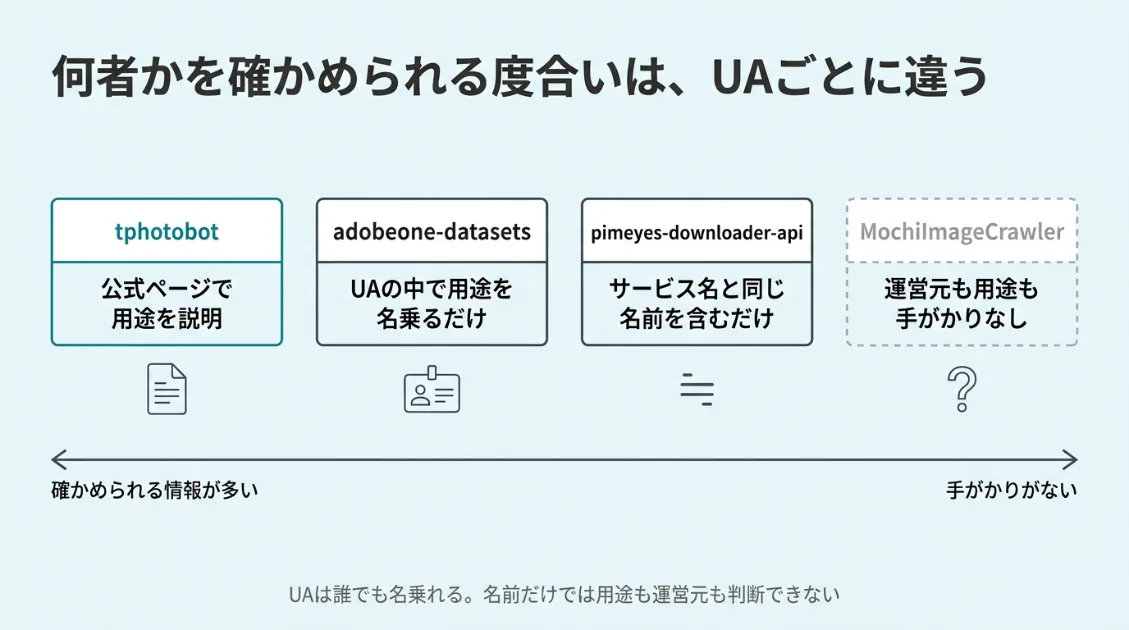
4種類のUAは、「何者なのか」を確かめられる度合いがそれぞれ異なります。運営元の説明ページがあるものから、手がかりがほとんどないものまで、確かめられる情報が多い順に紹介します。
| UA | 用途の根拠 | UA内のURL・連絡先 | 送信元のネットワーク事業者 (確認した範囲) |
|---|---|---|---|
| tphotobot | 運営元の公式ページで説明あり | あり | netcup GmbH(ドイツのホスティング事業者) |
| adobeone-datasets | UAの中で用途を名乗っているだけ | なし | Amazon Web Services(AWS) |
| pimeyes-downloader-api | サービス名と同じ名前を含むだけ | なし | Coolhousing(チェコのホスティング事業者) |
| MochiImageCrawler | 手がかりなし | なし | Amazon Web Services(AWS) |
送信元のネットワーク事業者は、IPアドレスの登録情報やASN情報から確認しました。tphotobotとMochiImageCrawlerは複数のIPからアクセスしていたため、そのうち一部のIPを確認した結果です。
tphotobot:写真の無断使用チェックと説明されている
tphotobotは、UAの中に説明ページのURLを載せていました。
tphotobot/0.1 (+https://crawler.estidraft.com/bot)URL先の公式ページには、写真が持ち主の許可なく使われていないかを調べるための自動クローラーだと書かれています。依頼者から預かった写真と、公開されているページの画像を照らし合わせ、一致しそうなものは人が確認する仕組みだと説明されています。
公式ページには、ほかにも次のような説明があります。
- robots.txtを読み、Crawl-delay(取得の間隔の指定)も含めて従う
- 「User-agent: tphotobot」と「Disallow: /」を書けば、1日以内に取得が止まる
- 画像そのものは保存せず、照合用の「指紋」のようなデータとページのURL・日時・ステータスだけを残す
- 1つのサイトへのリクエストは1秒に1回まで
- メールで依頼すれば、理由を伝えなくてもドメインごと取得を止められる
一方で、公式ページに運営会社の名前や、取得に使うIPアドレスの範囲は載っていません。ログに残ったアクセスが本当に説明どおりの運営元によるものかを、IPアドレスで確かめる方法はありませんでした。
なお、今回のログではrobots.txtへのリクエストが5回記録されていました。ただし、AI観測ラボのrobots.txtはtphotobotを制限していないため、「制限したら本当に止まるのか」は今回のログでは確かめられていません。
adobeone-datasets:研究用データセットと名乗っている
adobeone-datasetsは、UAの中で用途を名乗っていました。
adobeone-datasets/0.1 (Adobe Research; image-text research dataset)UAを日本語にすると「Adobe Research(Adobeの研究部門)の、画像とテキストの研究用データセット」という意味になります。画像と説明文を組み合わせたデータセットは、一般に画像を扱うAIの研究や開発で使われるものです。
ただし、確認できたのは「UAにそう書かれている」ことまでです。
- UAに説明ページのURLや連絡先が含まれていない
- 公開情報を検索しても、同じ名前のボットについての説明は見つからなかった
- 送信元のIPアドレス(52.42.130.66)は、Adobeの社内ネットワークではなく、Amazon Web Services(AWS)のクラウドサーバーのものだった
大企業でもクラウドサーバーからボットを動かすことはあるため、AWSのIPだからといってAdobeと無関係だとはいえません。反対に、UAに「Adobe Research」と書いてあるだけでは、Adobeによるアクセスだと判断することもできません。本記事では「Adobe Researchを名乗るUA」として扱います。
pimeyes-downloader-api:顔検索サービスと同じ名前を含む
pimeyes-downloader-apiは、UAに名前とバージョンしか書かれていませんでした。
pimeyes-downloader-api/0.1「PimEyes」は、顔写真をもとにWeb上の似た顔の画像を探せる、海外の顔検索サービスと同じ名前です。ただし、PimEyesがボットのUAを公開している情報は見つかりませんでした。UAにURLや連絡先もなく、送信元のIPアドレス(87.236.194.202)はチェコのホスティング事業者のものでした。
名前が同じというだけで、PimEyesによるアクセスかどうか、顔検索のために取得されたのかどうかは判断できません。本記事では「PimEyesと同じ名称を含むUA」として扱います。
なお、リクエストされた5件の画像URLは、ファイル名から見ると、いずれもClaudeに関する記事の図解画像でした。
MochiImageCrawler:運営元も用途も確認できない
MochiImageCrawlerも、UAに名前とバージョンしか書かれていませんでした。
MochiImageCrawler/0.1名前に「ImageCrawler(画像を集めるクローラー)」とあるだけで、運営元や用途を示す情報はありません。公開情報を検索しても、同じ名前のボットの説明は見つかりませんでした。
アクセスは13個のIPアドレスから届いており、確認したIPはいずれもAWSのクラウドサーバーのものでした。4種類の中で、何者かを確かめる手がかりがもっとも少ないUAです。
関連:KeenableBotってどこのクローラー?運営元に問い合わせて確かめた
4種類の動き方はどう違った?
4種類とも「画像URLにリクエストする」という点は同じですが、時間のかけ方やIPアドレスの使い方は大きく異なっていました。
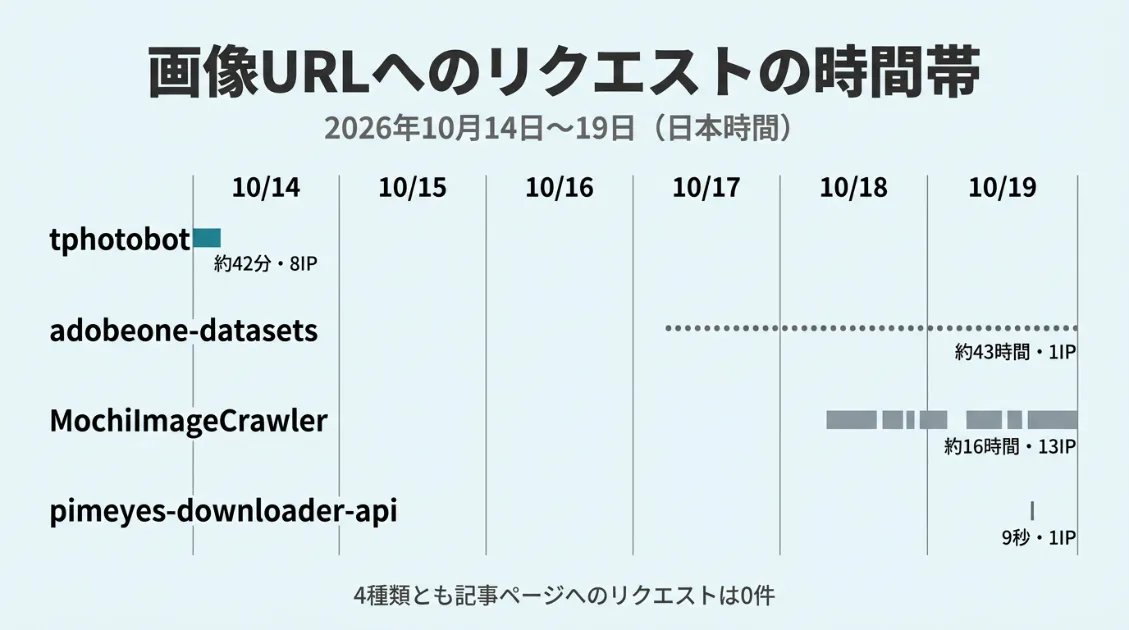
| UA | 最初と最後のリクエスト(日本時間) | かかった時間 | 使われたIP数 | リクエストの間隔(中央値) |
|---|---|---|---|---|
| tphotobot | 10月14日 0:38 〜 1:20 | 約42分 | 8個 | 0秒(同じ秒に複数) |
| adobeone-datasets | 10月17日 13:33 〜 10月19日 8:51 | 約43時間 | 1個 | 約34分 |
| MochiImageCrawler | 10月18日 15:14 〜 10月19日 7:22 | 約16時間 | 13個 | 約3分 |
| pimeyes-downloader-api | 10月18日 19:15:50 〜 19:15:59 | 9秒 | 1個 | 2秒 |
「リクエストの間隔(中央値)」は、1つ前のリクエストから次のリクエストまでの時間を並べたときの、真ん中の値です。数字が小さいほど、短い時間にまとめてリクエストしていることを表します。
tphotobot:約42分に集中し、robots.txt専用のIPがあった
tphotobotのリクエストは、10月14日の深夜0時38分から1時20分までの約42分間に集中していました。同じ1秒の間に複数の画像URLへリクエストすることも多く、短い時間にまとめて取得する動き方です。
目立ったのは、IPアドレスごとの役割の違いです。8個のIPのうち、4個はrobots.txtにだけリクエストし、画像URLには1件もリクエストしていませんでした。画像URLへのリクエストは残りの4個のIPが担っており、そのうち1個(62.83.35.92)は、robots.txtを読んだ50秒後に画像URLへのリクエストを始めていました。
robots.txtを読むIPと画像を取得するIPを分けている理由は、ログからはわかりません。また、robots.txtへのリクエストが記録されていたことと、robots.txtの指定に従って動いていることは別の話です。AI観測ラボのrobots.txtはtphotobotを制限していないため、従うかどうかは今回のログでは確かめられていません。
公式ページの説明と、実際のログが一致しない点もありました。公式ページには「1サイトへのリクエストは1秒に1回まで」とありますが、今回のログでは同じ秒に複数のリクエストが記録されていました。同じ秒に2件以上のリクエストがあった時刻は7回あり、多いときは1秒間に6件でした。この違いの理由は、ログだけでは判断できません。
adobeone-datasets:1つのIPから、約43時間かけて少しずつ
adobeone-datasetsは、1つのIPアドレスから約43時間にわたってリクエストを続けていました。リクエストの間隔は中央値で約34分と長く、昼も夜も関係なく、少しずつ画像URLにアクセスしていました。
観測期間のログには、adobeone-datasetsによるrobots.txtへのリクエストはありませんでした。ただし、観測期間より前に読んでいた可能性や、別のUAでrobots.txtを確認していた可能性もあるため、「robots.txtを無視している」とは判断できません。
MochiImageCrawler:13個のIPに分かれて約16時間
MochiImageCrawlerは、最初に1個のIPからrobots.txtへリクエストし、その1秒後に同じIPから最初の画像URLへリクエストしていました。そのあとは13個のIPアドレスに分かれ、約16時間かけて画像URLへのリクエストを続けています。
1つのIPあたりのリクエストは1〜7件と少なく、複数のIPで手分けして取得している形です。サーバーから見ると、1つのIPごとのアクセスは目立ちにくい動き方といえます。
pimeyes-downloader-api:9秒で5件だけ
pimeyes-downloader-apiは、10月18日の19時15分50秒から59秒までの9秒間に、5件の画像URLへリクエストしただけでした。5件はいずれもClaudeに関する記事の図解画像で、特定の記事の画像だけをまとめて取得したように見える動きです。
観測期間中、ほかの日時のリクエストや、robots.txtへのリクエストはありませんでした。
共通点:記事ページを通らずに画像URLへ直接アクセスしていた
4種類には、動き方の違いとは別に、共通する点もありました。
- 記事ページ(HTML)やサイトマップへのリクエストがなく、画像URLへ直接リクエストしていた
- 147件すべてで、どのページから来たかを示す「リファラー」が空だった(空の場合、アクセス経路はリファラーからは判断できません)
- 4種類の転送量は合計で約2.2MBだった
今回の観測期間・UAでは、画像URLを知るきっかけとなる記事ページやサイトマップへのアクセスは確認できませんでした。観測期間より前や別のUAによる取得、外部の情報源などが考えられますが、入手経路は特定できません。
関連:robots.txt完全ガイド【2026年版】156件の実測ログで分かったAIクローラーの正しい制御方法
自分のサイトで画像へのアクセスを確認するには?
確認できるのはサーバーのアクセスログ
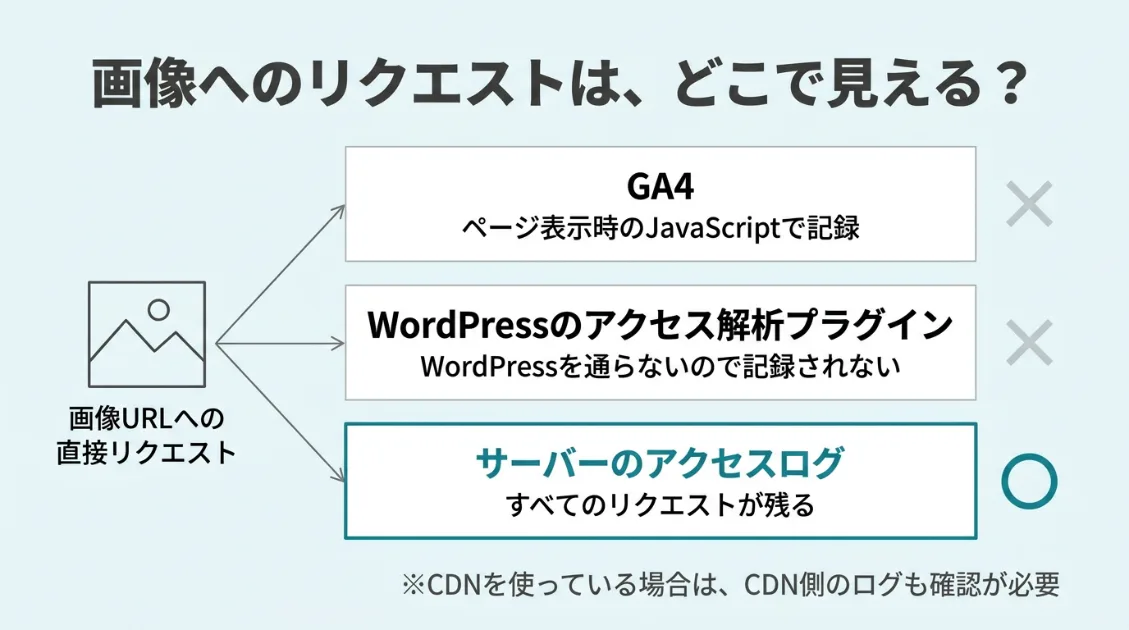
画像URLへの直接リクエストは、通常のGA4のページ計測には記録されません。GA4のページ計測は、ページが表示されたときにブラウザでJavaScriptが動いて記録する仕組みのため、記事ページを開かずに画像URLだけをリクエストするボットは数えられないからです。
WordPressのアクセス解析プラグインも、ページ表示を計測するタイプのプラグインでは、画像URLへの直接リクエストは通常記録されません。画像ファイルはWordPressを通らずにサーバーが直接返すことが多いためです。
画像URLへのリクエストを確かめられるのは、サーバーのアクセスログです。レンタルサーバーの管理画面からダウンロードするか、SSHでサーバーに接続して確認します。なお、CDN(画像などを代わりに配信するサービス)を使っている場合、CDNが返した画像はサーバーのログに残らないことがあります。
画像にだけリクエストしているUAを探すコマンド
次のコマンドは、Linux環境で、リクエスト・リファラー・UAを二重引用符で区切る一般的なCombined形式のログを集計する例です。ファイル名は実際のログに合わせて変更してください。
UAごとに「画像URLへのリクエスト」と「それ以外へのリクエスト」を数え、画像URLにしかリクエストしていないUAだけを、件数の多い順に表示します。robots.txtへのリクエストは「それ以外」から外しています。
# 画像URLにだけリクエストしているUAを件数順に表示(.gzの過去ログも含む)
zcat -f access_log* | awk -F'"' '{
  split($2, r, " "); ua = $6; p = r[2];
  if (p ~ /\.(webp|png|jpe?g|gif|avif|svg)(\?|$)/) img[ua]++;
  else if (p !~ /^\/robots\.txt(\?|$)/) other[ua]++;
} END {
  for (u in img) if (!(u in other)) print img[u] "\t" u;
}' | sort -rn | head -30
コマンドは、URLの拡張子で画像かどうかを判定する簡易的な集計です。拡張子のない画像配信URLなどは対象外になります。
特定のUAの動きを詳しく見たいときは、UAの名前で絞り込みます。
# 4種類のUAのリクエストを表示
zgrep -hE "tphotobot|adobeone-datasets|MochiImageCrawler|pimeyes-downloader-api" access_log*
結果は4つのグループに分けて読む
AI観測ラボのログで1つ目のコマンドを実行すると、本記事の4種類以外にも、画像URLにだけリクエストしているUAが表示されました。結果は、次の4つのグループに分けて読むと整理しやすくなります。
| グループ | AI観測ラボのログでの例(リクエスト数) | どう考えるか |
|---|---|---|
| リンクのプレビュー | Slack-ImgProxy(68)、Iframely(9)、Discordbot(6) | 誰かがチャットやSNSに記事のURLを貼ったときに、サムネイル画像を表示するためのアクセス。多くの場合、心配はいりません |
| 運営元が用途を公表している画像用クローラー | GoogleOther-Image(4)、Baiduspider-image(2) | 運営元が公式に用途を説明している画像用のクローラー。用途はクローラーごとに異なります |
| 名前を名乗る見慣れないUA | adobeone-datasets(48)、MochiImageCrawler(47)、tphotobot(41)、pimeyes-downloader-api(5) | 本記事で取り上げた4種類。UAの名前・URL・送信元を手がかりに、何者かを調べます |
| 名前を名乗らないUA | 「Mozilla/5.0 (compatible; crawler)」(170) | UAから運営元を調べる手がかりがありません |
4つ目のグループの「Mozilla/5.0 (compatible; crawler)」は、本記事の4種類よりも多い170件の画像URLへのリクエストがありました。170件すべてが異なるIPアドレスから届いており、名前もURLも名乗っていません。ただし、汎用的なUAのため、無関係な複数のアクセス元が同じUAを使っている可能性があり、1つのボットが170個のIPを使ったとは限りません。運営元を確かめる手がかりがないため、本記事の比較からは外していますが、ログの中では見落とせない存在です。
見慣れないUAを見つけたら確認する5つのこと
画像URLにだけリクエストしている見慣れないUAを見つけたら、次の5つを順番に確認すると、「何者か」をどこまで確かめられるかがわかります。
- UAの中にURLや連絡先があるか:あれば、URL先の説明ページで用途やrobots.txtへの対応を確認します
- robots.txtへのリクエストがあるか:robots.txtを要求した記録は確認できます。ただし、内容を解釈したか、指定に従ったかまでは判断できません
- 送信元IPのネットワーク事業者:IPアドレスの登録情報から、名乗っている運営元のネットワークかどうかを確かめます
- リクエストの数と時間のかけ方:短い時間に集中しているか、少しずつ続いているかを確認します
- リファラー:記録されていれば参照元の手がかりになります。空の場合は、アクセス経路をリファラーから判断できません
関連:AIはあなたのサイトを読みに来ている?「AI Kansoku Lab Tracker」で見えること
画像へのアクセスは制限したほうがいい?
画像URLにリクエストするボットを見つけても、すぐに制限する必要があるとは限りません。今回の4種類の転送量は8日間で合計約2.2MBでした。制限するかどうかは、ボットの数よりも「どんな画像を公開しているか」で考えるのが現実的です。
| 公開している画像 | 考え方 |
|---|---|
| 記事の図解・アイキャッチ | 転送量・サーバー負荷と、画像の利用方針を確認し、観測を続けるか制限するか判断します |
| 人物の写真(スタッフ・お客様など) | 写っている人の同意の範囲を確認し、見慣れないUAからのリクエストは優先して調べます |
| イラスト・写真などの作品 | 利用規約での意思表示と、サーバー側での制限をあわせて検討します |
| 会員限定・非公開にしたい画像 | 公開URLに置かず、ログインした人だけが見られる場所に置きます |
制限すると決めた場合は、次の2つの方法を組み合わせます。
robots.txtで伝える
robots.txtは、ボットに「取得しないでほしい」と伝えるファイルです。tphotobotは、公式ページで次の書き方による停止を案内しています。
User-agent: tphotobot
Disallow: /
ほかの3種類は、robots.txtに対応しているかどうかを公表していません。書いておくことはできますが、止まるかどうかはわかりません。また、「User-agent: *」で画像フォルダ(/wp-content/uploads/)全体を拒否すると、検索エンジンの画像用クローラーやSNSのプレビューにも影響する場合があるため、UAごとに指定するのが安全です。
サーバー側で拒否する
robots.txtに従わないボットも止めたい場合は、サーバー側で拒否します。次の設定例は、mod_rewriteと.htaccessでの設定変更が利用できる環境向けです。指定したUAからの画像URLへのリクエストに対して、403(アクセス禁止)を返します。WordPressでは「# BEGIN WordPress」より前に追加してください。
# 指定したUAからの画像URLへのリクエストを拒否する例
RewriteEngine On
RewriteCond %{HTTP_USER_AGENT} (adobeone-datasets|MochiImageCrawler|pimeyes-downloader-api) [NC]
RewriteRule \.(webp|png|jpe?g|gif|avif)$ - [F,NC]
.htaccessの書き間違いはサイト全体の表示に影響するため、編集前に必ずバックアップを取ってください。CDNやWAFを使っている場合は、そちらの管理画面でUAやIPアドレスを条件にした拒否ルールを設定する方法もあります。
ただし、UAを変更されると、設定例のルールでは検出できません。また、「Mozilla/5.0 (compatible; crawler)」のような汎用的なUAをまとめて拒否すると、無関係なアクセスも遮断する可能性があります。
AI観測ラボでは、画像へのアクセスを記録して観測を続けるため、現時点では4種類のUAを制限していません。
まとめ:画像へのアクセスは、ログで「確かめられる範囲」を知ることから
| 確認ポイント | 今回のログでわかったこと |
|---|---|
| 画像URLにだけリクエストする見慣れないUAは来ていた? | 8日間で4種類、合計147リクエスト(画像URL 141件+robots.txt 6件)。同じUAによる記事ページへのリクエストは0件 |
| 何者かはわかった? | 公式ページで用途を説明しているのはtphotobotだけ。ほかの3種類は、名乗っているだけ・似た名前を含むだけ・手がかりなし |
| 動き方に違いはあった? | 約42分に集中、約43時間かけて少しずつ、13個のIPで手分け、9秒で5件と、それぞれ異なる |
| robots.txtは守っている? | 要求した記録があるのは2種類。指定に従うかどうかは、今回のログでは確かめられない |
| 取得した画像の使い道は? | ログからはわからない |
今回の観測期間では、同じUAによる記事ページへのリクエストを伴わず、画像URLへのアクセスが記録されていました。ただし、UAの名前だけで用途や運営元を判断することはできません。用途を公式に説明しているもの、UAで名乗っているだけのもの、有名なサービスと似た名前を含むだけのもの、手がかりがないものでは、確かめられる範囲が大きく異なります。
画像URLへの直接リクエストは、通常のGA4のページ計測には記録されません。自分のサイトの画像に何が起きているかを知るには、サーバーのアクセスログを確認するのが出発点です。本記事のコマンドで画像URLにだけリクエストしているUAを洗い出し、5つの確認ポイントで「どこまで確かめられるか」を整理してから、制限するかどうかを判断してください。
AI観測ラボでは、4種類のUAと「Mozilla/5.0 (compatible; crawler)」の観測を続けます。動きに変化があれば、本記事に追記します。
関連:AIエージェントのユーザーエージェントを見分けるには
関連:KeenableBotってどこのクローラー?運営元に問い合わせて確かめた
関連:robots.txt完全ガイド【2026年版】156件の実測ログで分かったAIクローラーの正しい制御方法
あなたのサイトは、
AIに見えていますか?
URLを入力するだけで30秒。8項目を自動診断し、優先度別の改善プランを提示します。完全無料・登録不要。