LohiSoftBotは危ないボット?スロバキア企業の検索クローラーの正体
サーバーのアクセスログに「LohiSoftBot」という見慣れない名前が残っていて、危ないボットではないかと気になった方も多いはずです。名前に「Bot」と付いているため、ChatGPTのようなAIが学習用にページを集めに来たのではないかと不安になるかもしれません。
先に結論をお伝えすると、LohiSoftBotはスロバキアのソフトウェア会社LohiSoft s.r.o.が運営する、自社の検索インデックス用のクローラーです。運営元は、AIの学習データは集めず、ページの本文も保存しないと説明しています。今回確認したアクセスログでは、短時間に大量のリクエストを送るような動きは見られませんでした。
AI観測ラボのブログにも、2026年10月12日にLohiSoftBotが訪れ、39秒間で11件のアクセスを残して帰っていきました。本記事では、LohiSoftBotが何のために、どんな情報を集めているのか、本物かどうかの確かめ方、ブロックすべきかどうかを、公式の説明と実際のアクセスログをもとに解説します。
この記事でわかること|📖:約8分
- LohiSoftBotを動かしているスロバキアの会社と、ボットの目的
- 実際のログで分かった、39秒間で11件のアクセスがあった巡回の様子
- 本物のLohiSoftBotかどうかを確かめる方法
- ブロックしたほうがいいかの判断材料と、robots.txtの書き方
LohiSoftBotは誰が何のために動かしている?
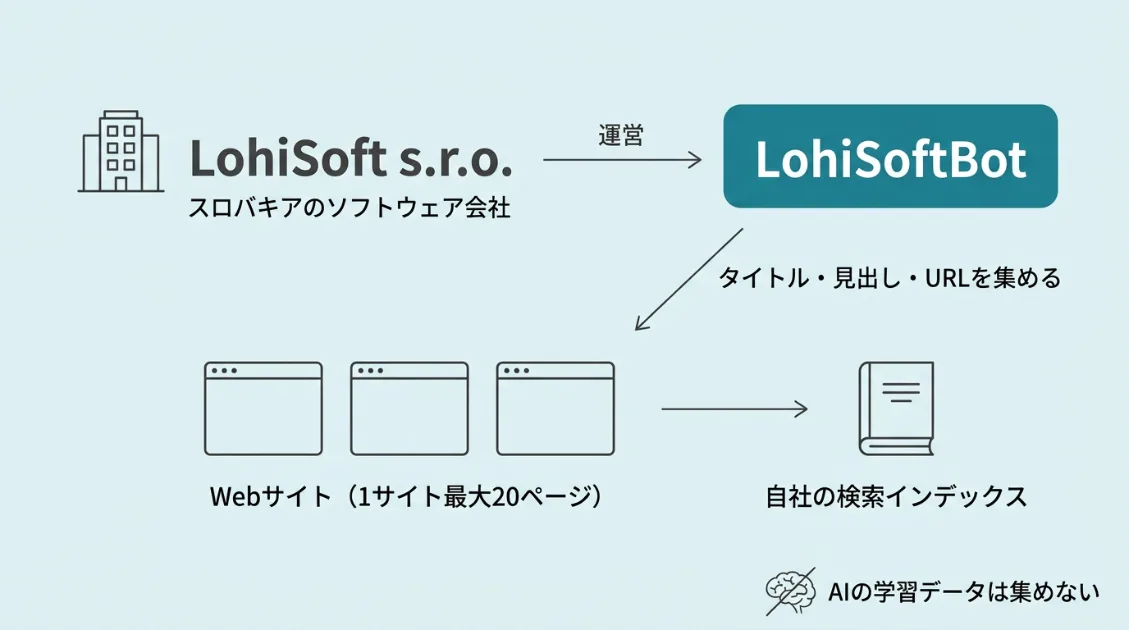
LohiSoftBotを動かしているのは、スロバキアのソフトウェア会社「LohiSoft s.r.o.(ロヒソフト)」です。目的は、LohiSoft自身の検索インデックスを作ることだと公式ページで説明しています。検索インデックスとは、検索エンジンが「どのサイトに何が書いてあるか」を整理しておく、本の索引のような仕組みです。
運営しているのはスロバキアのソフトウェア会社です
LohiSoft s.r.o.のプライバシーポリシーには、スロバキア南部の町シュトゥーロヴォの住所が記載されています。本業は、業務システム、Webサイト、スマートフォンアプリを作る受託開発で、オンライン予約システム「yAppointment」も手がけています。
LohiSoftBotの公式説明ページは、ハンガリー語を含む12の言語で公開されています。
| 運営会社 | LohiSoft s.r.o.(スロバキア) |
|---|---|
| ユーザーエージェント | LohiSoftBot/1.0 (+https://lohisoft.com/bot) LohiSoftBot/1.0 (+message@lohisoft.com) |
| 目的 | LohiSoft自身の検索インデックスづくり |
| AIの学習 | 学習データは集めないと公式に明記 |
| アクセス元IP | 79.139.58.98/79.139.58.121 |
| 1サイトあたりの上限 | 最大20ページ |
| 公式の説明ページ | lohisoft.com/bot/ |
AIの学習には使わないと明記しています
LohiSoftBotの公式ページには、「AIモデルの学習データは集めない」「コンテンツを転載するためにコピーしない」とはっきり書かれています。GPTBotやClaudeBotのように、AIの学習用にページの文章を集めるクローラーとは目的が違います。
公式ページでは、LohiSoftの検索インデックスについて「道を示すだけで、答えはしない」と説明しています。公式の説明では、検索結果から元のページへ利用者を案内する仕組みを想定しています。
検索サービスの公開状況は確認できませんでした
LohiSoftの会社紹介、サービス一覧、GitHubを確認しましたが、LohiSoftBotが集めた情報を使う検索サービスの名前や、利用できるページは見つかりませんでした。
クローラーを記録するデータベース「udger」には、メールアドレス付きの旧形式のユーザーエージェントが、2026年8月26日に初めて観測されたと記録されています。検索インデックスを作る目的は公式に説明されていますが、検索インデックスをどのような検索サービスとして提供するのかは、確認した公開情報からは分かりませんでした。
LohiSoftBotはどのページにアクセスした?
AI観測ラボのブログでは、2026年10月12日の20時57分から58分にかけて、LohiSoftBotのアクセスが記録されました。最初のアクセスから最後のアクセスまでは39秒で、記録されたアクセスは11件です。正常に取得できたページは、重複を除いて8ページでした。
39秒間に記録された11件のアクセス
LohiSoftBotのアクセスを、ログに記録された順番に並べると下記のとおりです。時刻はサーバーの記録時刻です。
| 時刻 | アクセスしたURL | ステータス |
|---|---|---|
| 20:57:25 | /sitemap.xml | 404 |
| 20:57:46 | /(トップページ) | 301 |
| 20:57:48 | /(トップページ) | 200 |
| 20:57:53 | /(トップページ) | 200 |
| 20:57:54 | /about/ | 200 |
| 20:57:56 | /start-guide/ | 200 |
| 20:57:57 | /diagnosis-guide/ | 200 |
| 20:57:59 | /glossary/ | 200 |
| 20:58:00 | /ai-crawler-zukan/ | 200 |
| 20:58:02 | /ai-old-information/ | 200 |
| 20:58:04 | /articles/ | 200 |
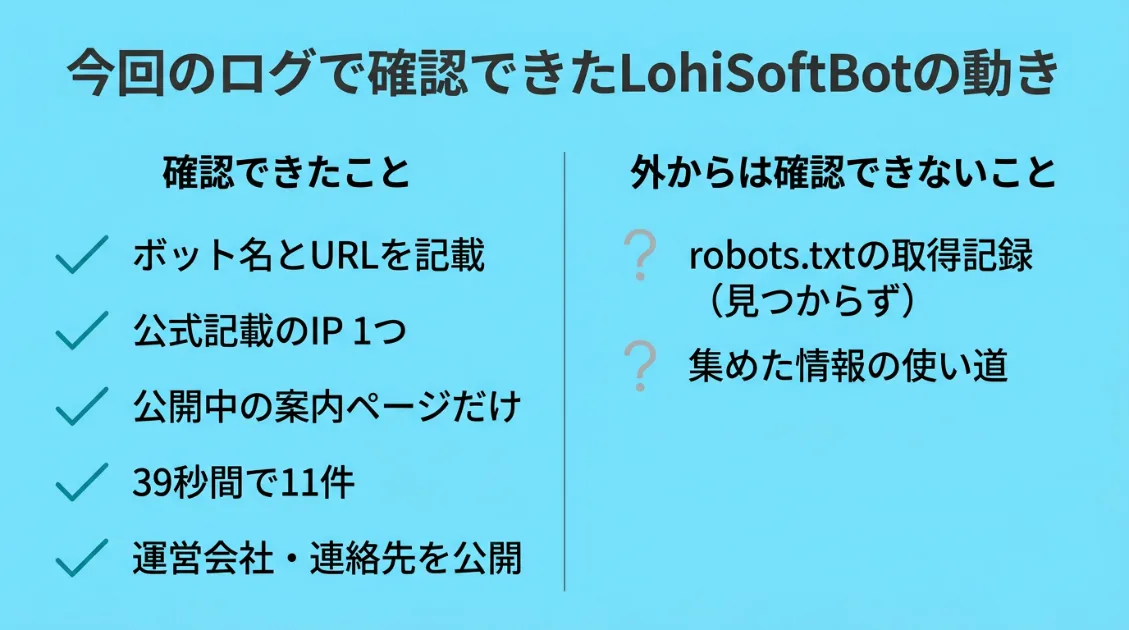
アクセス元のIPアドレスは11件すべて79.139.58.98で、公式ページに記載されたIPアドレスと一致しました。ユーザーエージェントは、新しい形式の「LohiSoftBot/1.0 (+https://lohisoft.com/bot)」でした。
/about/以降の案内ページには、1〜2秒間隔でアクセスしています。少なくとも今回のログでは、短時間に大量のアクセスが集中する動きは見られませんでした。正常に取得できた異なるページは8ページで、公式が説明する「1サイトあたり最大20ページ」の範囲内でした。
表の中の「200」「301」「404」は、サーバーがアクセスに対して返したステータスコードです。200は正常に表示できたこと、301は別のURLへ転送したこと、404はページが見つからなかったことを表しています。
最初にアクセスしたのはsitemap.xmlでした
LohiSoftBotが最初に取りに来たのは、サイト内のページ一覧をまとめたサイトマップ「/sitemap.xml」でした。ただ、AI観測ラボのブログのサイトマップは「/sitemap_index.xml」という別のURLにあるため、結果は404(ページが見つからない)になっています。
サイトマップの場所は、robots.txtにも書いてあります。LohiSoftBotがrobots.txtを読んだかどうかについては、後半の「robots.txtは守っている?」で詳しく見ていきます。
個別の記事には入らず、案内ページだけを見ていきました
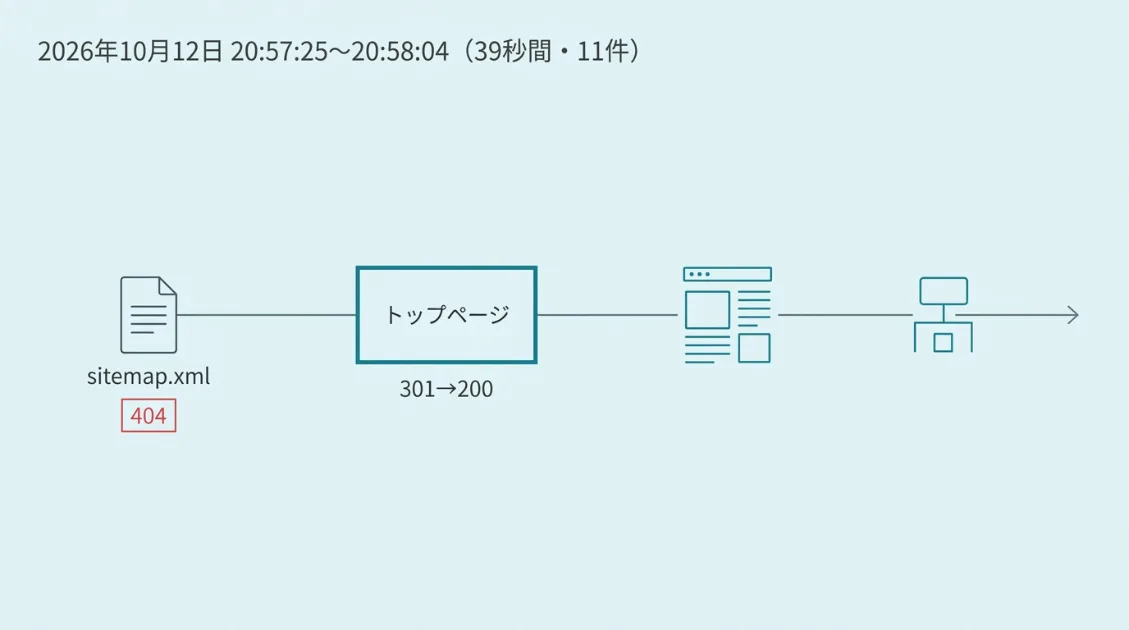
LohiSoftBotが取得したページは、トップページ、運営者紹介、はじめての方向けガイド、用語集、AIクローラー図鑑、記事一覧など、ブログ全体の案内役にあたるページでした。今回の11件には、個別の記事ページへのアクセスはありませんでした。
取得したページの並びを見ると、トップページに並んでいるリンクを順番にたどったように見えます。ですが、どのページを選ぶ仕組みなのかは、今回のログだけでは分かりません。
9月28日から10月14日までの確認済みログでは、今回以外のアクセスは見つかりませんでした。ただし、10月5日から7日ごろには未確認のログがあるため、期間中の訪問をすべて把握できているわけではありません。
LohiSoftBotは何を持ち帰っている?
LohiSoftBotの公式ページによると、保存するのはページのタイトル、説明文、見出し、URL、リンクの文字の5つだけです。ページの本文は保存しないと説明しています。
保存するのはタイトル・説明文・見出しなど5つの情報です
公式ページに書かれている、保存する情報を整理すると次のとおりです。
| 保存する情報 | 中身の例 |
|---|---|
| ページのタイトル | ブラウザのタブや検索結果に表示される題名 |
| メタディスクリプション | ページの概要を伝えるためにHTMLに設定する説明文 |
| h1〜h3の見出し | 記事の大見出し・中見出し・小見出し |
| URL | ページのアドレス |
| リンクの文字 | ほかのページからリンクされるときに使われている文字 |
保存しない情報として、公式ページには「ページの本文」が挙げられています。記事の文章そのものは、LohiSoftの検索インデックスには残らないという説明です。
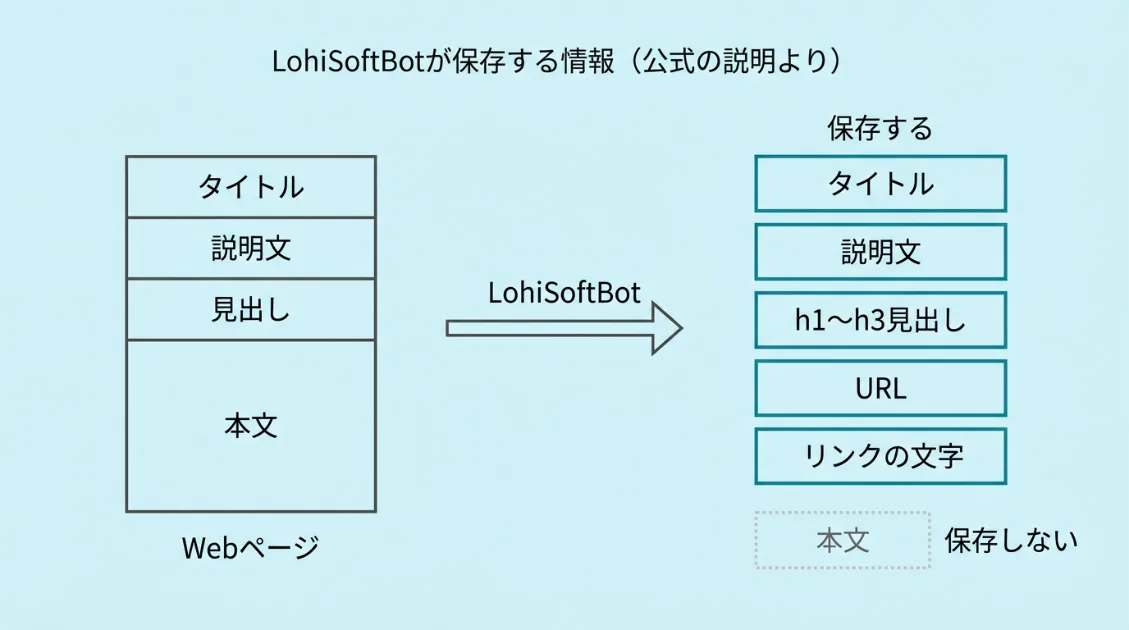
タイトル、説明文、見出しは、ページのテーマや内容を把握する手がかりになります。
本文を保存しないことと、取得しないことは別です
タイトルや見出しは、ページのHTMLに含まれています。なので、「本文を保存しない」という説明は、「本文を含むHTMLを取得しない」という意味ではありません。今回のログでは、正常に取得できたページへの応答として、サーバーから約17KB〜36KBのデータが送信されていました。
公式ページでは、保存する情報を5つに限定し、ページの本文は保存しないと説明しています。しかし、取得したデータを実際にどう処理し、何を保存しているかは、サイト側のアクセスログからは確認できません。
AIの学習用クローラーとは集める目的が違います
AIの学習用クローラーが文章を学ばせるためにページを集めるのに対して、LohiSoftBotは検索インデックスの目印になる情報を保存すると説明しています。検索インデックスを作るクローラーとAIに関係するボットの違いは、AIはGoogleと同じようにサイトを読んでいるのか?で、実際のアクセスログをもとに詳しく解説しています。
LohiSoftBotは危ないボット?
今回確認した11件のアクセスには、短時間の大量アクセスや、管理画面・設定ファイルなどを探る動きは見られませんでした。ログで確認できるのはアクセスの動きのみです。本物のLohiSoftBotかどうかの確認と、robots.txtの扱いについては、次のセクション以降で見ていきます。
今回のログで確認できたことと、判断の限界
今回のログで確認できたことと、そこから言えることを整理すると次のとおりです。
| 確認したポイント | 今回のログで確認できたこと | 言えること・言えないこと |
|---|---|---|
| 名乗り方 | ボット名と説明ページのURLをユーザーエージェントに記載 | 運営元をたどれる。ただし名前は誰でも名乗れる |
| アクセス元 | 公式ページに記載されたIPアドレス1つだけ | 公式の情報と一致。アクセスの中身の安全性までは分からない |
| アクセスしたページ | トップページや用語集など、公開中の案内ページだけ | ログイン画面や管理画面へのアクセスはなかった |
| アクセスの量 | 39秒間で11件、案内ページには1〜2秒間隔 | 短時間の大量アクセスはなかった |
| 運営者の情報 | 運営会社、目的、連絡先、ブロック方法を公開 | 問い合わせ先はある。集めた情報の使い道は外から確認できない |
表の項目は、アクセスの性質を判断する手がかりです。名前の公開やIPアドレスの固定だけで、安全性が保証されるわけではありません。
WordPressのサイトには、ログイン画面の「/wp-login.php」などを探るアクセスが日常的に届きます。今回のLohiSoftBotの11件には、ログイン画面や管理画面へのアクセスは1件も含まれていませんでした。
気になる点も2つあります
今回の調査では、気になる点も2つ見つかりました。
- 確認したログの範囲では、LohiSoftBotがrobots.txtを取得した記録が見つかりませんでした。
- LohiSoftBotが集めた情報を使う検索サービスの名前や、利用できるページは確認できませんでした。
どちらも、サイトに直接の害が出ることを示すものではありません。今回のログで確認できた動きと、外からは確認できない点を分けて判断する必要があります。
名前だけで本物と判断するのは危険です
ユーザーエージェントに書かれた名前は、誰でも自由に書き換えられます。ログに「LohiSoftBot」と記録されていても、別の誰かがLohiSoftBotの名前を使ってアクセスしている可能性はゼロではありません。
今回のアクセス元は、公式ページに記載されたIPアドレスと一致していました。さらには、逆引きと正引きでも公式が案内する確認条件を満たしています。確認方法は次の節で紹介します。ほかのクローラーの名乗り方やアクセス元は、AIクローラー図鑑でも比べられます。
本物のLohiSoftBotかどうかはどう確かめる?
本物のLohiSoftBotかどうかは、アクセス元のIPアドレスで確かめられます。方法は、公式のIPアドレス一覧と照らし合わせる方法と、逆引きと正引きで確認する方法の2つです。どちらも、公式ページで案内されています。
まずはアクセス元のIPアドレスを調べます
最初に、アクセスログから「LohiSoftBot」を名乗るアクセスのIPアドレスを取り出します。ログファイルの名前や形式は、サーバーによって異なります。次のコマンドは、ログの各行の先頭にアクセス元のIPアドレスが記録されている場合の例です。CDNなどを使っているサイトでは、実際のアクセス元のIPアドレスがログのどの項目に記録されているかを先に確認してください。
grep 'LohiSoftBot' access_log | awk '{print $1}' | sort | uniq -cAI観測ラボのブログでは、次の結果になりました。11件のアクセスが、すべて同じIPアドレスから来ていたことが分かります。
11 79.139.58.98方法1:公式のIPアドレス一覧と照らし合わせる
いちばん簡単なのは、公式ページに記載されたIPアドレスと見比べる方法です。2026年10月時点で、LohiSoftBotのアクセス元として公開されているIPアドレスは次の2つです。
- 79.139.58.98
- 79.139.58.121
機械で読み取れる一覧も、lohisoft.com/bot/ips.jsonで公開されています。ログのIPアドレスが一覧に含まれていれば、公式の情報と一致していることになります。ただし、IPアドレスは今後変わる可能性があるため、確認するときは最新の一覧を見るようにしてください。
方法2:逆引きと正引きで確認する
公式ページがいちばんおすすめしているのは、逆引きと正引きを組み合わせる確認方法です。逆引きはIPアドレスから名前(ホスト名)を調べること、正引きは名前からIPアドレスを調べることです。ホスト名が「.bot.lohisoft.com」で終わり、正引きでも元のIPアドレスに戻れば、公式の確認条件を満たします。
確認の手順は次の3つです。
- アクセス元のIPアドレスを逆引きして、ホスト名が「.bot.lohisoft.com」で終わるか確認する
- 出てきたホスト名を正引きして、元のIPアドレスに戻るか確認する
- ホスト名の末尾や正引きのIPアドレスが一致しなければ、本物として扱わない。DNSの問い合わせに失敗した場合は、時間を置いて再確認する
AI観測ラボのサーバーで、実際に確認した結果が次のとおりです。
$ host 79.139.58.98
98.58.139.79.in-addr.arpa domain name pointer crawler1.bot.lohisoft.com.

$ host crawler1.bot.lohisoft.com
crawler1.bot.lohisoft.com has address 79.139.58.98
逆引きの結果は「crawler1.bot.lohisoft.com」で、「.bot.lohisoft.com」で終わっています。結果の最後に付いている「.」(点)はDNSの表記上のもので、判定では除いて考えます。正引きの結果も、元の79.139.58.98に戻りました。公式が案内する確認条件を、両方とも満たしています。
「.lohisoft.com」だけで判断しないようにしましょう
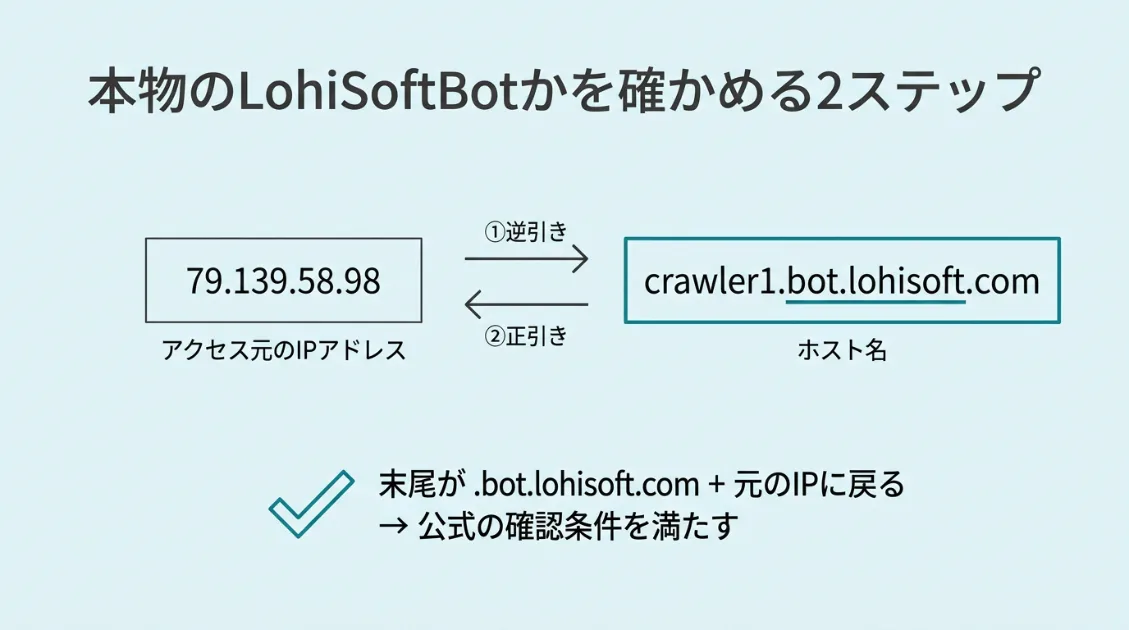
公式ページでは、末尾を「.lohisoft.com」ではなく「.bot.lohisoft.com」で確認するよう注意しています。「lohisoft.com」というドメインには、LohiSoftのWebサーバーやメールサーバーも含まれているためです。クローラー専用のサーバーだけを確認するには、「.bot.lohisoft.com」まで一致しているかを見る必要があります。
確認の条件を満たさないのに「LohiSoftBot」を名乗るアクセスについて、公式ページでは「LohiSoftからのアクセスではないので、ブロックして構わない」と説明しています。
LohiSoftBotはrobots.txtを守っている?
LohiSoftBotの公式ページには、robots.txtのルールを定めた国際的な仕様「RFC 9309」に従うと書かれています。一方で、今回確認したログの範囲では、LohiSoftBotがrobots.txtを取得した記録は見つかりませんでした。
確認したログに、robots.txtの取得記録はありませんでした
2026年9月28日から10月14日までの確認済みログを、公式IPを含む「79.139.58.」で始まるアクセスに絞って調べました。ボットの名前を問わずに調べても、robots.txtへのアクセスは1件もありませんでした。10月12日の巡回で最初に取りに来たのは、robots.txtではなく「/sitemap.xml」です。
AI観測ラボのブログのrobots.txtには、サイトマップの場所として「/sitemap_index.xml」が書いてあります。今回のLohiSoftBotは「/sitemap.xml」にアクセスし、404(ページが見つからない)になっていました。なお、robots.txtに書かれたサイトマップを利用することは必須ではないため、/sitemap.xmlへのアクセスだけで、robots.txtを読んでいないとは判断できません。
RFC 9309では、robots.txtが取得できない場合を除き、robots.txtの内容を24時間を超えて使い回さないことが推奨されています。未確認の期間にrobots.txtを取得していた可能性はあります。ただし、未確認の期間から10月12日の巡回までは24時間以上空いているため、通常のキャッシュ利用だけでは今回の取得記録がない理由を説明できません。今回のログだけでは、RFC 9309に沿って処理していたかまでは判断できません。
禁止されたページへのアクセスはありませんでした
AI観測ラボのブログのrobots.txtは、LohiSoftBotが今回アクセスしたページを禁止していません。今回の11件に、robots.txtで禁止されたページへのアクセスは含まれていませんでした。
robots.txtでLohiSoftBotを止めたい場合は、robots.txtに書くだけでなく、設定後のログでLohiSoftBotのアクセスがどうなったかを確認することをおすすめします。
LohiSoftBotはブロックしたほうがいい?
今回のログで確認できた範囲では、アクセスの量は少なく、公開中のページだけを取得していました。急いでブロックしなければならない動きではありません。ブロックするかどうかは、LohiSoftの検索インデックスにサイトの情報が載ることをどう考えるかで決めるのがよいです。
ブロックするかどうかの判断材料
| 許可してもよいと考えられる場合 | ブロックを検討してもよい場合 |
|---|---|
| 新しい検索サービスにも、サイトの情報が載る可能性を残しておきたい | 検索サービスの公開状況が確認できない段階では、情報収集に応じたくない |
| アクセスの量が少なく、サーバーの負担が気にならない | サイトに来るボットの数を、できるだけ絞っておきたい |
| タイトルや見出しなど、もともと公開している情報だけなら問題ない | robots.txtの取得記録が確認できないことが気になる |
ブロックする方法は2つあります
1つ目は、robots.txtに次の2行を書き足す方法です。公式ページで案内されている書き方です。
User-agent: LohiSoftBot
Disallow: /robots.txtの書き方やAIクローラーごとの指定方法は、AIクローラー向けrobots.txtの完全ガイドで詳しく解説しています。
2つ目は、メールで除外を依頼する方法です。公式ページによると、message@lohisoft.comに連絡すると、ドメインを巡回の対象から外してもらえます。停止を依頼したい場合は、robots.txtとメールの両方で対応しておくと安心です。
止まったかどうかはログで確かめます
ブロックの設定をしたあとは、しばらく時間を置いてから、アクセスログで「LohiSoftBot」を検索してみてください。
grep 'LohiSoftBot' access_log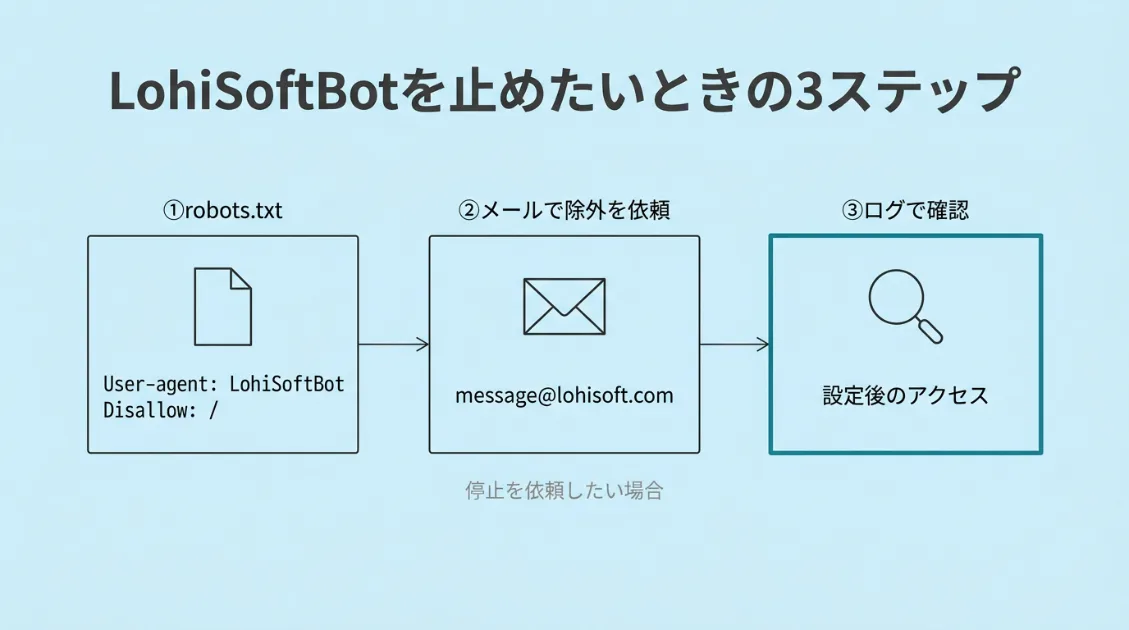
設定後のログにページへのアクセスがなければ、設定後の期間に取得が記録されていないことは確認できます。LohiSoftBotが再訪していない可能性もあるため、アクセスがないことだけでブロックが効いたとは断定できません。設定後もページへのアクセスが続く場合は、公式の連絡先に問い合わせてみてください。
まとめ:LohiSoftBotは今回のログでどう見えた?
LohiSoftBotは、スロバキアのソフトウェア会社LohiSoft s.r.o.が、自社の検索インデックスを作るために動かしているクローラーです。公式ページでは、AIの学習データは集めず、ページの本文も保存しないと説明しています。
今回の11件には、大量アクセスや管理画面を探るような不審な動きは見られませんでした。
AI観測ラボのブログで確認できたことと、確認できなかったことを整理すると次のとおりです。
今回のログで確認できたこと
- 2026年10月12日に、39秒間で11件のアクセスが記録され、正常に取得できたページは重複を除いて8ページだった
- 取得したのはトップページや用語集などの案内ページで、個別の記事ページや管理画面へのアクセスはなかった
- アクセス元のIPアドレスは公式ページの記載と一致し、逆引きと正引きでも公式の確認条件を満たした
今回の調査で確認できなかったこと
- 確認したログの範囲で、robots.txtを取得した記録は見つからなかった
- 集めた情報を使う検索サービスの名前や、利用できるページは見つからなかった
- 取得したデータを実際にどう処理し、何を保存しているかは、サイト側のログからは分からない
ログに「LohiSoftBot」の名前を見つけたら、まずはアクセス元のIPアドレスを確認し、逆引きと正引きで本物かどうかを確かめてみてください。ブロックしたい場合は、robots.txtへの記述とメールでの除外依頼の2つの方法があります。
AI観測ラボでは、今後もLohiSoftBotの再訪やrobots.txtの取得状況を観測し、新しい動きがあれば追記していきます。ほかのクローラーの正体や動きは、AIクローラー図鑑で確認できます。
自分のサイトにどんなボットが来ているか、確かめてみませんか?
AI観測ラボが開発したWordPressプラグイン「AI Kansoku Lab Tracker」を使うと、GPTBotやClaudeBotなどのAIクローラーが、いつ、どのページにアクセスしたかを記録できます。WordPressの管理画面から、ボットの訪問状況を手軽に確認できます。robots.txtへのアクセスなど、より細かい動きを調べたいときは、サーバーのアクセスログとあわせて確認してください。
あなたのサイトは、
AIに見えていますか?
URLを入力するだけで30秒。8項目を自動診断し、優先度別の改善プランを提示します。完全無料・登録不要。