NotebookLMはサイトを無断で取得する?Gemini Notebookのクローラーとrobots.txtの実態
サーバーログに「Google-NotebookLM」という見慣れないユーザーエージェント(UA)が残っていて、気になったことはありませんか?
Googleは2026年7月16日、AIリサーチツール「NotebookLM」を「Gemini Notebook」へ改名しました。公式ドキュメントでは、サイトへアクセスするときのUAも新しい「Google-GeminiNotebook」に変わり、旧UA「Google-NotebookLM」のサポートは2026年8月までと記載されています。
ところが、AI観測ラボのサーバーログでは、期限を過ぎた2026年10月にも旧UA「Google-NotebookLM」のアクセスが記録されていました。今回確認した2026年10月12〜19日のログでは、新UA「Google-GeminiNotebook」は記録されていません。
本記事では、10月と7月の実測ログをもとに、Gemini Notebookがサイトをどう取得しているのか、robots.txtで止められないのはなぜか、サイト運営者は何を確認すればいいのかを整理します。
この記事でわかること|📖:約6分
- 公式のサポート期限(2026年8月)を過ぎても、旧UA「Google-NotebookLM」が使われていた実測ログ
- Gemini Notebook(旧NotebookLM)がサイトを取得する仕組みと、Googlebotとの違い
- robots.txtで止められない理由と、取得を制限したいときの方法
- ログの確認で旧UAと新UAの両方を対象にすべき理由
旧UA「Google-NotebookLM」は8月で終わった?
結論からお伝えすると、AI観測ラボのログでは終わっていませんでした。2026年10月12日〜19日のサーバーログを確認したところ、Gemini Notebook由来とみられるアクセスはすべて旧UA「Google-NotebookLM」で、新UA「Google-GeminiNotebook」は記録されていません。
10月のログに残っていたアクセス
| 日時(日本時間) | 読まれたページ | HTTPリクエスト数 | 送信元IP |
|---|---|---|---|
| 2026年10月13日 23:18 | /seo-ai-gap/ | 9回(記事ページ2回+CSS・JavaScript 7回) | 66.249.84.106〜108 |
| 2026年10月17日 16:57 | /open-knowledge-format/ | 9回(記事ページ2回+CSS・JavaScript 7回) | 66.249.84.106〜108 |
表の「HTTPリクエスト数」は、サーバーに届いたファイル取得の回数です。9人が利用した、9回記事が読まれた、という意味ではありません。
2回とも動き方は同じでした。まず記事のページを2回取得し、最初の取得から3秒以内にCSSやJavaScriptのファイルをまとめて読み込んでいます。記事の文章だけでなく、ページの見た目を組み立てるファイルまで取得していることがわかります。
UAは「Google-NotebookLM」の1語だけ
サーバーのアクセスログ(生ログ)に記録されたUAは、加工や抽出をしていない状態で「Google-NotebookLM」の1語だけでした。ブラウザ名やURLは含まれていません。
一方、Googleの公式ドキュメントに載っている新UAは、次のような長い形式です。
Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/137.0.0.0 Safari/537.36 (compatible; Google-GeminiNotebook; +https://developers.google.com/crawling/docs/crawlers-fetchers/google-gemininotebook)名前が違うだけでなく、文字列の形もまったく異なります。「Google-GeminiNotebook」だけを条件にログを検索すると、実際に来ている旧UAのアクセスを見落とすことになります。
7月の記録とあわせて見ると
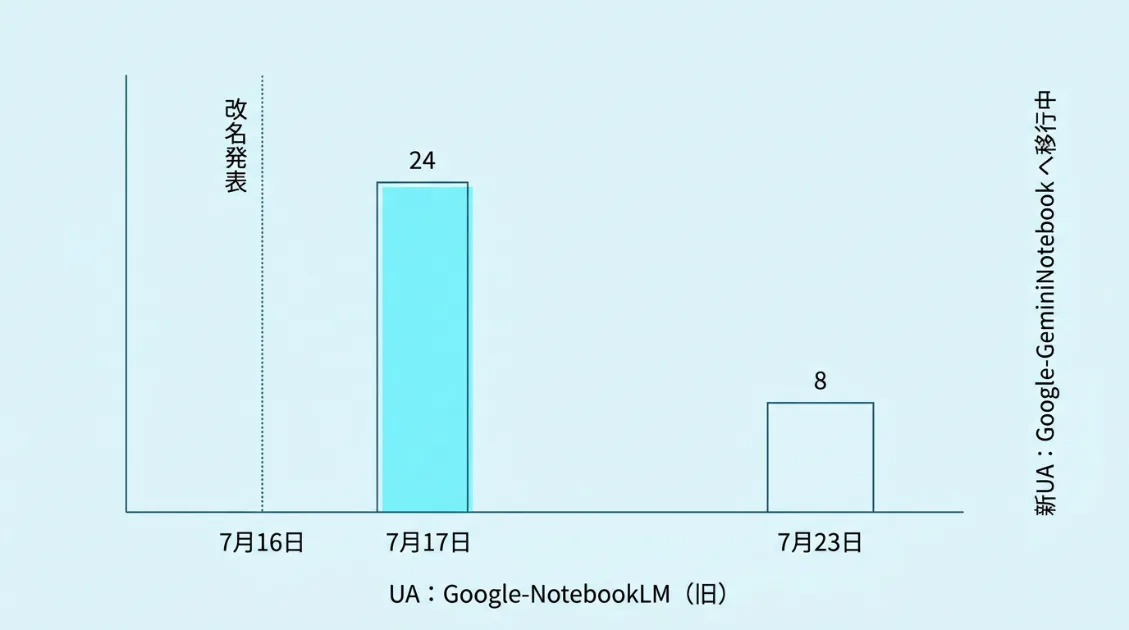
改名直後の7月にも、旧UAのアクセスを記録しています。
- 2026年7月17日(改名発表の翌日):24件
- 2026年7月23日:8件(午前9時時点の集計)
7月の件数はNeonDBに蓄積したデータの集計で、10月はサーバーの生ログから数えたHTTPリクエスト数です。数え方が異なるため、件数の増減は比べられません。比べられるのは「どちらの時期も旧UAで来ていた」という点です。
公式資料には「2026年8月までサポート」と記載されています。ただし、記載だけでは旧UAの使用終了日までは判断できません。AI観測ラボでは10月にも旧UAを記録しました。
「Google-NotebookLM」はどんなアクセス?
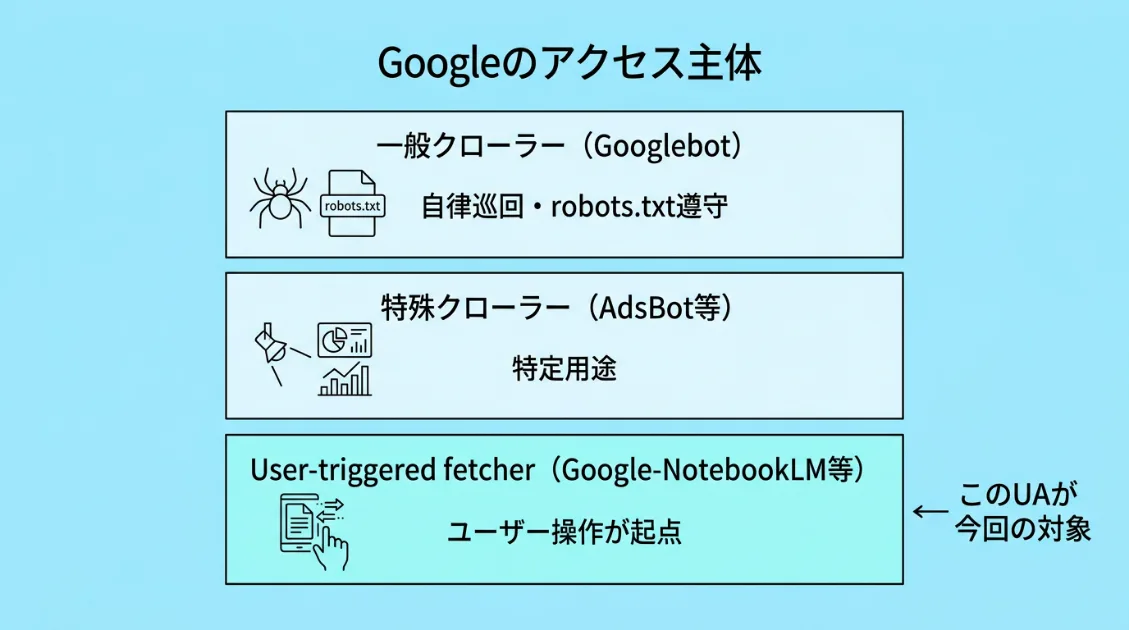
Googleはウェブへアクセスする仕組みを、大きく3つに分けています。
- 一般クローラー:検索インデックスを作るために、自動でサイトを巡回する(例:Googlebot)
- 特殊クローラー:広告審査など、特定の用途で動く
- User-triggered fetcher:Google製品の利用者が操作したときに、指定されたURLを取得する
「Google-NotebookLM」と後継の「Google-GeminiNotebook」は、3つ目のUser-triggered fetcherに分類されています。Googleの公式ドキュメントでは、利用者がノートブックのソースとして指定した個別のURLを取得する、と説明されています。
Googlebotのように、サイト内のリンクをたどって全ページを巡回するわけではありません。あくまで利用者の操作を起点とする取得です。ただし、1つのURLに対して取得が1回で終わるとは限りません。10月のログでも、記事ページを2回取得したうえで、CSSやJavaScriptも読み込んでいました。
改名そのものについては、Googleの公式ブログで発表されています。既存のノートブックや機能はそのまま引き継がれ、サービスが終了したわけではありません。
関連:GoogleOtherとは?Googleが持つ複数UAの役割と見分け方
robots.txtで止められないのはなぜ?
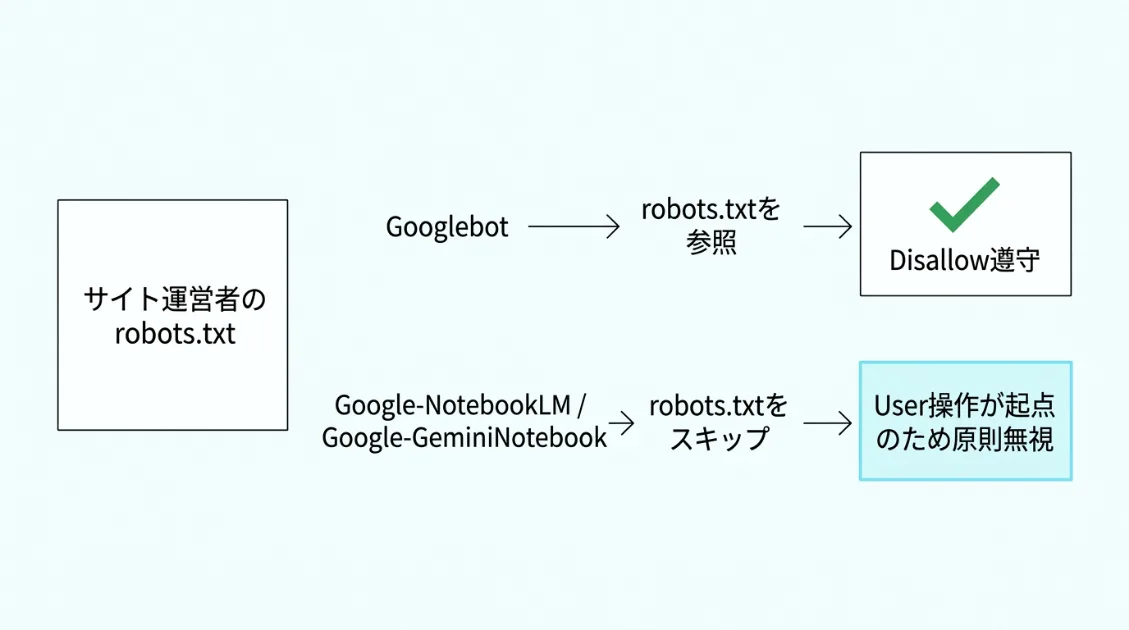
Googleの公式ドキュメントでは、User-triggered fetcherは利用者の依頼を代わりに実行するものなので、通常はrobots.txtのルールを適用しない、と説明されています。robots.txtでDisallowを書いても止まらないのは、不具合ではなく設計どおりの動きです。
| 名称 | Google上の位置づけ | robots.txtの扱い |
|---|---|---|
| Googlebot | 一般クローラー | ✅ 守る |
| Google-Extended | Geminiでの学習利用を制御するトークン ※HTTPのUAではない |
✅ 制御できる |
| Google-NotebookLM | 旧UA(User-triggered fetcher) | ❌ 通常は適用されない |
| Google-GeminiNotebook | 新UA(User-triggered fetcher) | ❌ 通常は適用されない |
関連:Meta-ExternalAgentとは?robots.txtでの制御方法と実測データ
サイト運営者は何をすればいい?
まず、旧UAと新UAの両方でログを確認する
公式の案内では旧UAのサポートは8月までですが、AI観測ラボでは2026年10月12〜19日のログにも旧UAが記録されていました。ログの確認やWAFのルールは、両方のUAを対象にしておくのが安全です。
# アクセスログから両UAのアクセスを抽出(.gzの過去ログも含む)
zgrep -hE "Google-NotebookLM|Google-GeminiNotebook" /var/log/nginx/access.log*

# データベースで集計する場合
WHERE user_agent LIKE '%Google-NotebookLM%'
OR user_agent LIKE '%Google-GeminiNotebook%'UAの文字列は誰でも名乗れます。本当にGoogleからのアクセスか確かめたい場合は、Googleが公開しているIP範囲や、逆引き・正引きDNSもあわせて確認してください。今回の10月のアクセスの送信元IP(66.249.84.106〜108)は、Googleが公開しているUser-triggered fetcherのIP範囲(66.249.84.96/27)に含まれていました。
止めるかどうかは、ページの公開範囲で決める
| コンテンツの状況 | おすすめの対応 |
|---|---|
| 一般公開しているブログ・解説記事 | まずは観測を続ける。問題がなければ許可 |
| 会員限定・有料記事 | robots.txtではなく、ログイン認証で保護する |
| 社内資料・未公開情報・個人情報 | 公開URLに置かず、認証した利用者だけが見られるようにする |
| 公開しているが、AIからの取得は避けたい | サーバー・WAF・CDN側で、UAとIPをもとに制限する |
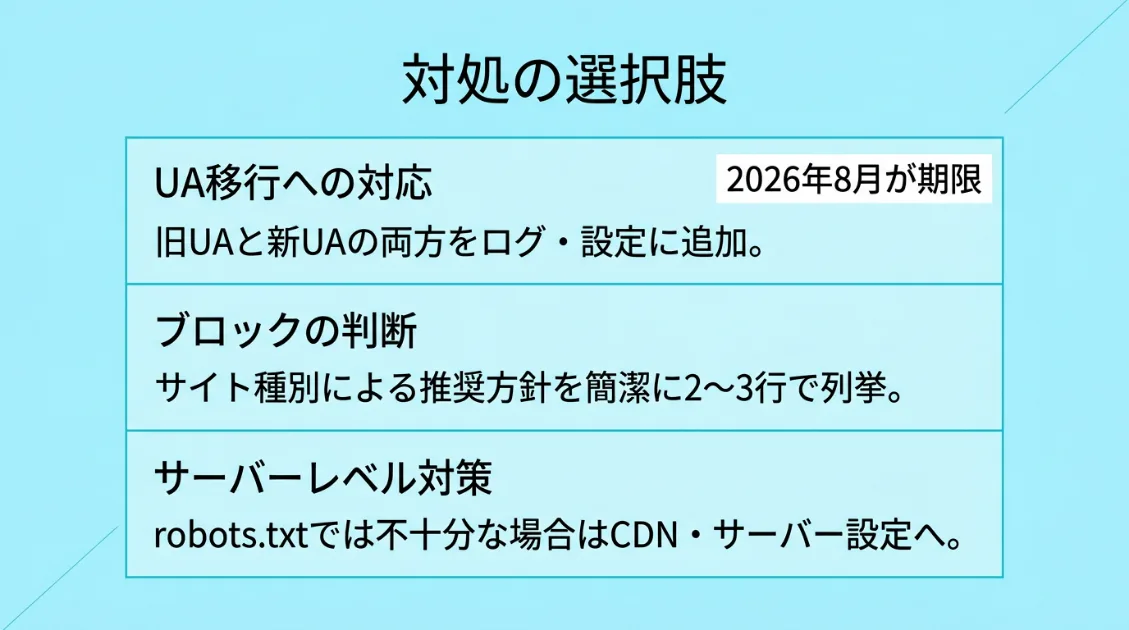
robots.txtはクローラーへの「お願い」を書くファイルで、アクセスを遮断する仕組みではありません。機密情報の保護には使わないでください。
一般公開しているブログであれば、数件のアクセスがあったという理由だけで、すぐにブロックする必要は高くありません。アクセス数・読まれたページ・時間帯・サーバー負荷を記録し、実害があるかを確かめてから判断するのが現実的です。
補足:「Fast Research」もサイトにアクセスする?
Gemini Notebookには、テーマを入力するとWeb上から関連する情報源を探して推薦する機能があります。2025年の発表時は「Discover Sources」、現在のヘルプでは「Fast Research」と案内されています。
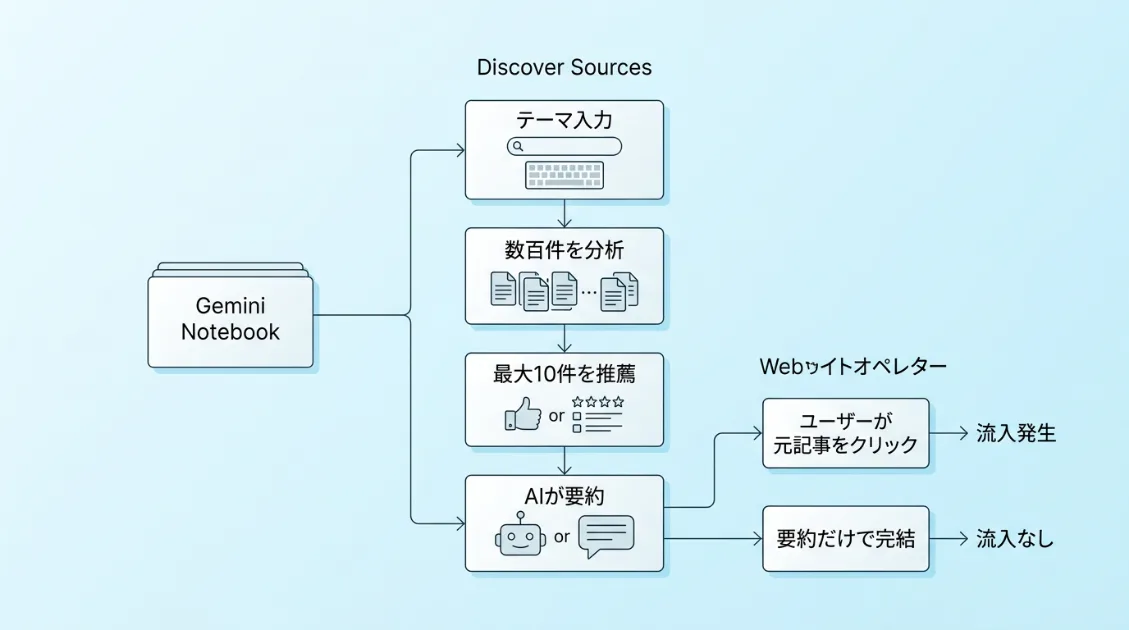
ただし、Fast Researchが候補を集めるときに「Google-NotebookLM」や「Google-GeminiNotebook」を使うという記載は、公式ドキュメントにありません。AI観測ラボで記録したアクセスがFast Researchによるものかどうかは、ログからは判断できません。
関連:ChatGPTに引用されるサイトの条件とは?実測データで検証
まとめ:期限後も旧UAは来ている。まずは両方で確認を
| 確認ポイント | 結論 |
|---|---|
| 旧UAはいつまで使われる? | 公式では旧UAのサポートは2026年8月までと記載。ただしAI観測ラボでは10月にも旧UAを記録 |
| 新UA「Google-GeminiNotebook」は来ている? | 今回確認した2026年10月12〜19日のログでは未観測 |
| サイト全体を巡回する? | しない。利用者がソースとして指定したURLを取得する |
| robots.txtで止められる? | 通常は適用されない。止めたい場合はサーバー側で制御 |
| 誰が何の操作をしたかわかる? | UAと時刻だけでは特定できない |
今回確認した2026年10月12〜19日のログでは、Gemini Notebook由来とみられるアクセスはすべて旧UA「Google-NotebookLM」でした。公式ドキュメントの記載だけでなく、実際のサーバーの記録もあわせて確認することが大切です。
ログの監視やWAFの設定をしているサイトは、「Google-NotebookLM」と「Google-GeminiNotebook」の両方を対象に入れておいてください。まだ確認していない場合は、一度アクセスログで両方のUAを検索してみることをおすすめします。
AI観測ラボでは、引き続き新UA「Google-GeminiNotebook」のアクセスを観測します。新UAを確認できた時点で、本記事に追記します。
参考資料(公式)
関連:AIエージェントのユーザーエージェントを見分けるには
関連:Google-NotebookLMのアクセスは何のサイン?ログを解釈する
あなたのサイトは、
AIに見えていますか?
URLを入力するだけで30秒。8項目を自動診断し、優先度別の改善プランを提示します。完全無料・登録不要。